个体能力强大的智能体,正一个接一个冒出来。
写代码,开发软件,检索文献,辅助科研,它们能独立完成的活越来越多。
这些 AI工具 一个一个拎出来,都是好手。
但这些超级个体变强之后,另一个同样重要的问题浮出来了。
它们能不能合作。
回看人类社会,很多复杂的成就,都靠一群人的分工和协作。
要组建一家公司,要造火箭,要登上月球,先要找的未必是一个无所不能的天才。
真正要安排的是怎么组织一支队伍。
需要哪些专业的人。
怎么分工。
怎么共享信息。
不同环节的工作,怎么接上。
从科学发现到大型工程,个体能力重要,组织和协作也决定了能走多远。
于是就有了那个问题。
当大模型和智能体的个体能力一直在涨,它们的协作能力跟上了没有。
面对一个共同的目标,它们会不会主动交换信息,协调分工。
多个智能体一起干活,能不能真正发挥各自的优势,让复杂的任务更容易完成。
带着这些问题,一个做开源智能体的团队,联合哥伦比亚大学,宾夕法尼亚大学,首尔大学,还有宾夕法尼亚州立大学,搭了一个评测的场地。
场地要回答的,是团队层面的问题。
当多个智能体各有角色,各有能力,各有资源,还要一起完成一件事,它们能不能形成有效的分工,保持信息同步,把各自的行动接起来,最后一起摸到目标。
这个场子补上了什么。
这些年,科研界已经在试着让多个大模型通过对话,分工,还有相互反馈,一起来解决问题。
也提出过一些面向协作的评测任务,还有游戏和社会模拟的环境。
但还有一个问题没答完。
当任务要跑几十轮,成员手里的资源不一样,而且每一步都可能影响队友,团队还能不能一直保持有效协作。
这个场地的特点,就是把长时程任务,角色不对称,还有黑盒交互,一起放进了同一个评测环境。
高层工具把导航,操作这些低层控制挡在外面,规则来判断共同目标有没有完成。
论文还提出一个指标,往回追溯哪些行动和消息,被判成对结果有贡献。
这样评测既能看见团队成没成,也能分析跨角色的交接和配合,是怎么把事推成的。
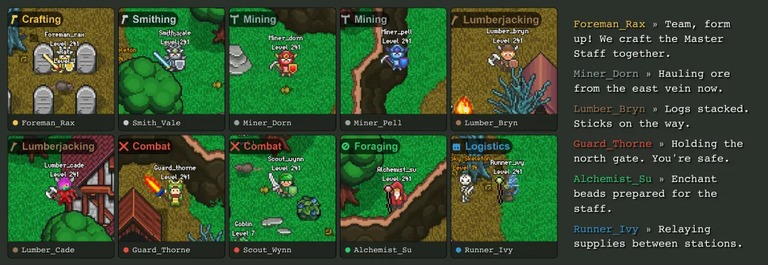
画面像一场角色扮演游戏。
十个智能体落进同一个世界。
世界里能采资源,能做物品,还要应付敌人。
每个智能体有自己的位置,也有自己的视角。
一个人动了,环境跟着变,别人下一步能做什么也跟着变。
任务里有个例子,是做一根魔法杖。
伐木工去砍木头。
木工把木头削成木棒。
法师拿着木棒,再加上自己手里的材料,把杖做出来。
看着只要各司其职就行。
真跑起来,麻烦全在每一次交接上。
木头该交给谁。
木棒做好了没有。
队友已经做完的那一步,要不要重做。
任务还没完,有没有人抢着喊收工。
论文报告里,四个主模型在主任务集上的最高成功率是百分之五十二。
这个数字本身,就是一个值得追下去的问题。
把会协作变成能量出来的能力
这些问题,正是多智能体协作系统要面对的考验。
多个智能体凑在一起,是一种结构。
多个智能体有效协作,是一种需要验证的能力。
如果只是让几个模型各答各的,再把答案汇总,还是很难知道,它们懂不懂彼此的职责,资源不够时会不会调整分工,能不能照着队友的进度改自己的计划。
这个场地把这些事放进了一个多人在线的角色扮演游戏。
里面有能采的资源,能做的物品,要打的敌人,还有分布在不同位置的队友。
智能体一动,环境就变,别人下一步能做什么也跟着变。
游戏给出了能跑,能看的协作场面。
评测盯的是,团队能不能把共同目标推到完成。
任务集由一百个人工设计的任务,加上一百个增强变体组成。
涵盖战斗,制作,采集,交易,探索,生存,建造,还有协调这些类型。
任务要三到二十个智能体参与,很多任务带着连续的资源交接,还有一环扣一环的行动依赖。
这样一设计,协作就从一段听着合理的对话,变成了一串必须真发生的动作。
为此,场地定了三个特点。
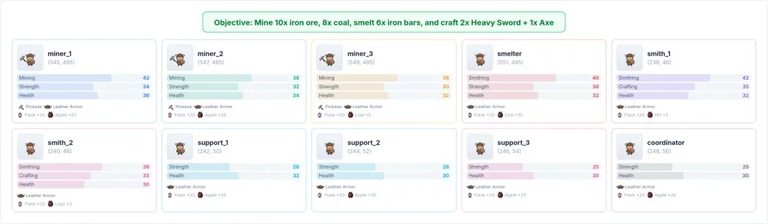
第一个是角色不对称。
不同智能体会的技能不一样,手里的初始条件也不一样。
队伍得照着这些差别安排工作,不能让所有人都去干同一套动作。
在魔法杖任务里,伐木,加工,制作,是一条前后咬合的链子。
谁先动,交给谁,什么时候交,都得有人拿主意。
第二个是黑盒交互。
一个智能体读不到队友脑子里的想法。
它只能看环境,靠 AI对话,靠行动的结果,去猜别人在干嘛。
我以为队友已经做完了。
这句话,本身就是一次次失败的开头。
第三个是多轮执行。
开局写好的计划,盖不住后面的变化。
资源到没到,队友要不要帮忙,原先的分工还合不合适。
这些都得边走边改。
主任务给了几十轮的预算,要求它们在一轮轮交接里保持默契。
为了不让低层操作添乱,场地还给了十三个现成的高层工具。
采集,攻击,这些动作被包成了一句调用。
模型就能把心思放在下一步做什么,还有跟谁配合上。
这并不等于把规划和工具的影响完全排掉。
但它让协作这件事,更容易被看清楚。
实验给的是同一套提示,同一套工具,同一套交互规则。
四款模型各带一队上场。
结果并不好看。
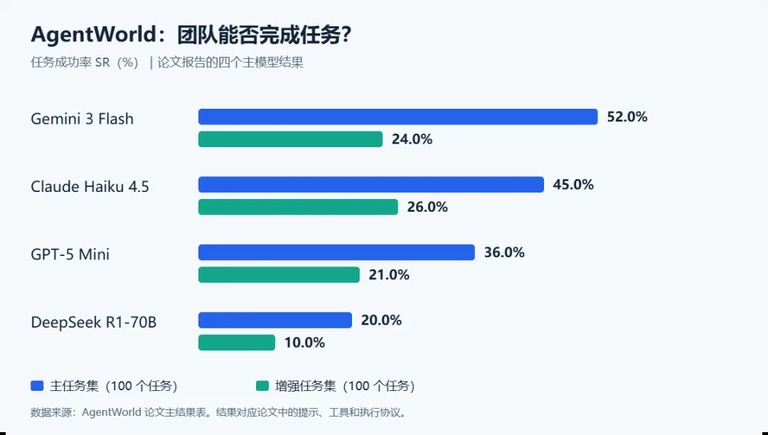
主任务集里,四队的成功率是百分之五十二,百分之四十五,百分之三十六,还有百分之二十。
换成加难的那一套,数字掉到百分之二十四,百分之二十六,百分之二十一,还有百分之十。
表现最好的那一队,也只做完了一半任务。
最好的一队,也只做完一半
还有一个更扎眼的差距。
做到一半,和真正做完,中间隔着很远。
最好那队在主任务里的部分成功率是百分之七十一点五。
可完整做完的,只有百分之五十二。
推进了一些中间目标,并不保证最后那一步交得出去,也做得出成品。
消息发得多,也未必更有用。
第三名那队平均每个任务发四十四条消息,成功率三成六。
最好那队平均只发十一条,成功率却有五成二。
这说明不了少说话就一定赢。
但它提醒我们,消息的数量,替不了协作的质量。
真正该看的是另一件事。
一条消息有没有带来新信息。
有没有把分工里的歧义说清楚。
收到消息的那一方,有没有照着去行动。
做完之后,还得看怎么做完
只看成功率,还不足以说清一支队伍是怎么干活的。
两个队伍都做完了任务,过程可能差得很远。
一队分工清楚,交接顺。
另一队反复采集,白等,还误解了消息。
只看最后的结果,这两队会拿到同一个标签。
于是论文又提出一个指标。
它从团队完成的目标往回倒推。
看看有多少动作,是真的推动了这件事。
名字叫因果协作有效性。
算法顺着因果链一路回溯。
这次制作靠哪些材料。
材料来自哪一次转交。
转交又靠谁的采集或者加工。
大模型帮着判断动作之间的依赖,一点点画出关系图。
算法本身不复杂。
用被认定有贡献的动作数,除以团队一共做过的动作数。
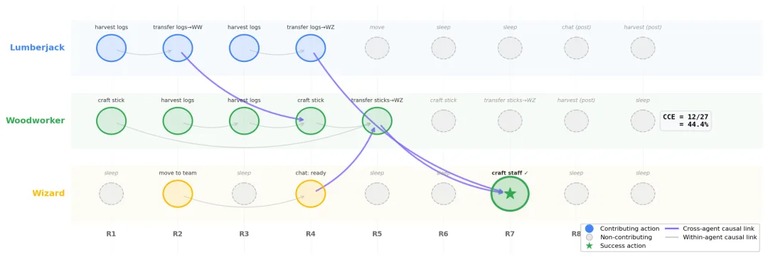
论文里有一条示意轨迹。
三个智能体一共做了二十七个动作,其中十二个进了通向成功的贡献链。
算出来大约是百分之四十四点四。
法师做出魔法杖,是直接完成目标的动作。
伐木工采集和转交木材,木工加工和交付木棒,靠后面的依赖间接促成了结果。
聊天也可能是贡献动作。
一条消息如果提供了后续依赖的信息,它就可能进这条链。
算不算,取决于具体轨迹和判断规则,而不是看它属于聊天还是工具调用。
失败的任务,这个值按定义记成零。
这是一种记分约定。
不代表失败的尝试全都没用。
必要的试探,信息不够时的碰运气,还有判断上的误差,都得算进去。
它还依赖模型的判断。
所以这个数字得跟成功率放在一起看。
不能把它当成一个单独的团队默契分。
把失败的轨迹翻一遍,还能看到几种反复出现的毛病。
问一个早就解决过的问题。
认错队友,或者把东西交错了人。
报出一条错的物品信息。
关键那一步还没做完,就宣布任务结束。
这些毛病说明,多智能体要维护的不只是一份任务计划。
还有一直在变的团队状态。
对做系统的人来说,这个场地是个可以反复试的地方。
把分工写清楚,能不能少点误解。
共享一份记忆,能不能帮队伍对齐进度。
集中安排和分散执行,各有什么好处。
换一套沟通方式,是提高了完成率,还是只多发了消息。
这些问题,都该用对照实验来回答。
一个评测基准的价值,就在这儿。
改进了方法,可以在同一批任务,同一套规则,还有可复查的记录上,比出高下。
从各自能干,到共同做完
这轮实验,还不足以下一个总判断。
它说的是一批特定模型,在特定提示,特定接口和协议下的表现。
更丰富的规划,记忆,还有沟通设计,都还有空间。
但它把一个模糊的问题摆到了台面上。
衡量一支智能体队伍,既要看成员各自能做什么。
也要看它们在互相依赖的时候,能不能一起把事做完。
AI编程 里早就有了这种苗头。
一个主力拆任务,几个帮手分头接活。
只不过这一次,研究者把它搬进了一场统一的考试。
多智能体走进越来越复杂的工作流之后。
对它们的考察,也该从聊得像不像,走到做得成不成。
这个场地给了一个能跑,能比,还能复查的答案。