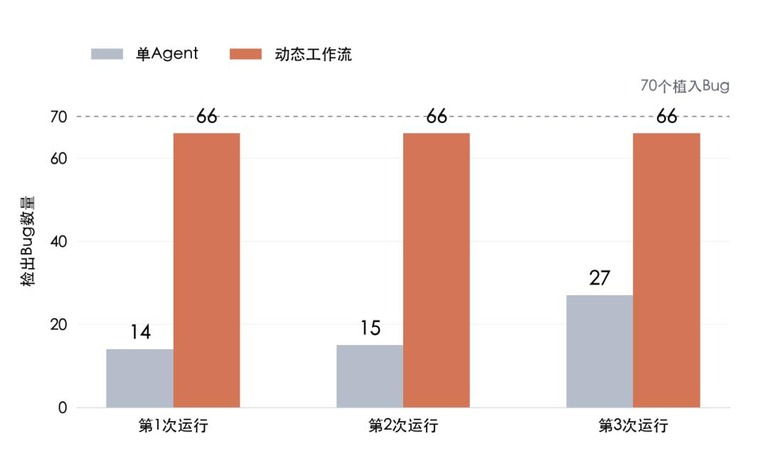
单个智能体自己上,最好的一次找出 27 个缺陷。
换成 Claude 自己组队,连跑三次,每次都查出 66 个。
这是官方刚公布的一组测试结果。
11.6 万行代码里事先埋了 70 个缺陷,让单干和动态工作流各跑三次。
结果,单打独斗最好也没到四成。
组队协作,三次都超过九成。
这组数据的背后,是它开始自己安排分工。
十月十日,托管智能体的动态工作流开启公测。
主智能体接到任务后,先自己写一段分工程序。
再安排别的智能体分阶段干活,最后把结果汇总起来。
同一天,编程工具里那个项目功能也扩大了公测范围。
此前排队等名额的付费用户,现在都拿到了资格。
你提目标,它自己分活
在项目功能里,你可以围着一个项目持续提需求。
Claude 负责拆任务,协调多条线程并行推进。
一个让开发者把多智能体协作接进自己的应用。
一个让用户在项目对话里直接交代工作,跟进进展。
两项更新指向同一件事。
分活,盯进度,交接结果。
这些原本要人操心的事,它开始接手。
你提目标。
它自己分活。
同时开几个 AI对话 窗口并不难。
难的是给每个窗口重讲一遍背景。
把一边的发现送到另一边,再挨个追问做到哪了。
窗口越多,人越像传话员。
项目功能想接下的,就是这一段。
你在同一个项目对话里持续提需求。
它判断该新开一条线程,还是交给已经在处理相关工作的线程。
每条线程,可以理解为一段独立推进任务的工作对话。
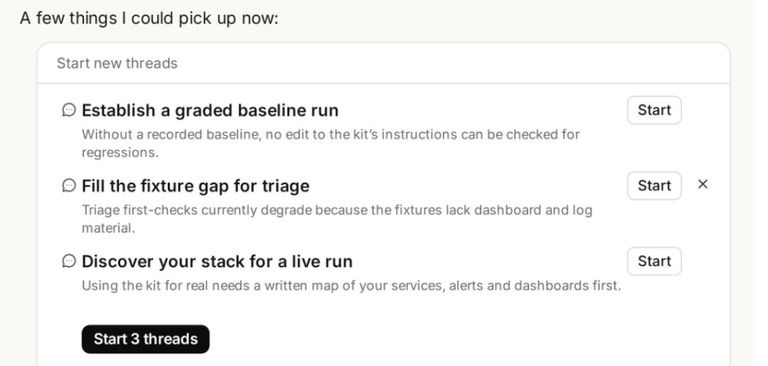
官方举过一个例子。
让接口,网页端和移动端一起停用旧接口。
这件事牵涉多个代码仓库,各处改动还得互相配合。
它按仓库拆任务,分别修改,跑测试,提交合并请求。
再告诉你哪些改动需要先合并。
每条云端线程有自己的上下文和代码副本。
在自己的分支上干活,做完再把结果报回项目对话。
你仍能进某条线程看细节,纠正方向。
项目总览把正在工作,等你回答,可以审查的任务分开列出。
离开一会儿再回来,也不用挨个窗口问进度。
想省下反复沟通的时间,交代过的事就得记得住。
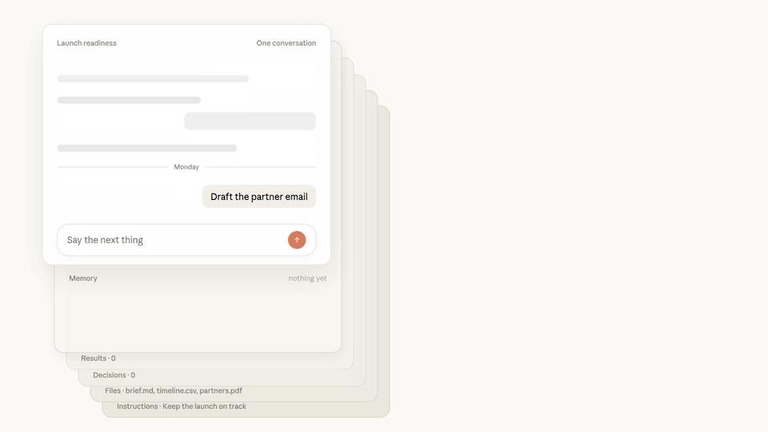
项目功能会积累项目记忆。
需求改了什么,做过哪些决定,哪里踩过坑,都记得下来。
这些记录供后续的云端线程读取。
官方举了个日常场景。
发布日期改到了周五,某个功能为什么被砍掉。
改某个服务前,得先找谁确认。
这些都能留在项目记忆里。
资料库还会保存你上传的资料和它生成的文件。
让后续任务接着已有的成果往下做。
新版项目功能,其实在九月十七日就开始分批公测。
这次扩大的是准入范围,功能本身仍在公测阶段。
合上电脑,云端线程也能继续干活。
需要用到本机工具或者本地数据库的任务,可以走远程控制在电脑上跑。
但电脑得保持唤醒。
项目有人协调之后,一项复杂任务内部又该怎么分工。
三百份合同,把分工写成程序
托管智能体的动态工作流,处理的就是这类问题。
官方给了一个具体的任务例子。
检查三百份合同,找出哪些带控制权变更条款。
也就是公司控制权发生变化时,合同该怎么处理。
逐份读懂已经很费工夫。
还得保证每份都查过,结论有据可查,漏掉的能补查。
Claude 会为任务写出一段工作流程序。
安排哪些智能体读材料,哪些步骤处理结果。
后续又该怎么继续,也一并写进去。
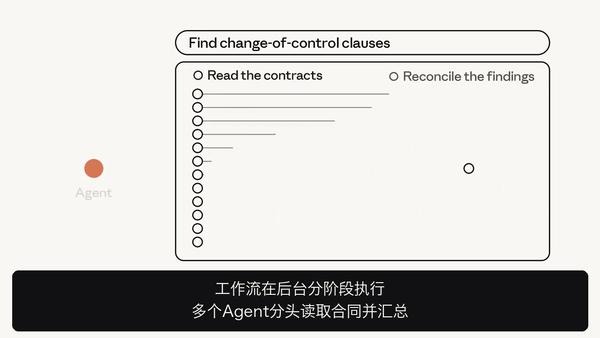
分工写进程序。
直接运行。
一个智能体读完材料,把结果交给程序。
程序再把结果传给后面的智能体。
或者据此决定,下一步走哪个分支。
需要反复修改的活,也能把循环安排进去。
文档里举的例子是稿件审校。
持续修改,直到审核通过,或者到了预设轮数。
普通的子智能体委派里,主智能体要读汇报,再决定下一步。
动态工作流把大量中间交接写进程序,在后台推进。
等待的这段时间,主智能体仍可以和你交流,查看进度。
跑完再读结果,答复你,或者发起下一轮。
不过线程交回结果后,主智能体没法继续向同一线程追问。
核对和返工,最好提前安排进流程。
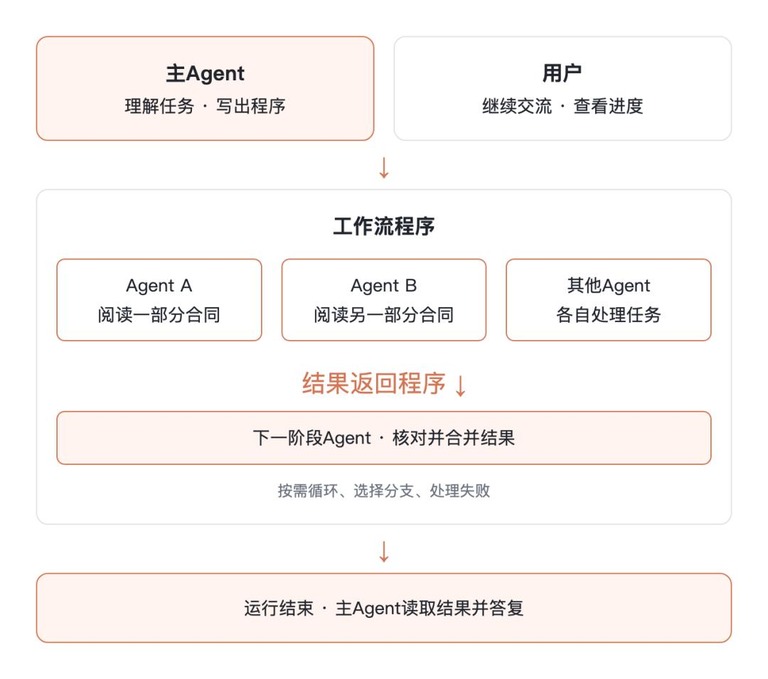
官方的合同审查样例就规定了两轮。
第一轮,每份合同交给一个智能体。
第二轮,由另一个智能体重查全部合同。
首轮没发现目标条款的,也不能跳过。
复核没通过的,返工后再复核一次。
这给首轮漏掉的条款,多留了一次被发现的机会。
当然,合同案例展示的是工作方式。
官方并没有在缺陷测试那组帖子里披露具体分工。
不能据此认定,这 66 个缺陷也是同一套流程找出来的。
一千个智能体,也要排好队
单次最多一千个,是这次公测最抢眼的数字之一。
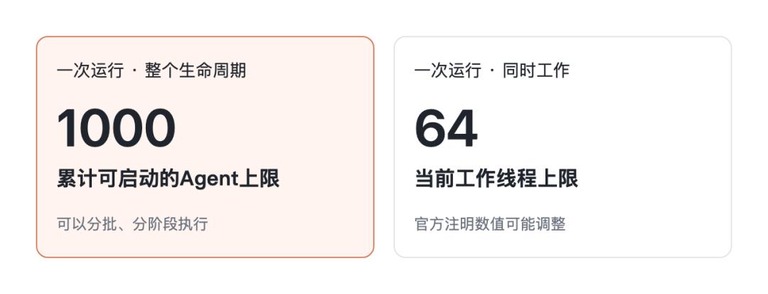
它指的是,一次工作流在整个运行期间累计最多启动一千个智能体。
当前文档列出的同时工作线程上限,是六十四条。
官方也说明,这个并发数可能会调整。
工作流可以一批接一批地执行。
也可以等前一阶段交回结果,再安排后一阶段。
每个智能体有独立的对话历史,同时共享会话里的文件和沙箱。
沙箱就是运行代码,处理材料的工作环境。
开发者可以提前配好专门的智能体。
也可以让工作流根据任务需要临时定义。
接入时,在配置里把类型设成指定的那一项。
再配好模型,工具和任务要求。
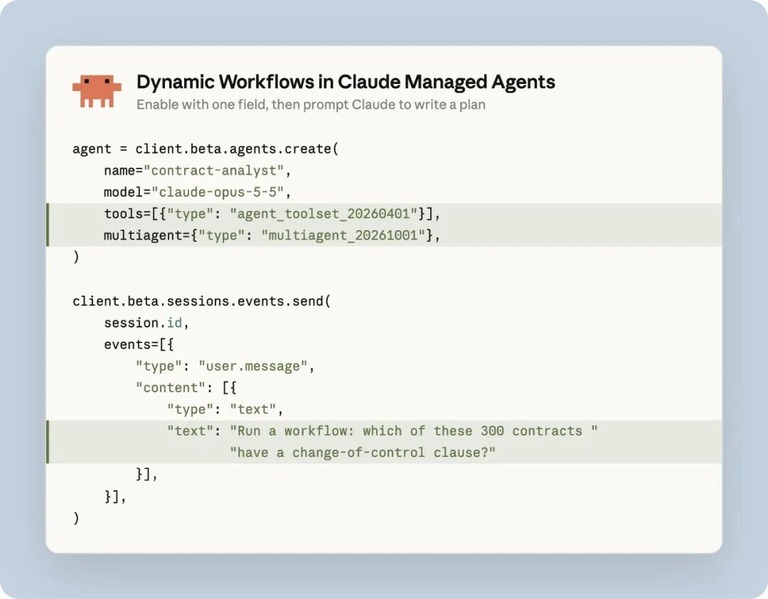
启用动态工作流以后,向它交代任务,就能让它写出分工计划。
不过会分工还不够,还得把没做完的地方交代清楚。
官方的一条指令样例要求,某个智能体读不了合同,就把这份列为未覆盖。
其余任务继续往下走。
没查出问题。
根本没查到。
这两件事必须分开。
否则一份整齐的汇总,很容易把任务缺口藏起来。
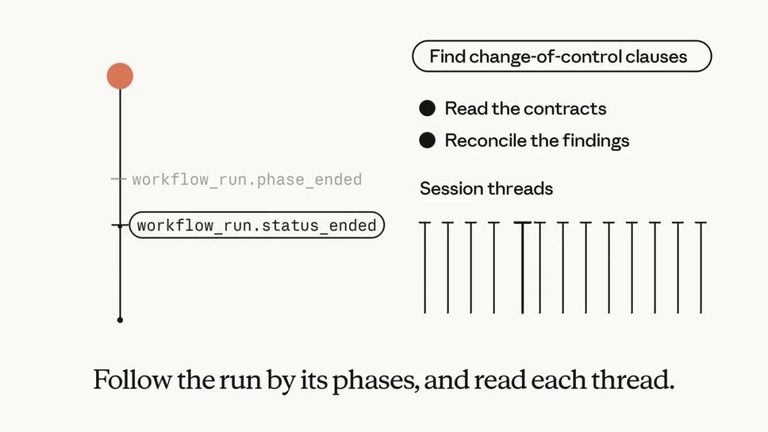
开发者能查看运行阶段和各条线程的记录。
沿着记录,就能定位问题出在哪。
这里还要区分一下。
最多一千个,三次都是 66 个,说的都是动态工作流。
这些数字不是项目功能的。
回到开头那组测试。
单干三次找出的缺陷数量,是 14,15,还有 27。
动态工作流三次都是 66。
找出的缺陷更多了,但为此多花了多少时间和费用,还不清楚。
官方没有披露所用模型,实际智能体数量,耗时和用量。
误报的情况也没说。
所以暂时还判断不了,这套工作流到底是不是更快,更划算。
省下协调时间,账单还在跑
实际用起来,两项功能的费用也要分开看。
项目功能用的是现有套餐额度。
工作线程和协调对话都会吃掉用量。
并行任务越多,额度用得越快。
你可以调整模型和推理强度,或者让它少开几条线程。
通常额度到顶后线程会暂停,等重置了再继续。
动态工作流则按模型用量计费。
另外,每个会话每小时加收零点零八美元的运行费。
只算会话处于运行状态的那部分时间。
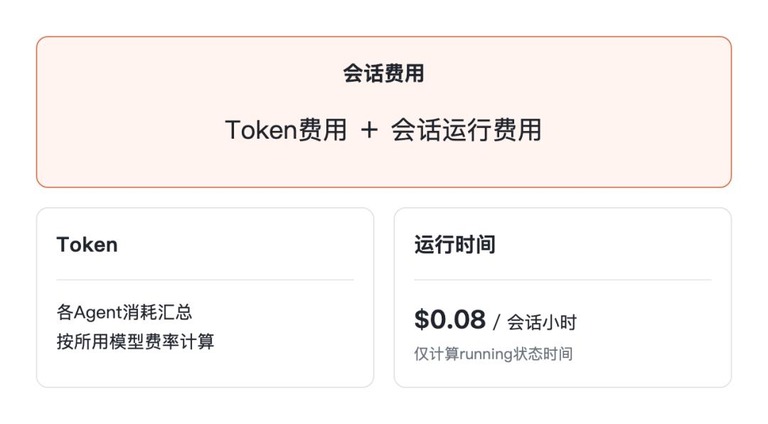
这零点零八美元只是运行费。
多智能体读材料,生成答案消耗的用量,还要另算。
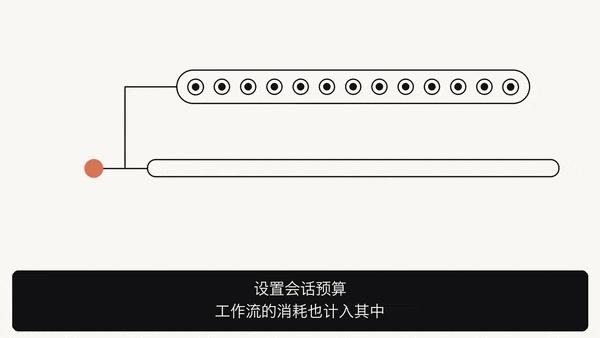
开发者可以设置会话预算,工作流的模型消耗也一并计入。
到了预算之后运行暂停。
但已经发出去的模型请求仍会完成,最终费用可能超出预算。
所以官方建议,先从范围明确的任务开始。
摸清消耗,再慢慢加复杂度。
智能体多了,并不自动等于更划算。
多找出多少真问题。
多花了多少调用费用。
又要人花多少时间复核和修错。
这些都得算进同一笔账。
少花时间分活,如果换来更多收尾工作,项目未必更快结束。
把这两项更新放在一起看,意图就很清楚了。
你交代目标,它组织背景,把任务派出去。
分活,盯进度,交接结果,一路都有人接着。
它想占住的,是你刚有一个目标,还没决定从哪下手的那一刻。
在不同 AI工具 之间来回切换,找背景,分任务,接反馈,原本都得人自己跑。
真正动手改代码的那一段,也就是 AI编程,原本也得人在几个界面之间来回交代。
把这两件事交给一个会自己安排的工具,正好补上了这一段。
如果这条链路能稳定跑通,从交代目标到检查结果,人就能少些来回切换。
那一天的开工第一步,也许就剩一句话。
Claude Code会员中转站 微信:douhanq