

2026年9月23日,爱诗科技正式发布 PixVerse R2。官方把它称作全球首个具备规模化扩展能力的通用实时世界模型。游戏、互动影游和数字人三个场景的体验间已经同时对外开放。
它不只是一个更大的AI工具。
过去做AI视频,行业默认一条规矩。要实时,模型就得够小够快。要通用,模型又得够大够见多识广。两者很难同时满足。
这是老问题。
爱诗的说法是,这条路本身有问题。
实时和通用,第一次不用二选一
ChatGPT 用规模定律证明了一件事。模型越大,能力越强。此后整个行业都在追问同一个问题。这条定律是否只属于文字。
主流答案曾经是否定的。语言是离散符号,适合规模定律。视频是连续的高维信号,天生难扩展。Sora 的出现打破了这个偏见。
实时世界模型仍卡在原地。
两边都要。
难题有两个方向。要实时,模型必须小到能在一块显卡上跑出流畅帧率。要通用,模型又必须大到能理解各种复杂场景和物理规律。旧的技术路径只能在两者之间取一个。
爱诗科技认为,真正可扩展的通用实时世界模型不该一直做这种选择。该做的,是把能力和速度解耦。架构设计对了,文字和参考,还有声音与操作这些信号就能被统一理解。实时世界模型同样可以越大越强。
PixVerse R2 就是这套判断的验证。
以往谈规模化扩展,多半只意味着参数量变大。在它这里,扩展发生在五个维度上。模型,数据,任务,控制信号,时间尺度,五个方向都能继续投入。
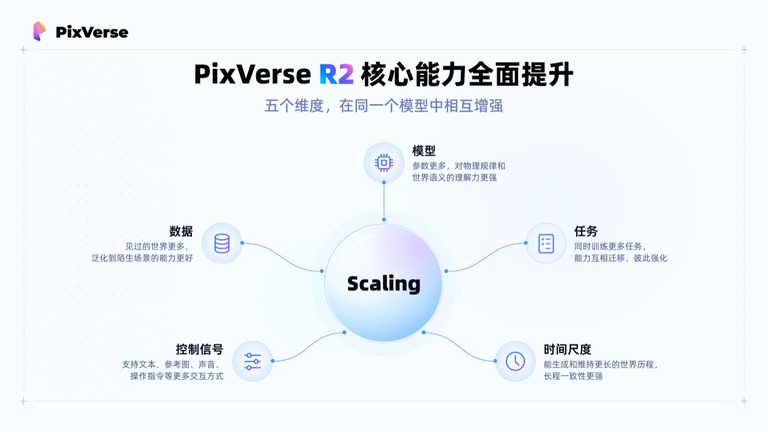
这五个维度不是各干各的。
它们互相咬合。
它们跑在同一个模型里,彼此增强,最后合成三种能力。生成质量更高,画面更精细,运动更自然,音视频同步更准。长程一致性更强,角色不崩,场景不跳,物体不会凭空消失。多模态控制更强,文字,参考图,声音和键盘操作都能被稳定听懂。
所以它不只是一个更大的模型,而是一套能持续扩展的世界模型系统。
「言出法随」是这次最大的变化
用户体验层面,这次变化可以压成四个字。言出法随。
往细了说有三层。虚拟世界有记忆地活着。它能听懂各种语言。它对用户的每个动作都给出符合因果关系的反应。
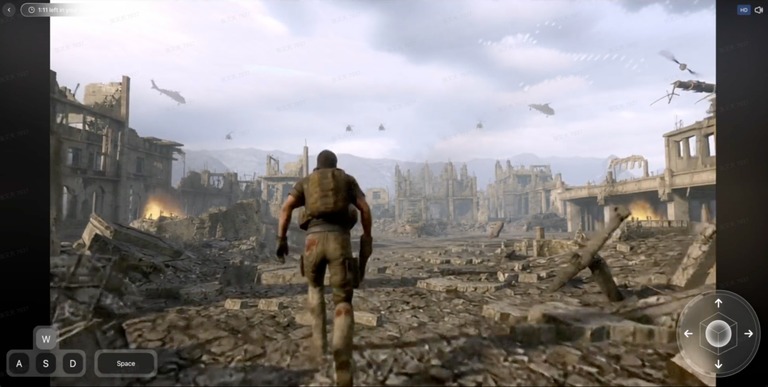
一个能走进去的世界,可以用文字生成,也可以用图像生成。进去以后,用户能像玩游戏那样用 WASD 控制角色移动、跳跃和探索,视角随时可换。用户还能直接下指令。换角色,加东西,改环境,想到什么就能马上看到。
角色、物体和环境之间会持续产生互动。遮挡、接触和碰撞都符合空间关系与物理逻辑。
原始演示里有两次连续指令。视频 25 秒处,用户对角色输入 Grow Wings and Fly,角色随即生出翅膀悬空飞行。接着再输入 Burst into Flames。角色周身冒起火光,很快降了下来。落地那一刻,火光照亮并引燃了周边草地。
整个过程没有明显的拼接感。

最后一块是实时数字人。互动影游《畸变回声》里,超级创作者 JadeWu 用它搭了实时数字人,负责推动剧情。

玩家能和关键角色 Eve 实时交流。线索靠问出来,谜团也靠问解开。Eve 会根据提问和剧情进展给出不同回应。她还能把实时表演,语音,人设,记忆和关系状态统一起来。多轮交流下来,身份始终一致,不会出戏。
和AI对话的体验,就这样被搬进了剧情里。
这就不是只会念台词的 NPC 了。她记得你,也认识你。
用两个引擎替掉五层接力
旧思路是为了实时,不得不降质量。训练要经过五层接力,每一次接力都会折损画质、动作表现和指令理解能力。模型,数据和任务的规模越往上堆,流程就越容易散架,训练成本也跟着涨。
越堆越重。
爱诗科技把整条训练框架收敛成两个引擎。
一个是能力引擎,叫全模态因果自回归,简称 Omni Causal AR。它像大脑,负责吸收更多数据、更多任务和更长的时间跨度,把世界模型的理解力与表现力练到最强。
另一个是加速引擎,叫实时加速。它负责把已经练到最强的能力,尽量无损地压进严格的实时延迟约束里。

分工很清楚。先探索能力上限,再把这个上限变成人人都能实时打开的产品。
背后有两个设计哲学。第一个是分层解耦。它把能力和效率变成两个各自独立、可以分别持续优化的阶段。这需要更大的耐心。换来的是基础模型每变强一次,能力就能沿同一条流水线稳定传到实时产品上,不必推倒重来。
第二个是因果内化。模型不是盲目地逐帧硬猜下一帧,而是先理解一整段时空的结构,再沿时间方向单向展开。生成结果因此更确定可控,也不必完全靠数据堆够了自然开窍。
工程细节也做了不少针对性设计。能力这一侧,动态分块让文字,图像,语音和操作这些节奏不同的信号被统一处理。多时间尺度记忆让模型同时记得世界长什么样和刚刚发生了什么。误差库专门收集模型自己跑偏的状态,反复训练纠错。实测长期画面漂移下降了约 35.8%。
加速那一侧,教师和学生模型共用同一套因果基础,把重新学习变成提速。块稀疏注意力把计算集中在关键关联上,稀疏度超过 90% 仍几乎不损效果。金字塔式分阶段生成先定结构、再补细节,用更少的算力逼近离线顶级模型的效果。
坐标系正在重排
爱诗科技成立于 2023 年。公司早于 Sora 推出首个自研视频大模型,此后的 V 系列和 C 系列快速迭代。这次先走通实时世界模型的规模化扩展,又一次印证了它的非共识打法。
它的底座来自亿级用户的真实使用。模型不只在实验室里训练完成,而是在长期真实使用和反馈中打磨。这让后续扩展有一个贴近真实场景的起点。
背后是两种能力。一种是顶级生成算法。另一种是大规模实时系统工程。后者恰恰是纯研究团队普遍稀缺的部分。这一块最难补。创始人王长虎此前在短视频领域长期负责大规模实时系统的建设与运维,这套经验被迁进了世界模型的训练与推理架构。

把生成式 AI 放进更大的技术坐标系,实时世界模型正处在几个方向的交叉位。传统视频生成的内容质量高,但要等。数字人和实时交互系统响应快,可生成的世界受预设内容和交互框架限制。传统游戏引擎能实时运行复杂世界,但世界主要靠人工构建。
它想连接这些能力。既需要生成模型对世界的理解与生成能力,也需要实时系统对延迟、算力和长期运行的控制能力。核心价值不是占住某个坐标,而是改变坐标之间的关系。
爱诗科技也承认局限。在严格的实时计算和交互延迟约束下,它的单次生成质量与前沿离线视频生成模型相比仍有提升空间。不过底层架构已经过验证,具备持续迭代的基础。
接下来的投入会落在五个方向。模型,数据,任务,控制信号,时间尺度。
王长虎把演进分成三个阶段。现在是创作工具。之后是可随时进入、随时互动的生成式环境。最终是下一代生成式世界模型的底座与基础设施。他还补了一句判断。实时互动视频生成不是世界模型的全部,但它是世界模型最早能被大众感知、最接近产品化的一条路线。
PixVerse R2 已经开放使用。
