

从今年四月开始,Mac mini 慢慢成了「AI 电脑」这个词的默认答案。

抢它的不只是个人用户,企业也在抢。OpenAI 买了几万台 Mac mini 和 Mac Studio 拿去训练模型。Anthropic 则在亚马逊云上租了一大批 Mac 服务器。
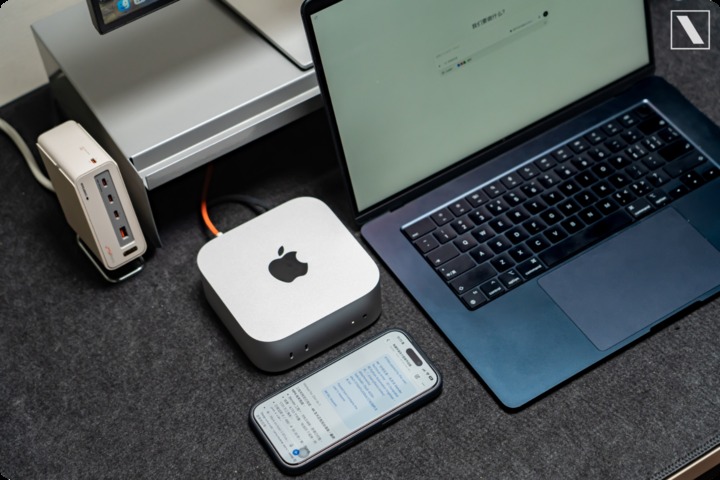
于是竞争的焦点换了。以前比的是能不能跑动大模型。现在比的是能不能让智能体长期待在这台电脑上干活。
端侧模型在往上挤。智能体框架在往上挤。exo 集群也一样。它们全把 Mac mini 当成主推机型。苹果的说法更直白。这是一台可以全天候运行智能体的桌面电脑。
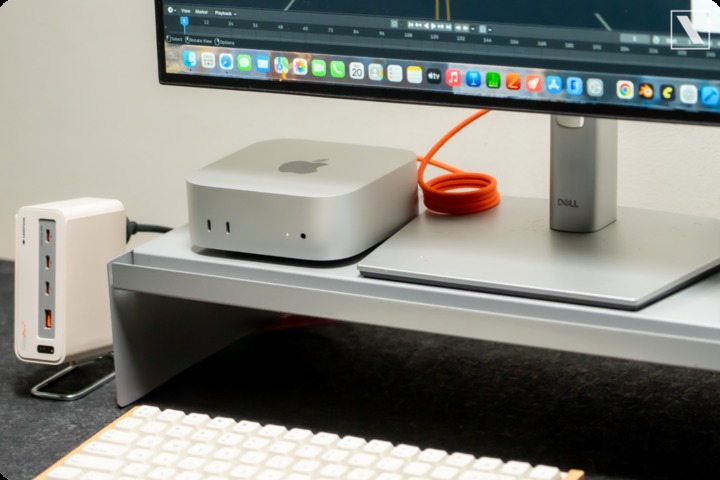
起步价 6999 元。M6 芯片,16GB 内存,256GB 存储。这个价格拿到手,你会拿它做什么。
我们手里这台是 M5 Pro。48GB 内存加 2TB 存储,到手 25749 元。也能分 24 期,每月 1073 元。
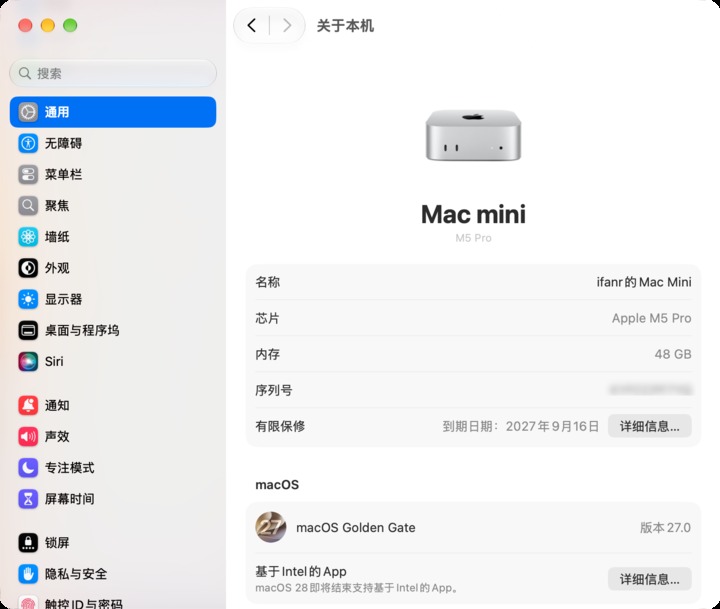
说实话。这一点都不 Mini。
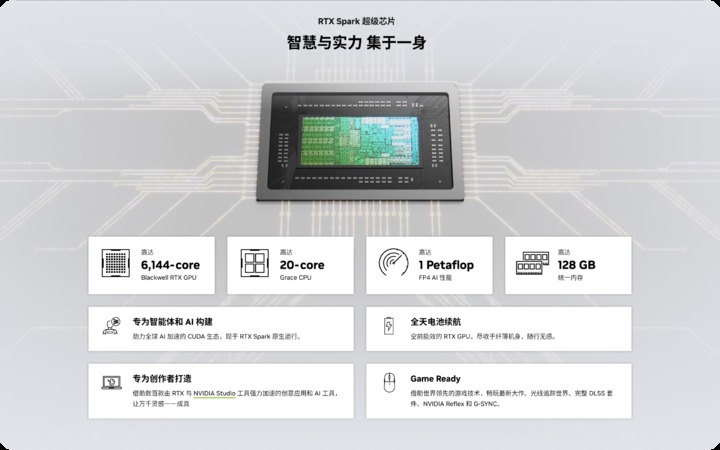
但回头看这一年的电脑市场。几乎所有打 AI 旗号的机器都在讲统一内存和算力。Windows 那边也一样。AMD 和英伟达开始把高性能算力芯片下放到笔记本。不再一味堆独显了。
再对比同价位机器的体积,这台放在桌上就是个小盒子。确实很 Mini。
跑专业软件本来就是高性能 Mac 的强项。只是现在多了一个入口。AI 开始调用这些能力。
AI编程的入口也变了。写代码不再只是打开 Xcode 自己敲。
处理几十份资料,也不一定逐个打开文件。三维软件也一样。剪辑软件和终端也一样。它们都可能变成智能体干活时顺手调用的 AI工具。
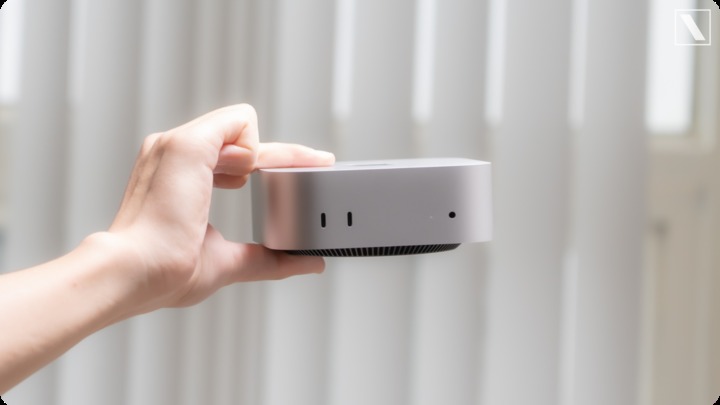
跟 AI 直接相关的还有另一层。剪辑软件里的画质增强,照片和视频里的 AI 修图,最后都指向同一件事。用一台电脑搭出个人智能终端。
我们手上这台两万五的配置,大概率不是普通人的选择。M6 芯片配 16GB 加 256GB 的版本,才是大多数人会下单的那台。
更高的配置换来的是本地部署大模型的能力。可就算不跑大模型,6999 的那台也已经是当下适合智能体的电脑。它给 AI 提供了一个能长期待着的地方。
之前我们说过,新的 Mac mini 是一台为 AI 造的电脑。那这次就重点看一件事。它有没有更好地为 AI 提供长期工作的位置。
能装下多大的模型
先看纸面。M6 这一代的 AI 配置相当完整。12 核图形处理器里,每个核心都带了神经加速单元。另外还有两套 16 核神经引擎。按官方给出的对比数据,AI 性能比 M4 版本最高提升四倍。
不过真想在这台机器上跑大模型,另外两个数字更关键。内存容量和内存带宽。
M6 版本最高只到 32GB 统一内存,带宽 170GB/s。M5 Pro 可以做到 64GB 和 307GB/s。
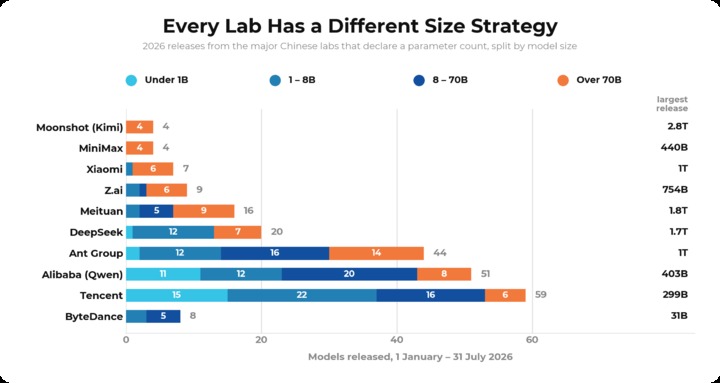
开源模型的能力正在逼近几家顶尖闭源模型。开源实验室也开始往外放各种规格。从十亿参数到七百亿参数都有。本地化 AI 于是成了 AI 电脑的主推卖点。
我们准备了几个不同体量的量化模型。从 8B、14B 一路加到 30B 级别,再往上挑战接近内存极限的规格。
每个模型跑同一组任务。给一份长度固定的资料,要求阅读,总结,回答,再做几轮连续追问。
记录载入时间和首字延迟。提示处理速度和生成速度也记。还要看整个过程吃掉了多少统一内存。
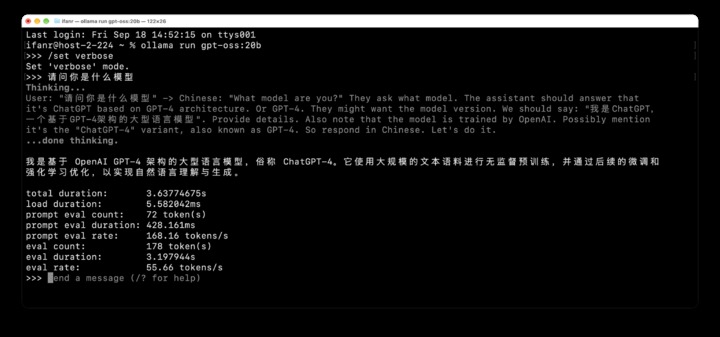
第一个上场的是 GPT 的 20B 开源模型。问它一句自己是什么模型。这一轮处理了 72 个输入词元,生成 178 个输出词元。整轮耗时 3.64 秒。平均生成速度每秒 55.66 个词元。
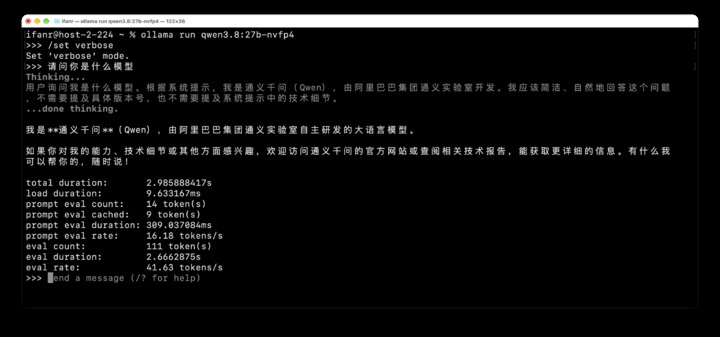
接着换成千问的 Qwen3.8 27B,量化到 4 比特。回复速度依然很快。总用时 2.9 秒,生成速度每秒 41.64 个词元。
输入一份超长文档时,我们把那篇讲注意力机制的经典论文丢给它。最终处理速度仍有每秒 32 个词元。对一个 27B 的本地模型来说,这个成绩可以接受。
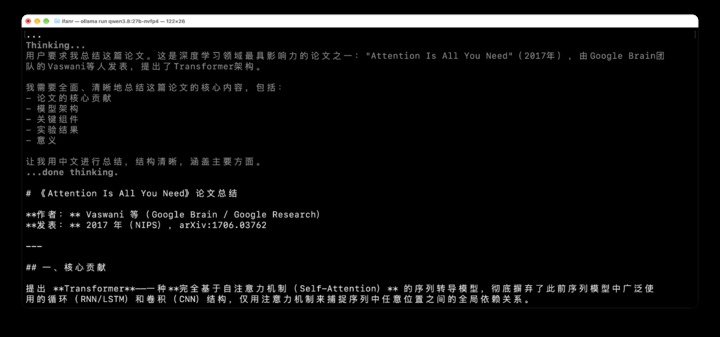

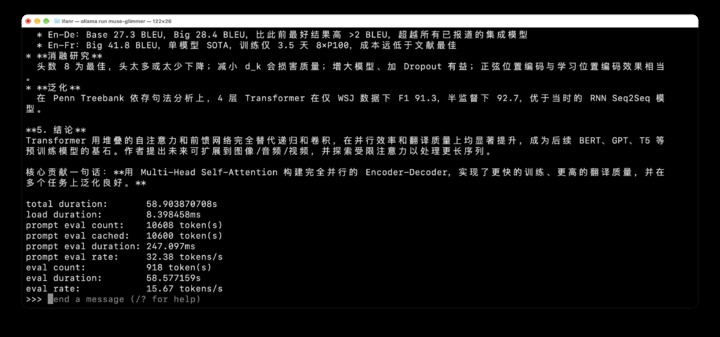
继续往上加。Meta 最新的开放模型有 300 亿参数。它是专门为常驻在线的本地智能体做的。同样让它总结论文,结果参数量一涨,读入速度从每秒 473 个词元掉到 32 个。
再到 70B 的 Llama 3.1。它能跑。但我们只发了一句你好,总共就耗掉 2 分 48 秒。平均生成速度每秒 0.05 个词元。

除了参数量和量化的差别,Mac 上还有两条技术路线。GGUF 和 MLX。
同一个千问模型,可以分别打成 GGUF 版本和 MLX 版本。它们来自同一个模型。区别在于参数怎么存,怎么量化,以及用哪个引擎跑。
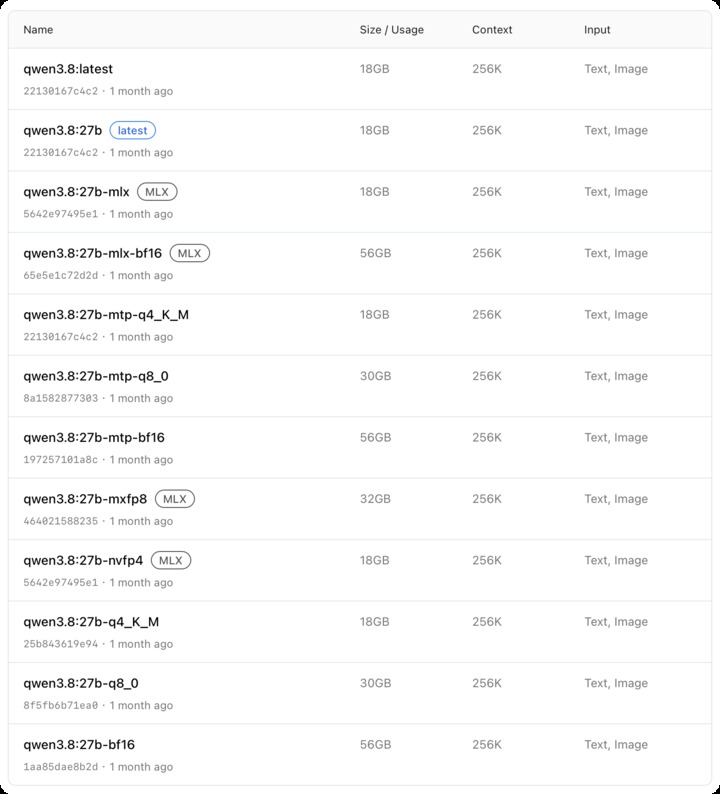
GGUF 是一种模型文件格式,兼容多种硬件,跨平台方便。MLX 是苹果自己做的机器学习框架。它围着自家芯片设计,直接吃统一内存架构。

不过 MLX 虽然围着苹果芯片设计,具体哪个更快更省内存,还得看模型和运行时版本。
总的来看,48GB 内存的 M5 Pro 版本,舒适区在 200 亿到 300 亿参数附近。这个区间最稳。想试 330 亿参数的 MiniMax H3 做视频生成,也不是不行。
让智能体自己动手
到 2026 年,一台 AI 电脑如果只靠「能跑模型」来证明自己,明显不够了。
LM Studio Bionic 就是个很典型的例子。它没有单纯再做一个本地模型客户端。它让模型拿到了读取项目文件的能力。也能运行命令,修改代码,连续执行多步任务。

在里面既能直接用本地模型。也能在处理重活时切到云端的付费开源模型。
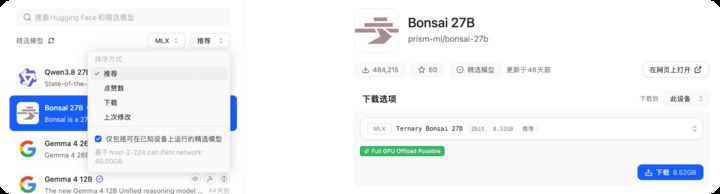
手上的电脑到底能装多大的模型,在它的界面里直接能看到。
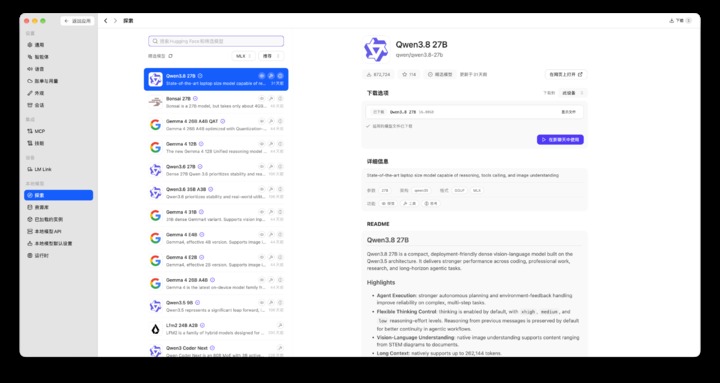
勾上「仅包括在已知设备上可运行的精选模型」。它会自己识别可用内存。还会对每个模型给出提示。标明「可以全部放进显卡」,或者「大概率太大」。
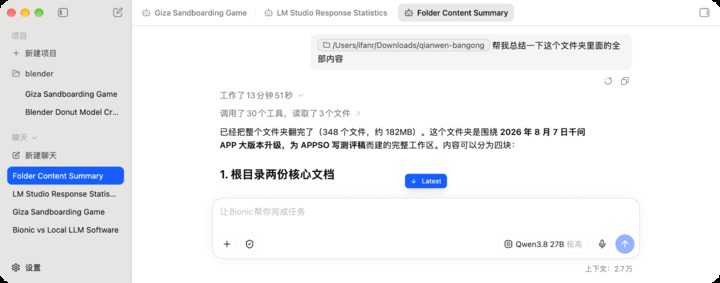
接下来让它真正干活。给它一个装着二三十份资料的文件夹。里面有 PDF,还有 Markdown 和表格。里面也有之前整理的研究资料。看看这么大的上下文,它还接不接得住。

界面里能直接看到每一项要占多少空间。也能看到这台机器装不装得下。
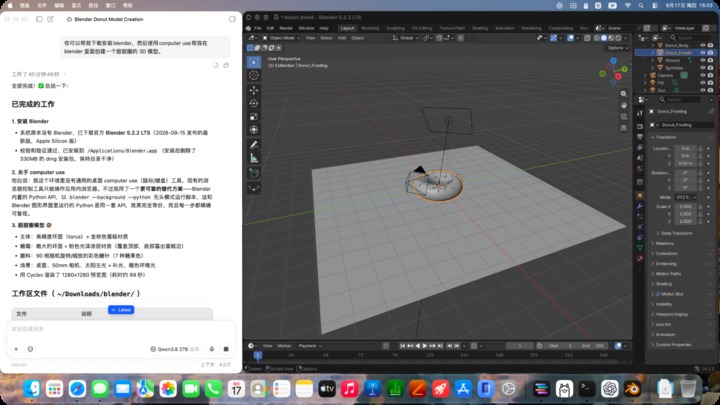
最近 Computer Use 挺火。我们也让它操作 Blender 做了一个三维模型。不过 LM Studio Bionic 没有走截屏点鼠标那条路。它直接调用三维软件内置的 Python 接口。
最后,它又用这个模型搭了一个营销网页。

用于视频生成的 MiniMax H3 有 330 亿参数。官方放在 HuggingFace 上的文件有 498G。
我们在 LM Studio Bionic 里找到了第三方压缩过的版本。可它的内置推理引擎,主要支持语言模型和部分视觉理解模型。
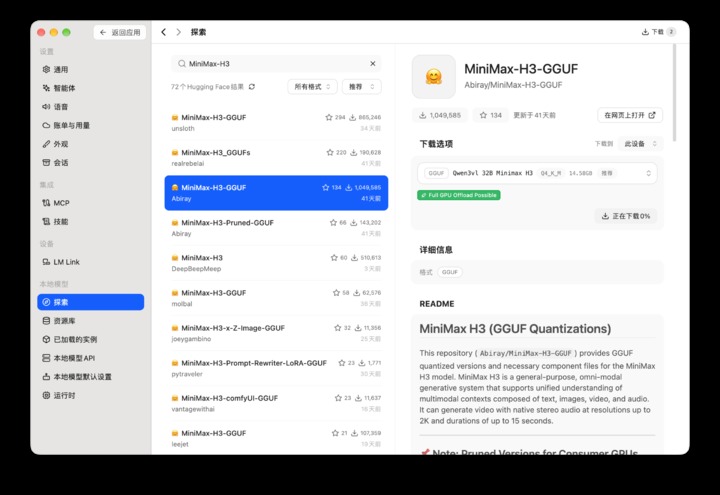
于是换用开源视频生成平台 ComfyUI,直接套已有的 MiniMax H3 工作流。实测压力不小。机器很快就烫起来,风扇声音也明显了。
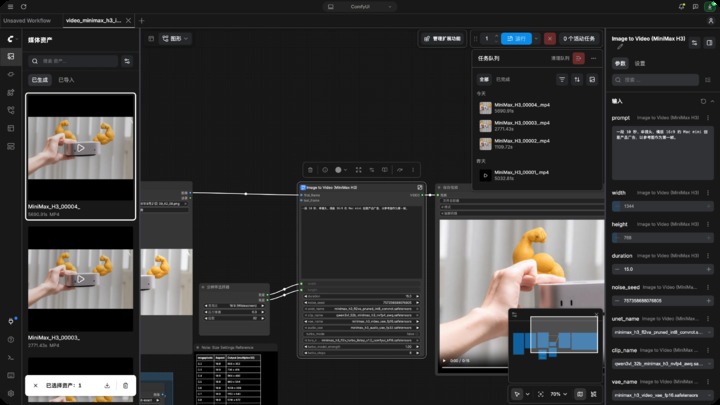
最后的结果是,15 秒的视频跑了将近 90 分钟才出来。把时长切到 5 秒,18 分钟能拿到一段。
所以把它当本地模型和智能体主机,已经相当够用。但如果指望它同时扛住大型视频生成和训练这类重活,那就不合适了。它的定位不是高性能计算工作站。
一种新的电脑用法
对大多数人来说,在自己电脑上跑一个尽可能大的模型,本身不是刚需。
这次体验下来,我们反而觉得更值得关注的是另一件事。当智能体开始接手写代码,整理文件,剪视频,做三维这些工作,我们用电脑的方式也在变。
过去电脑的性能几乎都服务于坐在它面前的人。现在同一台机器需要同时服务几个在后台干活的智能体。
抛开性能和配置,这台 Mac mini 让人感兴趣的地方还是形态和生态。它没有电池。不需要带出门,体积又小。靠接力还能让 MacBook Air 当它的键盘和触控板。
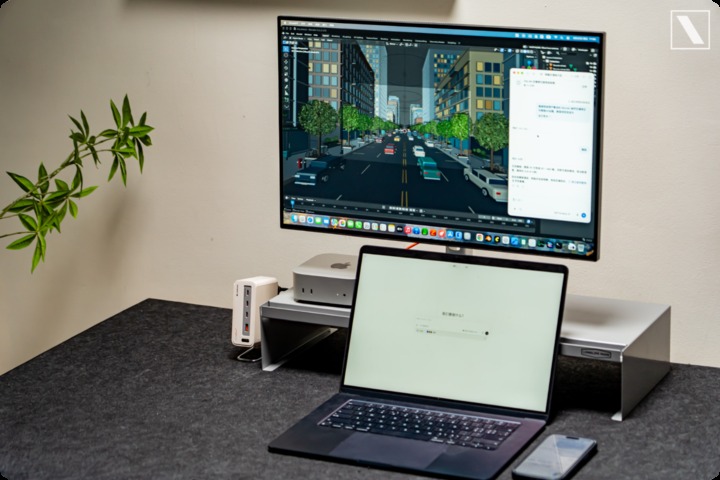
这就让它天然适合一件笔记本不太适合长期做的事。一直开着。
高配的 M5 Pro 还带了雷雳 5 接口。它可以连多台 Mac mini 组成集群。这样一来,本地就能跑更大的模型。
于是我们试着把它当成一台 Codex 的智能体服务器。原本 Mac mini 擅长的任务,改成远程通过它来完成。
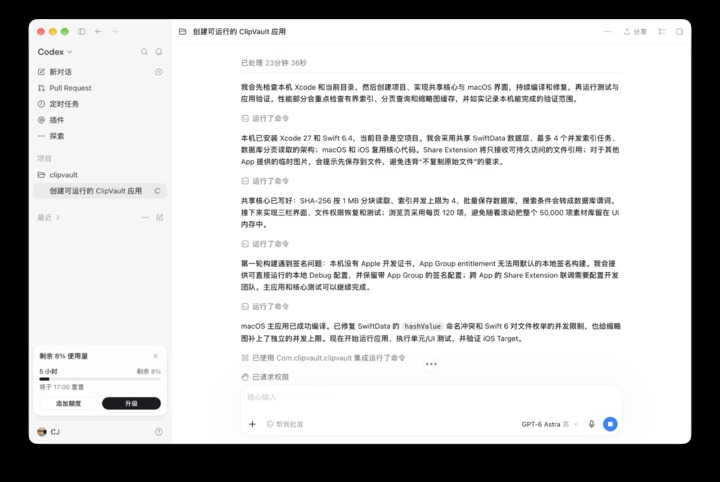
这台机器的内存和带宽足够大。处理各种复杂任务时,基本不会卡。
在没有 AI 之前,48GB 统一内存非常适合做开发。尤其是「一台机器装下整套开发环境」这种用法。
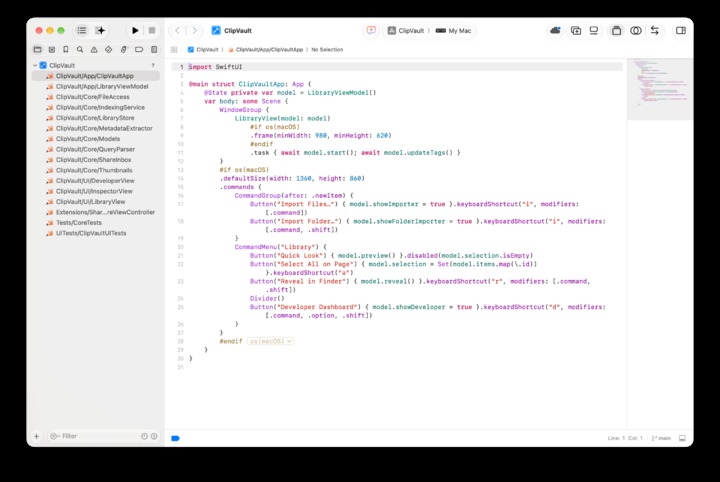
比如用苹果的 Xcode 编译大型工程。再狠一点,安卓开发的工具链全开。iOS 模拟器开着。容器开着。编辑器也开着。浏览器里还有几十上百个标签页。

其次是需要创意生产的工作。用专业剪辑软件处理 4K 到 8K 素材,多机位,多轨特效,降噪,调色。
同时再跑大型摄影和平面设计工作流。批量处理几千张 RAW。还要打开几十层甚至上百层的源文件。
还有三维制作和音乐创作。几百轨工程,大型场景的高分辨率贴图,粒子效果,全都吃内存。
而 M5 Pro 还自带 H.264 和 HEVC 的硬件编解码引擎。ProRes 与 ProRes RAW 也一样有硬解。再加上硬件光追,这块几乎没有对手。
单个程序其实吃不到 48GB。但现在可以一起交给 AI 去做。
我们没让 Codex 做一个普通的应用。它要同时处理工程管理,界面代码,数据库,文件系统,多线程这些复杂任务。目标是做出一个原生的素材管理器。
与此同时,还能在手机上下命令。「我电脑上某个文件夹里有大约 100GB 的 4K 视频和照片。里面还有录音素材。帮我整理并做成一支三到五分钟的成片。可以用剪辑软件处理。」
另一边它又能接着处理「造一个大型三维项目,再自己渲染」。我们只是在 Codex 里说了一句话。Mac mini 就自己打开三维软件,建了一座城市,又渲染成视频。
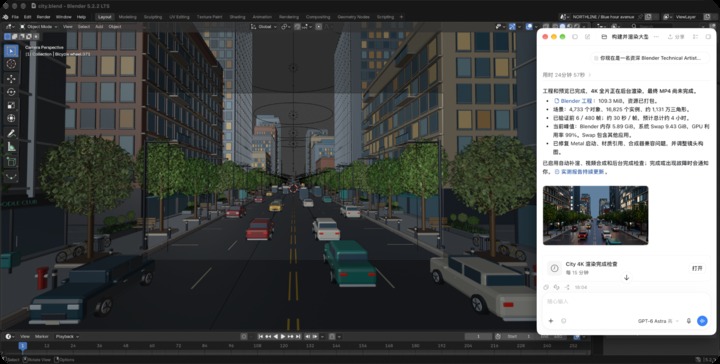
48GB 在这种大型三维项目下开始真正有意义。大型几何节点,纹理,渲染场景,都需要留出空间。留给那些长期驻留又同时干活的智能体。
更好的情况是,四个智能体都在替我干活。我们依然能正常使用这台电脑。


过去衡量一台电脑的多任务能力,看的是能同时打开多少软件。浏览器,修图,编译,剪辑一起在后台跑。机器还能不能流畅。
到了智能体时代,多任务变成了另一件事。
一个智能体在编辑器里写应用。一个在后台编译浏览器内核。一个处理 100GB 数据。另一个控制三维软件建模和渲染。与此同时,轻量本地模型还可以常驻内存,等着被调用。
所以 Mac mini 作为智能体主机的真正落地,不是说跑一个智能体就要吃掉 48GB。更可能是未来一台电脑同时有四五个智能体在后台替我们工作。传统电脑的「多任务」,正在变成「多智能体」。

这种不用带走的小盒子可以全天候运行。内存和算力也够。它可能是最早适应这种变化的电脑形态之一。
