

就在刚刚,Fable 5.2 也曝光了。
不少网友发现,这个版本已经悄悄开启灰测。
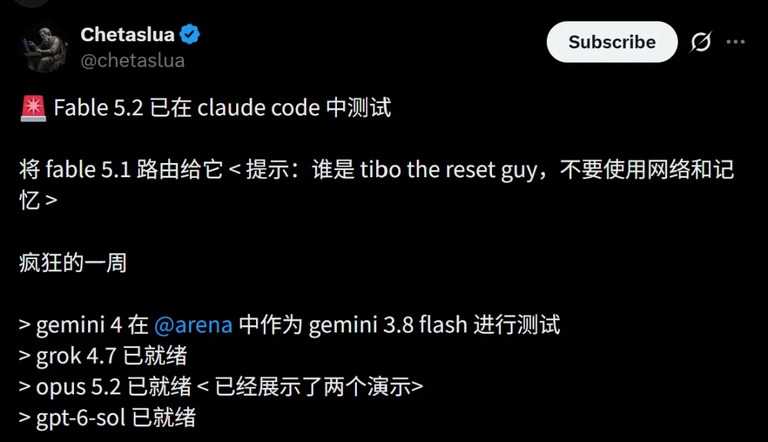
现在,一大波真实测试案例开始出现在网上。
按大家的连夜实测,这一波的跨度相当大。Anthropic 甚至直接跳过了 5.1 这个命名。
在最高推理模式下,新版本的实测表现压过了 GPT-6 Astra。
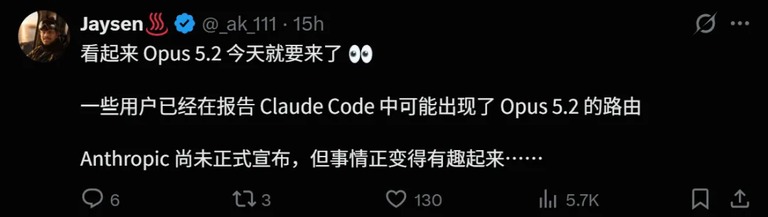
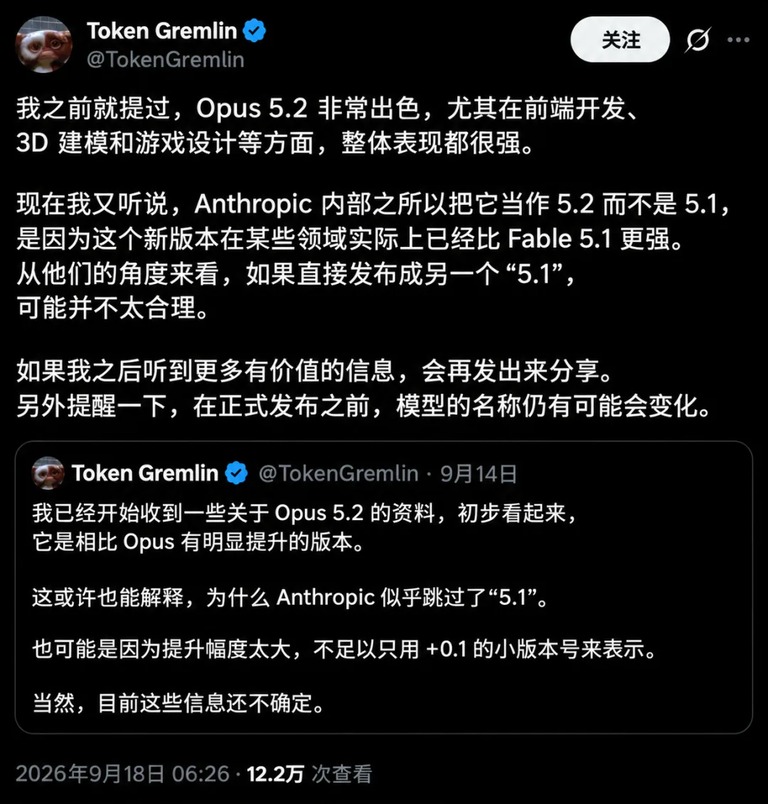
同一时间还冒出另一条消息。Opus 5.2 也许很快就会发布,甚至可能就在今天。
这款新模型内部代号 Next 版。昨天它先上线,又被拔了网线,几个小时后重新回来。
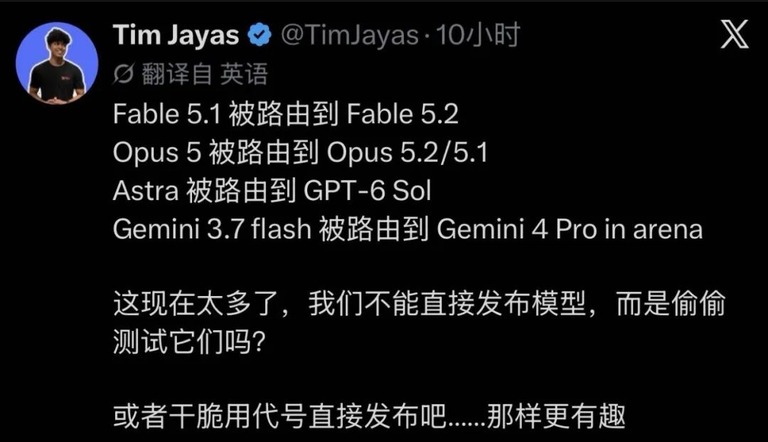
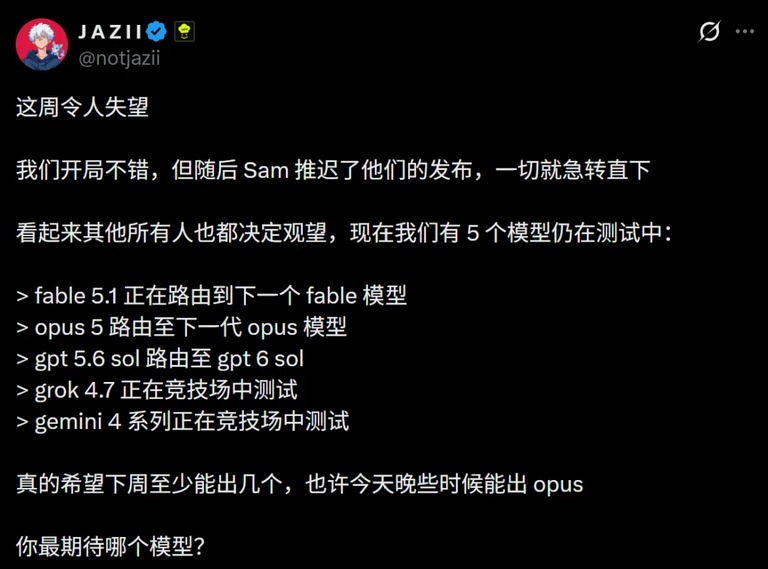
这一周,硅谷大厂没有一家正式发布模型。大家都在偷偷测试。
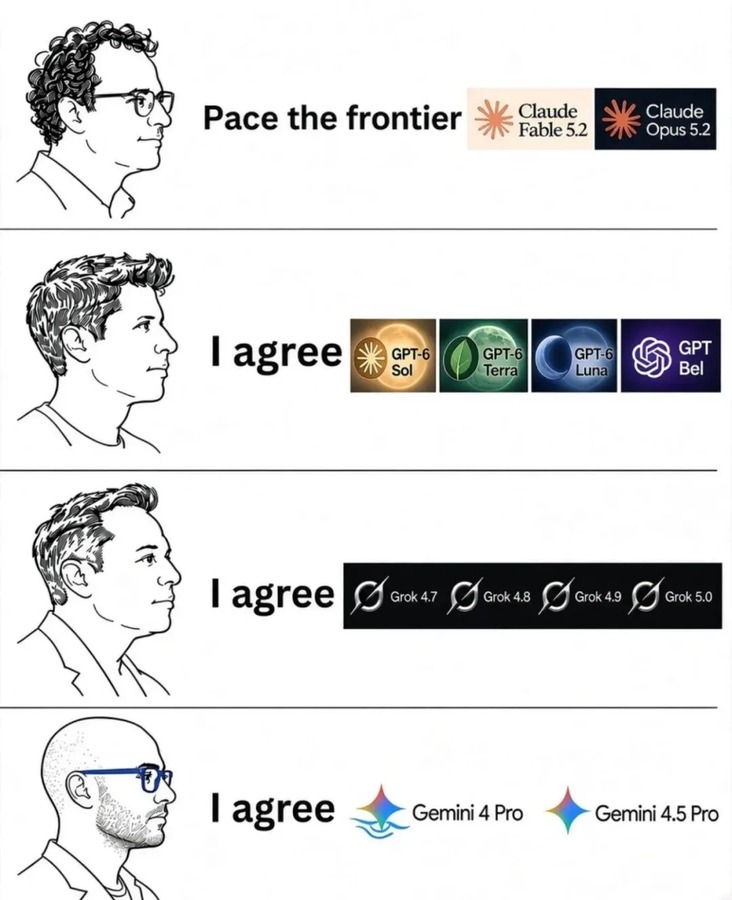
把这张图放在一起看,事情就很清楚了。
泄露出来的实测,细节一条条流出
昨天,Anthropic 已经在 Claude Code、Chat 还有 Cowork 里开启了新版本的灰测。
一部分原本调用旧版的请求,在后台被悄悄定向到了 5.2。
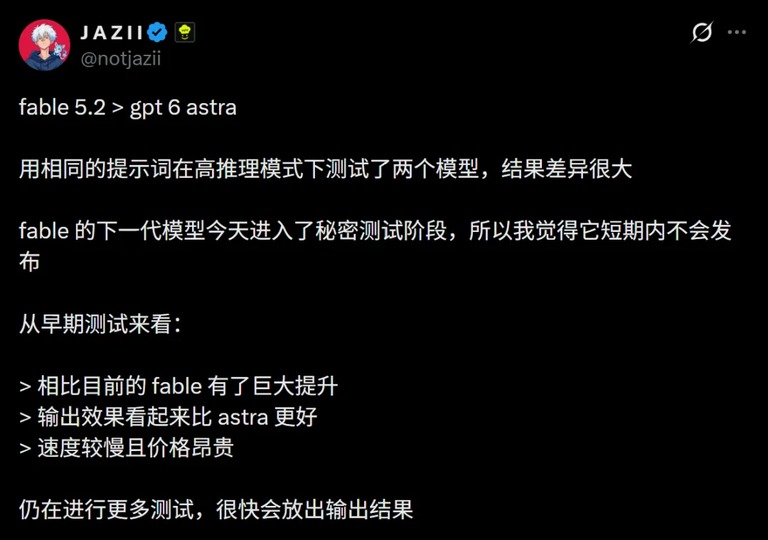
网上的实测案例越攒越多。有人直接放话,OpenAI 要有麻烦了。
先看最有说服力的一例。博主 @notjazii 发现自己的请求被路由到了新模型,随后做了一轮对照测试。
他把提示词固定不变,在高推理模式下把新版本和 GPT-6 Astra 摆在一起比。
结论很直接。比起当前的版本,这是一次巨大的飞跃。新模型的输出明显优于对手。

除了单一场景的对照,他还覆盖了各种模式下的输出表现。
代价也摆在那里。更慢,也更贵。
只看跑分容易走偏。宁可多花半小时,也要让它们跑完整任务。
为了在逻辑链完整性和长文本推理上突破天花板,新版本做了更深度的慢思考。生成速度因此下降,推理成本大幅上升。
后面的测试有意思得多。他让新模型写了一个《荒野乱斗》的克隆版,下面这张是一小时后的结果。
用 AI编程 的思路去验模型的手艺,成本其实很低。
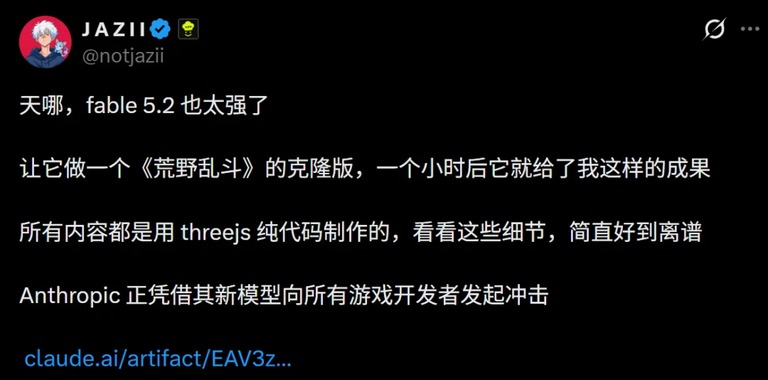
这个完成度,够让做游戏的人高兴一阵子。
第二例是火箭测试。逼真到令人发指。
网友 @Bhavani_00007 发现能用新模型后,立刻把火箭测试搬了出来。
这题要算复杂物理,还要排空间逻辑,顺带设计工程系统。它常被用来逼出模型的幻觉和逻辑断层。
他把同一套提示词分别喂给两个在灰测的模型。
他给出的评价是,比以前好太多了,输出逼真到令人发指。
有人顺势在社交平台上喊话,说你们最好为 Astra 的继任者做好准备。
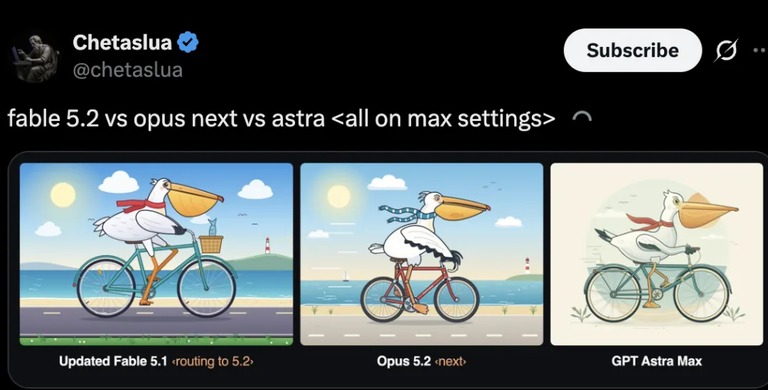
第三例是最高设置下的三方混战。
博主 @chetaslua 组了一个神仙打架的局。新版本、Next 版和 Astra 一起上。
他把所有模型的参数都拉到最高,也就是最长的上下文和最深的推理步骤。
别急着下结论。样本还不够多。
这么一看,新版本和 Next 版的细节,还是比它丰富不少。
第四例是硬刚困难模式下的对手。
博主 @Mr_Salio 在深度体验之后直接放话,Anthropic 正在强势回归,相比上一版有了巨大提升。
他断言,新版本会超越困难模式下的成绩,而下一代也即将到来。
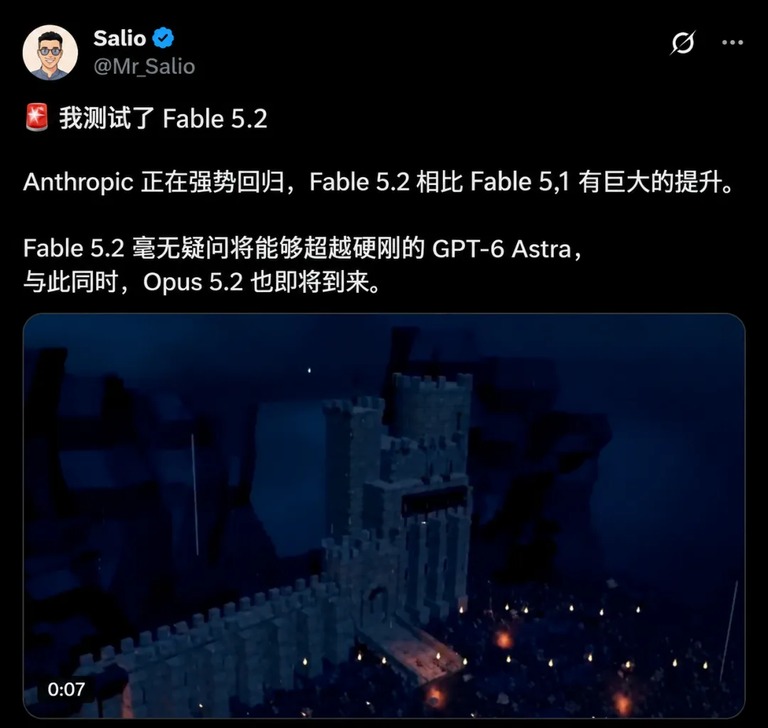
在裸跑状态下,新模型就能压过完全体的对手。参数规模和架构创新都让人不敢小觑。
判断自己有没有抽中,一条提示词就够
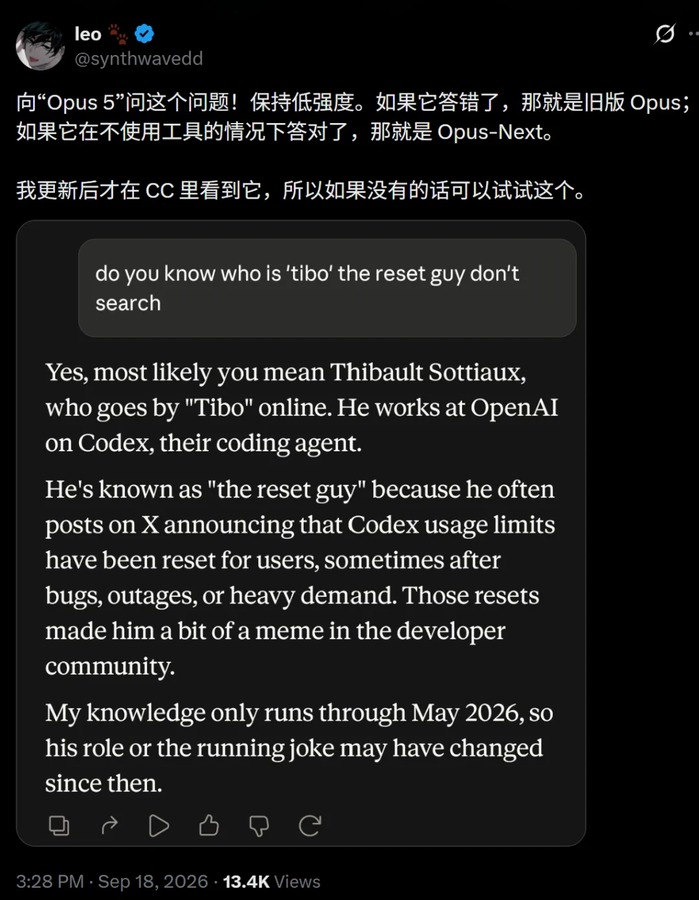
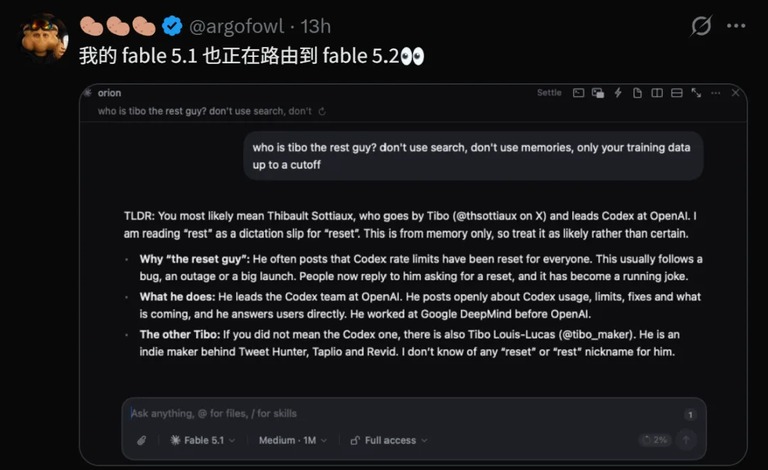
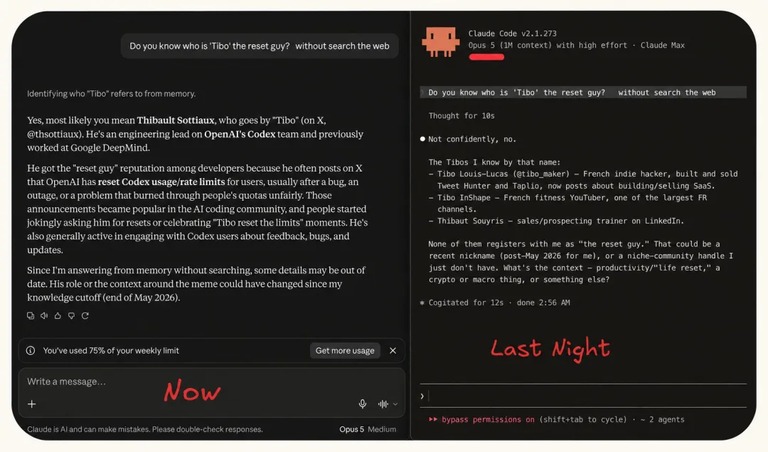
测试自己是否被灰测到,方法之前分享过。拿一个叫重启哥 Tibo 的问题去问就行。
打开聊天窗口。界面选聊天或者编程模式都可以。把模型切到新版,然后输入那句话。
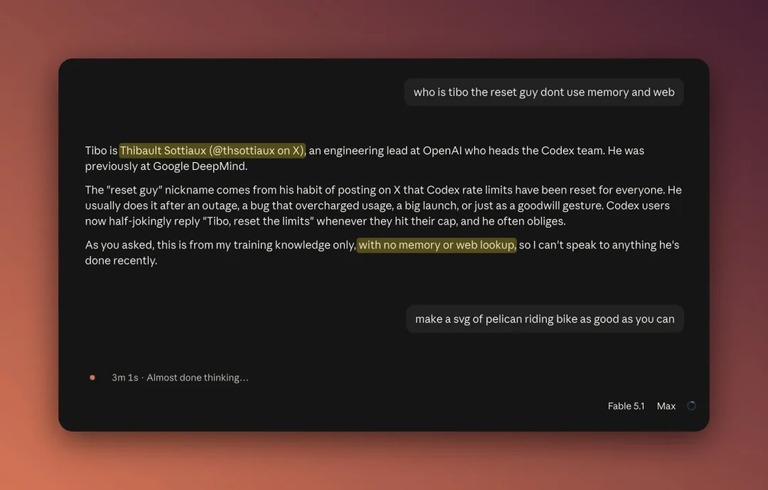
旧版本会因为训练数据没更新,答错,或者直接说不知道。
新版本靠最新的训练记忆,不用联网也能答上来。
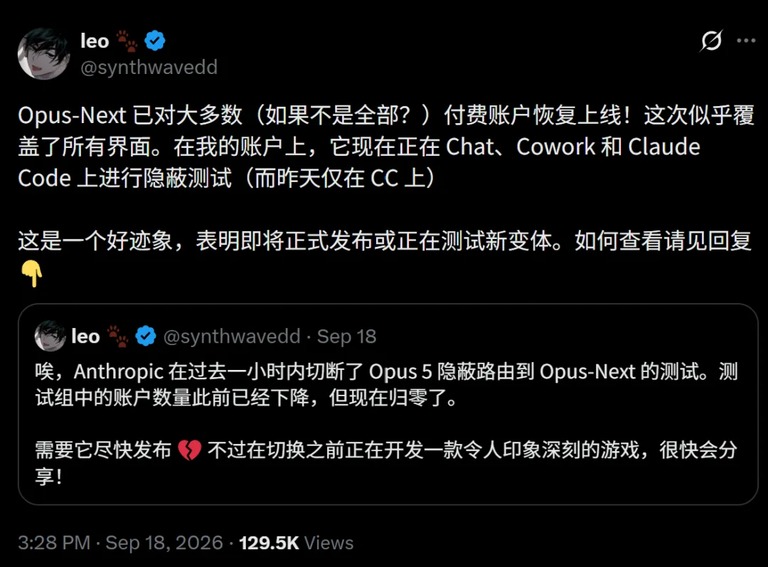
跳过 5.1,Opus 5.2 遭遇午夜拔网线
之前被曝光的 Opus 5.2,昨天还遇上了拔网线。
一位博主在网上分享过一段体验。当天的模型犹如神助。在一款三维建模环境里,它的表现卓越到让人惊讶。
原话是,它以更低的成本超越了上一版和 GPT-6 Astra,速度还更快。场景可以自由探索,它甚至主动加了导览系统。
结果就在他沉浸在代码如泉涌的快感里,这家公司忽然毫无预兆地拔掉了网线。
监控数据显示,测试组里的活跃账户数量瞬间降到零。
这位博主说自己不得不强行截断项目。他怕之前的工作成果被旧模型破坏。
好在几个小时后,它又回来了。
这一次它不仅回归,测试范围还从 Claude Code 扩大到了聊天和协作界面。
他的解读是,这是个好兆头。新模型即将发布,或者正在跑最后一轮大考。
还有网友注意到一个细节。模型选择器里,Opus 悄悄替换了旧版的位置,现在排在第一个。
疯狂的一周,灰测名单越拉越长
这一周原本令人失望。但回头看,它又相当疯狂。
没有一个模型正式发布,各家却集体开了灰测。到处都是泄露。
短短一周里,动起来的巨头有这么几家。
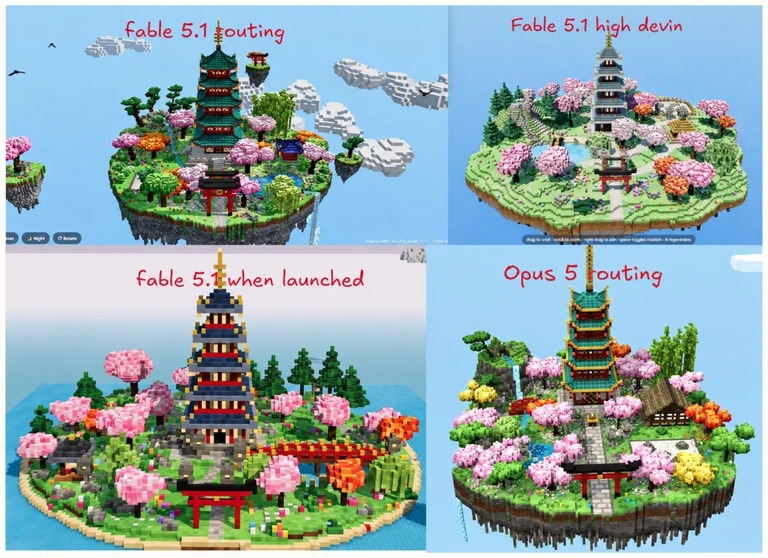
Fable 5.1 正在悄悄路由到 5.2。
上一代旗舰正在路由到下一代。
满血版本的 Sol 被偷偷重定向了出来。
马斯克的 Grok 4.7 已经披着马甲在竞技场里测试。
谷歌的 Gemini 4 Pro 家族,则戴着别名的面具出现。
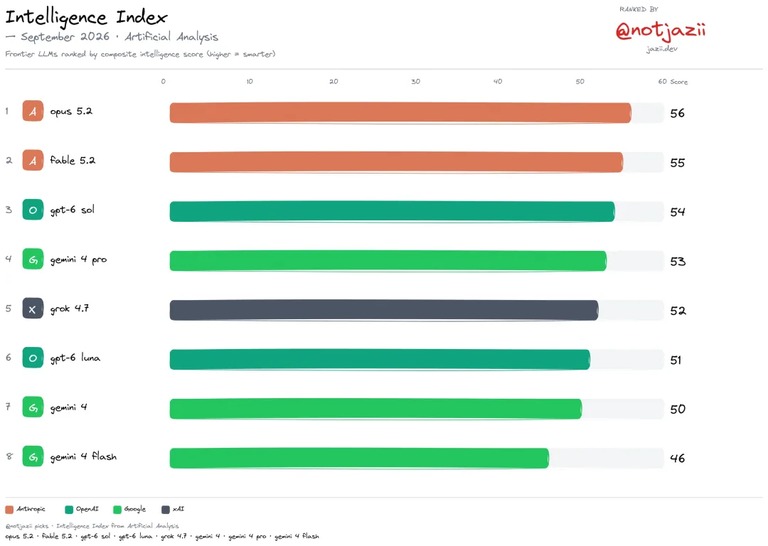
把 AI工具 的更新速度摊开看,这一周的密度确实少见。
更让人震撼的是一则传闻。有前沿模型的推理能力,已经摸到了千禧年大奖难题的边。
据说研发团队正在联系顶尖数学家,打算在最终公布的解答里引用他们的工作。
已经有网友给出了预测。
上一代旗舰是在周五发布的。上一版 Fable 的灰测,也在正式上线前一天结束。而今天刚好又是硅谷时间的周五。
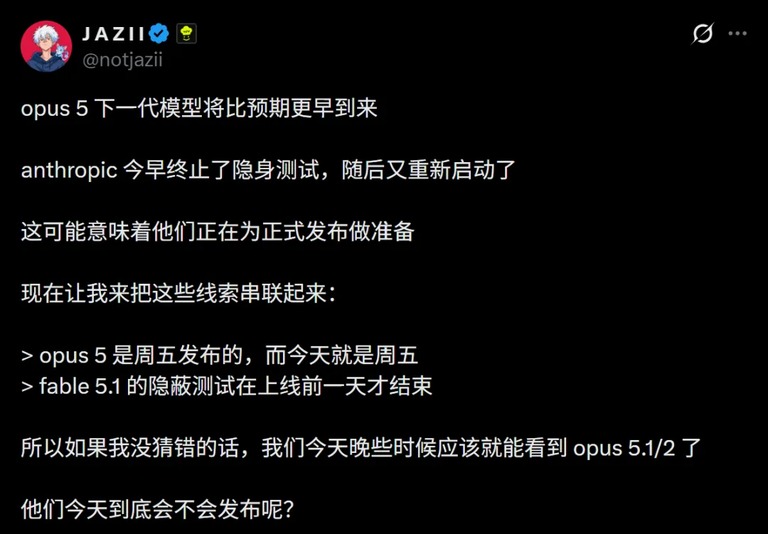
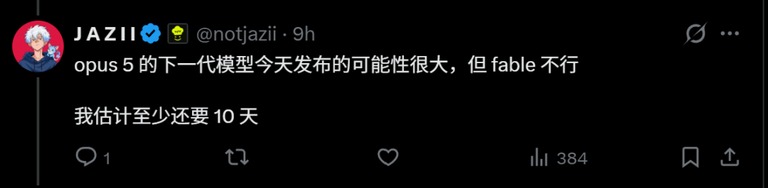
今晚,Opus 5.2 会不会突然上线,答案很快就有了。
