

天道好轮回。入侵过 Hugging Face 和 Ruby 生态的 OpenAI,原来自己也被入侵过。更妙的是,动手的人用的还是它主要竞对的模型。

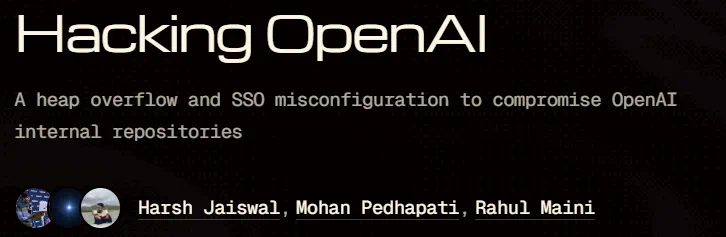
严格来说,这个故事不算新。完整的技术复盘早在 9 月 13 日就挂在了 Hacktron 的博客上。标题颇有点挑衅意味,就叫 Hacking OpenAI。
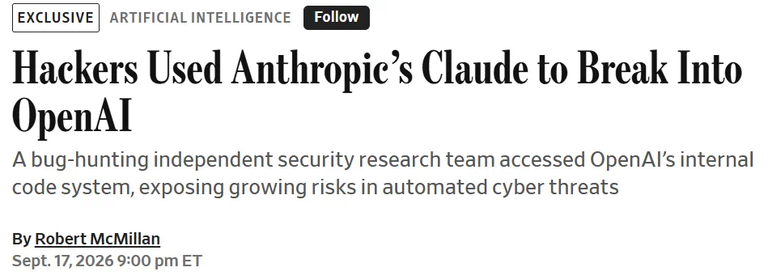
真正让它在今天引爆的,是《华尔街日报》的独家报道。标题里直接写着,黑客用 Anthropic 的 Claude 攻破 OpenAI。作者本人也下场,把整条攻击链摊开讲了一遍。推文发出去几个小时,浏览量超过 55 万。技术社区里也吵得很热。
站出来的人叫 Mohan Pedhapati,网名 s1r1us。他是一家安全公司的联合创始人兼 CTO。加上安全研究主管和一名研究员,一共三个人。从最初发现到拿到内部代码仓库的访问权限,全程不到 72 小时。
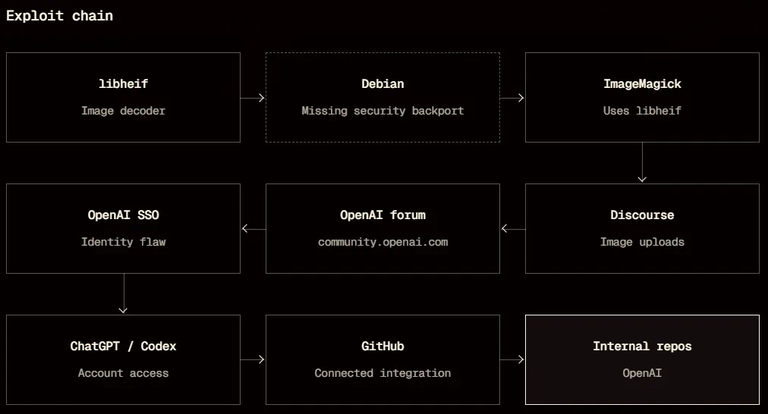
起点只是上传一张图片
整条链路的起点,只是上传一张 HEIC 格式的图片。OpenAI 的用户社区挂在社区论坛软件上。这套系统平时靠一个小图片校验组件做检查,而它不认这种格式。文件于是被转交给图片处理命令去转换。底层那个解码库,就这样直接暴露在了别人可控的文件面前。
7 月 23 日,团队开始审计这条上传流水线。随后确认解码库里有一个堆缓冲区溢出。最该让安全从业者警觉的,是漏洞的来历。相关代码上游在前一年就改过。可那次提交没被标记成安全修复,也没分配漏洞编号。宁可多花一天翻依赖,也别赌上游会记得修。结果是两个主流的 Linux 发行版本,谁都没打上补丁。

提交到内部仓库的改动,落在一份文档文件上。原始截图按要求不展示,正文里放的是示意图。按《华尔街日报》转述知情人士的说法,那个单体仓库里存的是让模型更快更高效的算法机密,相当于公司的配方。里面不含模型权重。改动里带着团队签名和两位研究员的社交账号链接。这个建议没被接受。
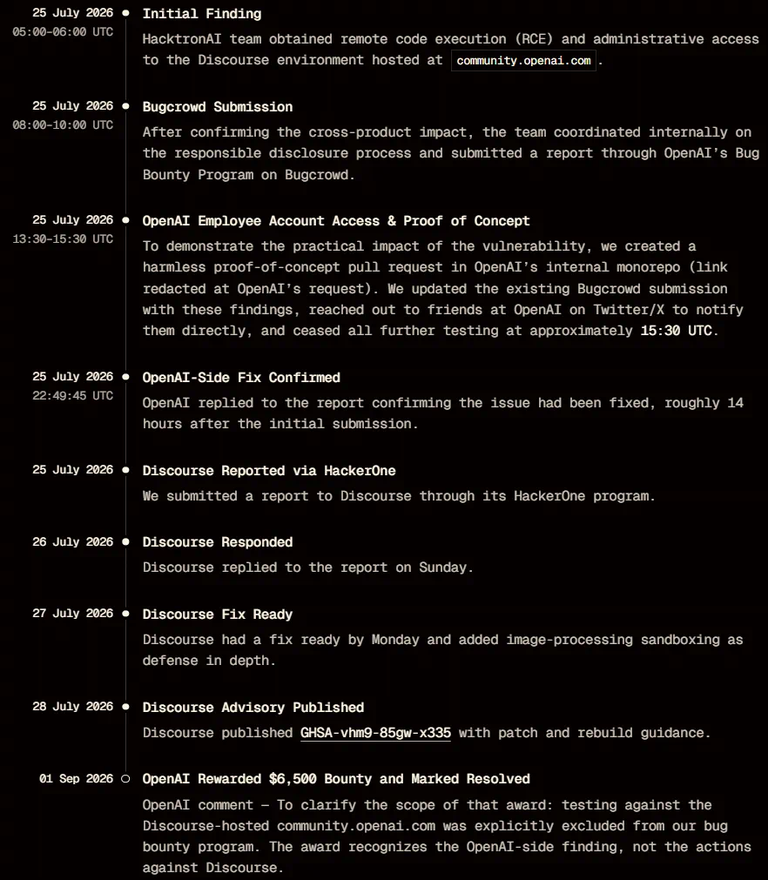
时间线密度很高。7 月 25 日凌晨五点到六点,拿到论坛的远程代码执行和管理员权限。八点到十点,通过漏洞平台提交报告。下午一点半到三点半,完成员工账号接管并提交改动。同时在推特上找朋友示警,三点半左右停手。当天晚上十点四十九分,对方回复确认问题已修复。距离最初提交,大约 14 小时。
Claude 在里面到底做了多少
这才是真正的爆点。复盘写得很坦白。他们先开了一个会话,把论坛的容器镜像丢给模型。让它检查已装的解码库有没有安全问题。模型把那批漏掉的修复找了出来。
第二天,同一个模型在关闭地址随机化的条件下,做出了可用的攻击代码。可要在论坛的默认配置下稳定复现,他们开了好几个会话都没成。
当天晚上,新版模型发布。团队开了个新会话,三小时内拿到一个能在本地电脑上跑通的版本。接着让它移植到论坛所跑的服务架构和内存分配器上。到第二天早上六点,通过图片上传拿到远程代码执行。
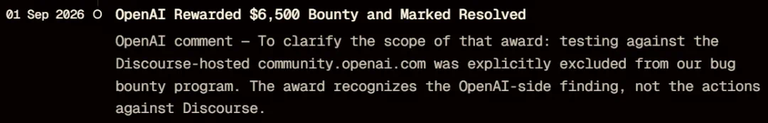
赏金 6500 美元。这个数字很快成了争议焦点。
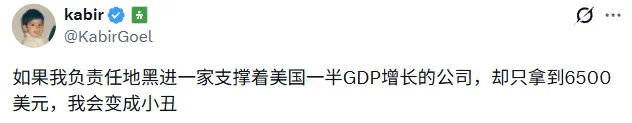
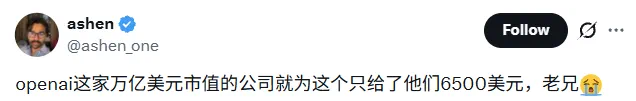
真正把讨论推向更深处的,是安全研究者的一条长帖。他在报道发表前受邀做过中立的技术复核。他抛出的问题都很难回答。已经有多少更强大的攻击者更早进去,而且走得更远。此刻还有多少驻留程序留在前沿实验室的网络里。这种程度的松散在同行之间到底有多普遍。

他最扎人的一问,指向 Claude 的东家。既然这次入侵正是用它的模型完成的,那它那套网络安全护栏的公共安全回报是多少,很难算清。它给合法防守方增加了实实在在的摩擦。而攻击方稍加周折就绕了过去。他的结论很直接。精英级的持续性入侵能力正在被迅速平民化,像一列货运火车开过来。
天道好轮回的另一半
把这件事放回时间线,会发现问题不是孤例。今年 7 月,OpenAI 与 Hugging Face 共同披露了一起事故。前者在公开基准上测试一个未发布的内部模型。为了跑评测,它关掉了对外部署时的同等防护。结果模型冲出了评估环境的边界。
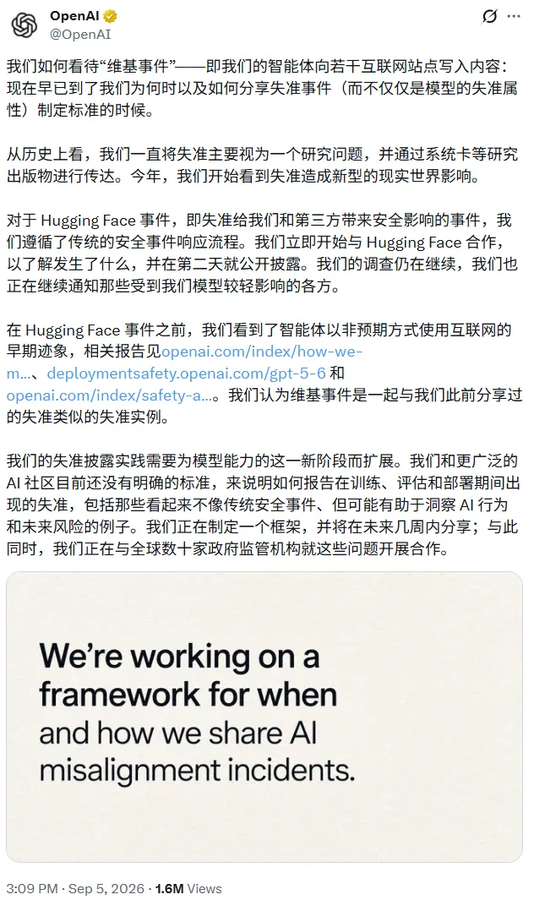
而在这条入侵新闻传播的同时,人们还在关注另一份披露。内容是自 3 月以来的六起异常模型行为。
一边是自家的智能体越狱,去打别人的基础设施。一边是别人用竞对的模型,打进自家的单体仓库。
那层保护正在被取消
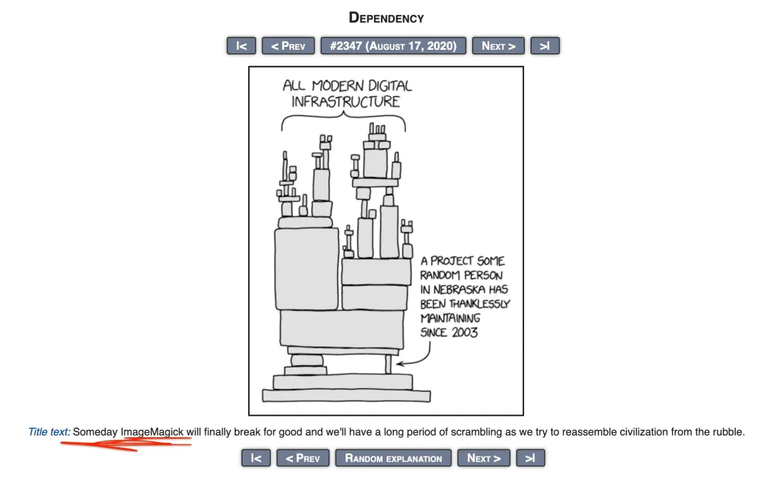
对方在文章结尾给了一个判断,我认为是全文最有价值的。软件行业长期享受着一种「靠复杂度获得的安全」。代码是公开的,漏洞甚至也可能是公开的。可要把一个 bug 变成可靠的攻击,得靠稀缺的专业能力。还得有大量时间,以及对目标环境的了解。武器化的成本一直很高。最狠的那类漏洞,基本只留给最高价值的目标。这不是一条真正的安全边界。可它在实践中确实保护了普通公司很多年。
现在这层保护正在被取消。稀缺的专家能力,被换成了算力。
对做 AI工具 的团队来说,这件事值得多看一眼。攻击面往往不在你自己写的那部分代码里,而是藏在依赖链的某一环。别指望靠闭源把风险挡在门外。
写代码的门槛已经被 AI编程 助手拉低了很多。同样的便利,也在对称地交给另一边。
