

一条推理轨迹,动辄几千个词元。
训练时,每一个词元都要给出一份梯度信号。
上万条轨迹叠起来,一次后训练要吃掉上亿个词元的信息。
监督越密,成本越高。
过去几年里,后训练一直是大模型从能说走到会想的关键一步,代价就是天文数字般的词元级信号。
这是亚马逊和杜克大学一项新研究的起点。
论文题目很直白,说的是极端稀疏的监督也能激发推理能力。
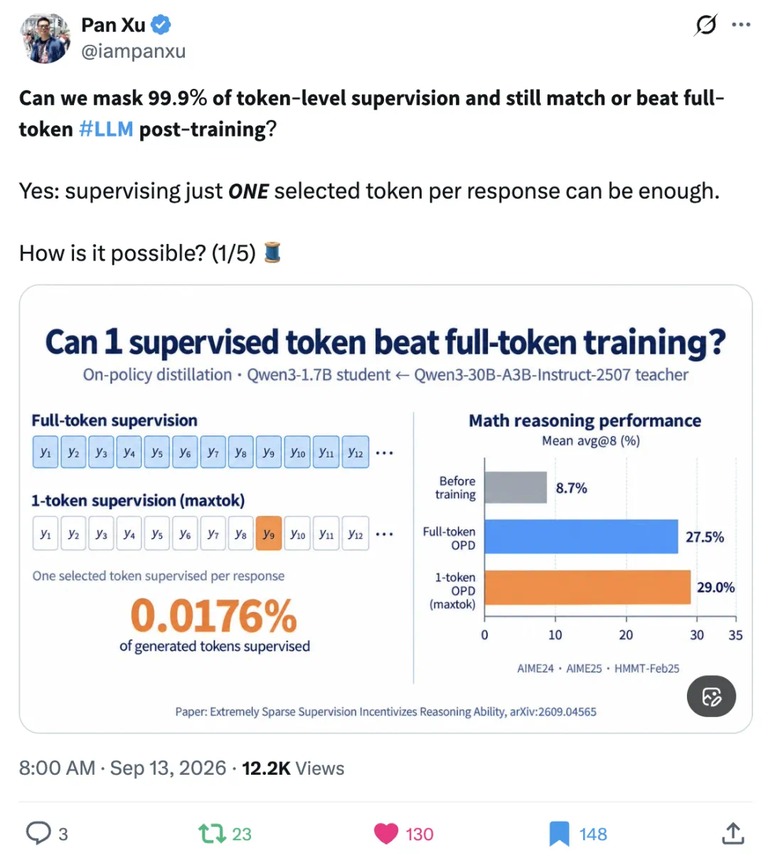
他们想问的,其实是一个被默认了很久的假设。
后训练里密密麻麻的词元级信号,一直被当成必需品。
答案出人意料。
更省,反而更好。
把绝大多数信号砍掉,模型的推理能力反倒往上走。
一个词元,能带多少信息
整套实验,建立在一个已经跑通的做法上。
在线策略蒸馏,是后训练里被反复使用的一条路径。
学生模型写出一条推理轨迹,教师模型对每个词元逐一给出反馈。
信号密到不能再密。
每一步都在打分。
密集信号一直被当成它有效的原因之一。
密集,往往也意味着贵。
可也正因为太密,很难看清到底是哪一步在起作用。
这也让它的内部原理,变得不太好拆解。
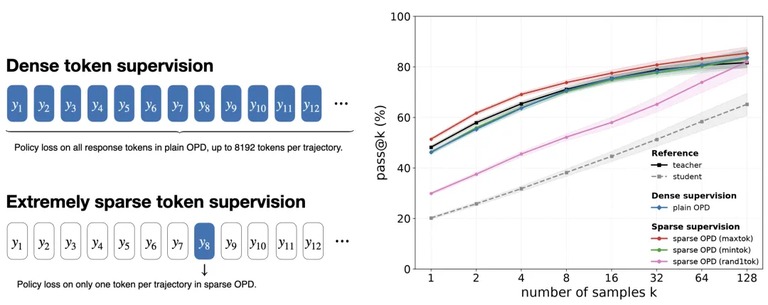
研究团队干脆把它推到极端。
对学生模型生成的每一条轨迹,只随机保留一个词元处的梯度。
一条四千个词元的轨迹,被监督的只有其中一个。
其余全部屏蔽。
只留一个。
被留下的那一份,占比大约是四千分之一。
稀疏到几乎是随手一抽。
他们搭了九组不同的教师与学生组合。
小模型学大模型,同规模的互学,大模型反过来学小模型。
组数多,落差也大。
跨度很大。
三档表征差距,都试了一遍。
所有组合里,学生模型的推理能力都在往上走。
没有一组例外。
随机挑一个词元,居然次次都灵。
他们把信号压到这么低之后,反而在最难的数学推理上拿到了更好的成绩,这个反常的结果才是整篇论文真正有意思的地方。
换句话说,你每天用的 AI对话 产品,底座可能就是这么练出来的。
信号越稀,效果反而越好
接着他们想的是,能不能再抬一格。
在线策略蒸馏里,每个词元的信号代表教师与学生在该处的分歧度。
挑分歧最大的那个词元留下,是更聪明的做法。
结果有点反直觉。
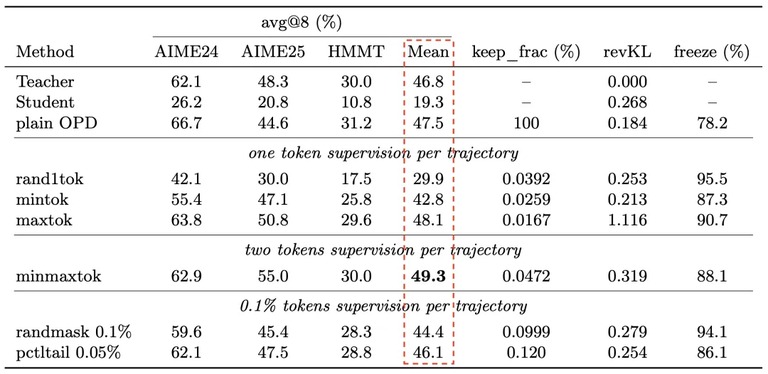
只监督一到两个词元,效果就追平甚至超过了全信号训练。
挑得准,比挑得多有用。
更意外的是另一面。
这样训出来的学生模型,不只是比全信号训练的好。
它还越过了教师模型本身。
而它与教师模型输出分布的差距,没有缩小,反而拉大了一些。
差距在拉大。
这一点,和「学生照抄老师」的直觉正好相反。
换句话说,学生不是靠模仿拿到提升的。
为了确认这不是个例,他们把实验铺得更开。
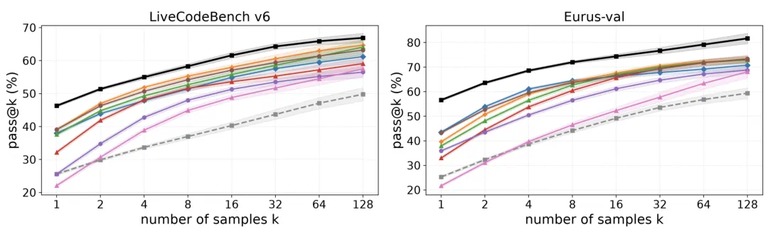
代码推理是一个方向,换一家开源模型再试一遍,还有一类带可验证奖励的强化学习。
代码推理,也就是 AI编程 那类任务,同样跑通了。
换成别的任务,换别的模型,再换一种训练范式,结论都没变。
结果一模一样。
稀疏监督背后的机制
严格说,这项研究只提供了一个数据点。
一次成功的后训练,可能只需要几千个词元处的梯度。
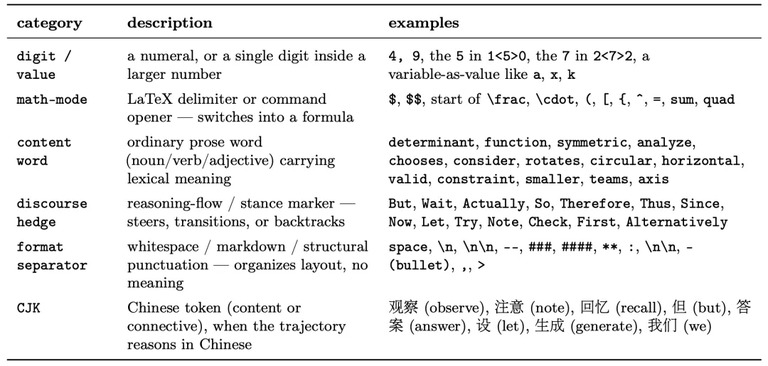
在这个尺度上,研究者能直接看清被激活的词元承载了什么语义。
下表列出的,就是一些被激活、并且拿到正奖励的词元。
消融试验又补了三条线索。
推理能力的提升,与信号密度并不是一条直线。
信号变稀,性能先降一点,随后又回升,极端稀疏时甚至反超全信号。
这条曲线,自己带着一个谷底。
谷底就在中间。
少了不行,多也不一定好。
学生模型表征能力够强时,正奖励的词元更能激发它。
表征弱于教师时,负奖励的词元反而更管用。
万分之一的信号,只更新了大约百分之十的网络参数,性能提升却相当可观。
参数动得少,效果却够看。
也算省了一笔。
至于为什么一个词元就够了,眼下还是开放问题。
研究团队给了个类比,很像是人的自然学习。
一个人带着基础去学复杂任务,往往不需要细到每一步的反馈。
一两次关键的纠正,就足以改变后面的做法。
模型也一样。
它已经过了预训练和微调两轮打磨。
再往上推的时候,也许真的不必把每个词元都盯一遍。
与其把每个词元都数清楚,不如先想清楚,哪几次纠正才真正改变了结果。
宁可先把信号砍到最少,也别让没用的密集监督,把关键的那一步埋掉。
说到底,这不是让训练变少。
它是让每一次纠错,都落在该落的地方。
信号少一点,噪声也就少一点。
对用 AI工具 的人来说,这意味着更少的算力,也许就够了。
至于这条路还能走多远,得看接下来的实验。
