

一台一体机,去年能卖到一百五十万。
今年,同类的机器大多只敢标到 70B。
市场掉头了。
风向变了。
大模型一体机,说白就是把算力、模型和运维平台装进一个箱子。
拉到机房,通上电,就能跑本地私有化的大模型。
机构不必自己攒服务器,也不必自己调框架。
去年年初,它火过一阵。
今年,它开始缩水。
争议是从一台机器开始的。
2025 年春节前后,一款国产大模型横空出世,相关热度一路往上走。
春节后不到三个月,六十多家厂商跟风推出一体机。
价格也水涨船高。
一台满血版,普遍要一百二十万到一百五十万。
用国产卡的话,单台显存不够,往往得两台并联。
预算直接逼近四百万。
于是争论来了。
一台机器上百万,财务支出不小。
可要是调云端大模型,这笔钱几百年也用不完。
更麻烦的是,大模型一直在长大。
它一直在变重。
单机硬件的算力上限,迟早会露出来。
三个月后,市场就凉了。
行业慢慢形成一句共识。
大模型有用。
一体机,真没用。
这话说得糙,理由却很实在。
一台标准一体机,至少得插八张显卡。
受限于单机架构,它吃不到集群部署的规模效应。
综合使用成本,一直压不下来。
账不好算。
更关键的是软件。
软件才是分水岭。
早期不少一体机,本质只是硬件打包。
模型是装上了,优化却没做。
标称能跑 671B,真到多人同时访问,卡顿很明显。
有些厂商重交付、轻运维。
设备一交出去,模型更新就不管了。
机构只能自己再派人做二次改造。
结果硬件到位了,业务却跑不起来。
白花一笔。
到 2025 年下半年,满血版卖不动已经不是秘密。
中小厂商的成单主力,悄悄换成了 32B 和 70B。
不过,硬件涨价这件事,得分开看。
时间进到 2026 年,内存和存储,还有显卡,相继涨价。
从资产角度看,去年年初买的一体机,如今二手处置甚至能收回全部成本。
还有得赚。
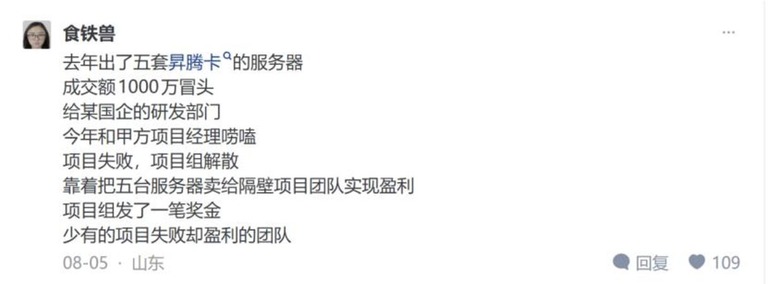
有位网友讲过一件事。
他们公司去年把五套国产卡服务器卖给一家国企的研发部门,成交额一千万元出头。
今年他问那个项目的经理,才知道项目失败、项目组也解散了。
靠着把五台服务器转手卖给隔壁团队,账面居然盈利。
项目组还发了一笔奖金。
当初被调侃高价踩坑的采购方,反倒成了这轮涨价里的受益者。
可账面的升值,不等于现在适合再买一批。
二手一体机普遍有保修失效的问题,固件驱动也常不兼容,功耗还偏高。
老旧架构想跑通新一代混合专家模型,得先改推理框架。
不是拿到机器就能满血开跑。
这也压住了机构囤二手设备的意愿。
今年风向又变了。
市场不再只认能跑 671B 的一体机,轻量化本地设备开始冒头。
相比去年的满血高端机,今年的硬件配置和可承载的参数量都在下调。
多数中端设备,最多只跑 70B 级别。
缩水的原因不复杂。
四条。
需求端在挤泡沫。
大量实践说明,用户真正要的是知识库问答、公文写作这类场景。
这些场景,靠蒸馏过的小模型就够了。
671B 的能力,大部分时间用不上。
模型端也更省了。
省得还不少。
稀疏激活这类技术逐渐成熟,加上蒸馏和量化,同样的效果所需参数量大幅变小。
高端芯片的供给则受了限。
2025 年 4 月,H20 被无限期停售。
国产加速卡虽有迭代,单卡还是跑不动超大模型。
想满血运行,仍要多台并联。
多卡并联又会带出调试复杂、生态适配工作量大的问题。
项目落地的门槛,就这样被抬高。
再算上内存涨价,本地部署满血版的成本涨得太快,性价比不划算。
整个市场,就此劈成两半。
一半走量。
轻量缩水版主打出货,撑起大盘。
满血高端机还在,买家却高度集中在有强合规要求的央国企和金融机构。
高端机型的出货量,整体大幅下滑。
那高端一体机还有没有价值。
在特定场景里,有。
复杂生产场景就是一类。
小模型在这些事上有明确短板。
智能体的长链路任务、工程级代码开发,还有 AI视频生成,是眼下增长最快的一批应用。
它们对推理深度、逻辑链条和多模态理解的要求都很高。
要稳稳撑住这类任务,还是得部署满血版大模型。
省不了。
所以高端一体机没被轻量化挤没,反而在生产环节更显价值。
另一类是云端成本顶不住的时候。
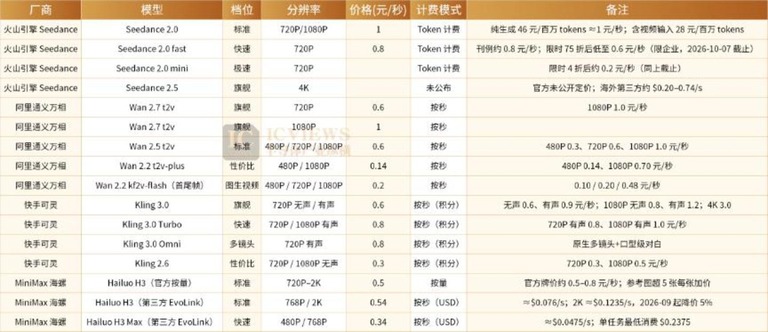
词元价格在涨,加上多模态生成的海量消耗,云端大模型的账单正在快速攀升。
AI编程要反复迭代、大量试错。
AI视频生成更是按秒计费,单条成本能到几元甚至几十元。
业务量一上来,云端订阅费用就很惊人。
一年投入很容易翻过百万。
这个数不小。
本地部署的成本优势,又重新显出来了。
数据安全的权重也在加。
不久前,海外曝出过用户数据被公开的安全事件。
一些海外闭源产品,也开始往输出里嵌隐形水印。
企业和机构对数据本地化的诉求,一直在增强。
还有一类,是智能体把闲置率压了下去。
过去一体机最被诟病的一点,就是利用率低。
上百万的设备,大部分时间在睡觉。
智能体流行之后,机器可以连续开工。
通过工作流编排,让它和业务系统深度对接。
一体机就能扛起 7×24 小时不间断的任务。
利用率自然被拉起来。
闲置少了。
真正的转折点,来自新一代模型。
大模型本身在变强。
一年一个样。
有一款开源模型性能出众,参数量却太大,很难在一体机硬件上落地。
新模型改变了这件事。
改得很彻底。
先是 DeepSeek V4.1 Flash 正式发布。
它以接近 Pro 版的能力,给出了 Flash 档的成本。
按介绍,它的性能和开销更省,推理速度和任务总耗时也更短。
模型用了全新架构,原生支持视觉理解。
关键在于,它是总参数量 552B 的混合专家模型。
552B,比上一代满血版的 671B 更小。
这意味着去年花一百五十万买的满血机,不用加一张卡就能原地升级。
能力更强,上下文也更新,模型却更小。
这才是关键。
它还和 Harness 框架联合训练过,长周期连续任务的处理能力也被强化。
另一款开源模型的走红,同样值得留意。
一款全模态生成模型在今年 7 月底发布,8 月初正式开源。
它的开源许可,明确排除了美国、欧盟,还有英国和韩国。
国内外多家芯片厂商,还有几个开发社区和云推理平台,都完成了适配。
在一份第三方榜单里,它的视频编辑能力排到了第一。
云端做 AI视频生成有多贵,不用多说。
这款模型综合能力突出,让视频的本地生成成了现实。
企业不必再那么依赖商用云端服务。
社区优化之后,它甚至能在一台消费级主机上跑起来。
大约五分钟,出一条五秒的视频。
放到一体机上再优化,输出只会更快。
还能更快。
有人测过同一条五秒、1344×768 的视频。
四张专业显卡上,原始精度的五十步方案要跑 348.8 秒,差不多六分钟。
换成一个补齐加速的方案,只要 28.7 秒。
前后约十二倍提速,耗时少了约九成二,精度还没丢。
这套玩法已经在开源平台放了出来,创作者打开就能用。
在八张专业显卡的环境下,让模型做一条十五秒、768×1344 的视频。
纯文字生成大约四十八秒,双参考图生成约七十三秒。
一条十五秒的图生视频,已经能压进一分钟。
回头看,去年上半年入手高端一体机的采购方,这轮硬件涨价里拿到了账面收益。
2026 年的市场,是两极分化的。
满血高端机的硬件成本抬升,性价比下降,只建议有刚性业务和合规隔离需求的机构采购。
而且,一体机采购从来不是一劳永逸。
除了硬件预算,机构还得持续承担机房的供电散热和运维人力。
还有模型版本迭代,加上框架调优和故障维护,这些隐性开销都躲不开。
对机构来说,一体机更像一件长期使用的 AI工具,而不是一次性采购的硬件。
不少单位只算了硬件支出,忽略了后续运维。
最后项目落地不及预期。
钱花了,活没起来。
轻量化的本地设备,则更适合本地保密诉求强、AI 能力要求不高的业务。
往后看,这个行业不会简单地越做越小。
产品分层的格局,还会继续演化。
分层已成定局。
一边是轻量设备继续下沉,覆盖更多边缘和部门级业务。
另一边,随着国产芯片和推理框架持续成熟,高端满血机的综合成本还有下探空间。
一体机赛道的竞争,比的已经不再是哪个模型参数最大。
它比的是硬件和框架。
还有模型适配、业务应用和运维服务,这一整套方案。
与其一味堆参数,不如先把整套方案跑通。
宁可把成本算全,也别只盯着采购价那一个数字。
