

生物医学这两年最热闹的场景之一,就是不断冒出来的新模型。
有人拿它预测蛋白质结构。
有人让它读懂基因组序列。
也有人想把单细胞数据,塞进一个什么都能干的模型里。
模型越做越大。任务越接越多。
排行榜上的数字,也越来越漂亮。
但很少有人认真回答一个问题。
一个模型在基准测试上拿了高分,究竟意味着什么。
2026 年 9 月 4 日,德国海森堡大学和美国纽约大学等团队,在国际期刊《Nature Methods》上发了一篇论文。
标题很直白,就叫「生物医学基础模型的基准测试」。
论文的核心判断是,老办法可能不够用了。
选几个任务,算几个指标,再排一个榜单。
这套流程对普通模型够用。
对基础模型这种什么都能沾一点的系统,就未必。
因为榜单上看到的是适配度,不是真本事。
它也许在某道题上手感很好。
换一道题,未必还能行。
怎么了解一个模型
传统机器学习的评估很直接。
准备训练集,让模型学。
再拿一份没见过的测试集,看它答得准不准。
生物医学也攒了很多这样的考试。
蛋白质结构预测有 CASP。
基因调控和系统生物学有 DREAM。
从蛋白质结构到药物发现,再到医学影像和基因组学,几乎每个方向都有自己的竞赛。
到现在,全球已经有数百个这样的挑战项目。
数字看着很热闹。
可论文提醒了一件事。
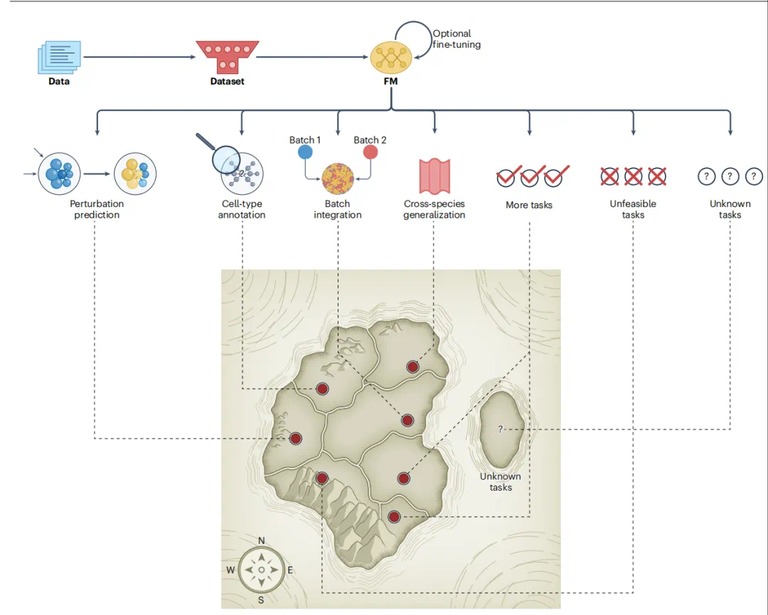
只挑几个任务去代表一个模型,就像拿地图上几个城市去代表整个大陆。
模型可能刚好适合某一道题。
这不代表它换了任务还能行。
也不代表它换了数据集和生物学场景还站得住。
这种思路,其实和 AI编程 里做单元测试是一个道理。
几个用例全绿,只能说明没踩到已知的坑。
现阶段它体现出来的,更多是某一方面的适配度。
还有很多能力,可能压根没被测到。
单细胞模型为什么难测
为了把问题说透,论文把重点放在单细胞基础模型上。
这类模型想从海量单细胞数据里,学出一套通用的细胞表示。
然后再拿这套表示去干不同的活。
理论上,它能做的事情不少。
比较不同物种,整合不同来源的数据,补上缺失的那部分信息。
还能在基因或者药物扰动之后,预测细胞会怎么变。
听起来很美。
可落到评估上就麻烦了。
不同的模型,训练数据不一样。
架构不一样。数据预处理不一样。
连预训练的目标都可能不一样。
想用一套统一的考试去量它们,自然越来越难。
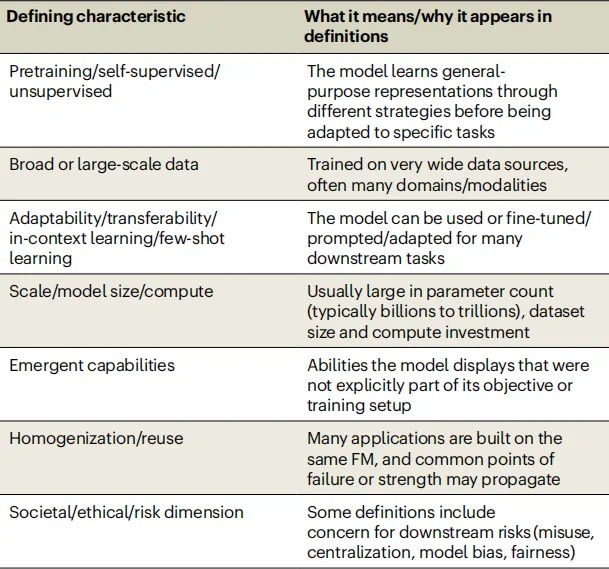
论文给出的答案是,覆盖得越宽越好。
不同的技术平台,不同的物种和器官,不同的疾病环境,不同的扰动条件。
都得放进来。
原因也不复杂。
单细胞技术本身就有系统性偏差。
同一个生物过程,换一组实验条件,数据特征可能就变了。
论文特别看重的,是扰动这一类任务。
如果一个模型能从没见过的基因或者药物扰动出发,预测细胞接下来会发生什么。
那它测的就不只是「细胞长什么样」。
它多少碰到了基因调控和细胞响应背后的机制。
这是它和普通预测任务的区别。
对很多团队来说,这类模型已经从论文里的名词,变成手边的 AI工具。
工具好不好用,得看它在多少种场景里都稳得住。
除了模型本身,人的选择也在影响分数。
同一份数据,调参方案不同,训练方案不同,最后的分就不同。
论文举了一个例子。
有人在预训练的 scGPT 上,套了一个随机森林模型。
结果在扰动探测这项上,反而比直接微调 scGPT 更好。
这个结果不太符合直觉。
但它说明一件事。
模型越大、直接微调效果越好,不是能默认的前提。
别只盯着一个数字
眼下 scFM 已经用在不少地方。
批次效应校正,细胞类型注释,数据整合,缺失值推断,多组学对齐,还有扰动响应预测。
这里有个容易忽略的问题。
一项指标做到好,不代表别的指标也好。
更何况有些指标本身就不太可靠。
扰动预测到现在,还没有一个大家都认的指标。
既不统一,也不一定真的有意义。
不同的研究,甚至能得出相反的结论。
有人说简单模型就够了。
也有人说还是基础模型更行。

论文因此提了几条改法。
基准不该只吐出一个数字。
还应该配上简单基线和对照模型。
再给一个上界参考,反映技术和生物学里那部分没法再压的变异。
另外还得做消融实验。
拆开看一看,模型到底是靠哪些数据、哪些组件拿到了这个性能。
不然分数再高,也说不清是怎么来的。
宁可多花点力气去测,也别只图一个漂亮的排名。
榜单之外,还有新麻烦
数据类型在变,这也是评估的一道新坎。
模型能力可能更宽。
但给基准带来的麻烦也更多。
论文专门讨论了一类会自己动手的系统。
它们把大模型嵌进多步骤的工作流里。
自己规划,自己推理,自己调用工具去干活。
对这类系统,老一套的对错评分不太够。
中间步骤也该给部分分。
要看的也不只是准不准。
可信度,协作能力,有没有绕开测试规则,都得算进去。
话说回来,测评的终点不该是一个超大榜单。
研究者更想做的,是一个多领域一起参与、还能持续更新的基准生态。
论文里提到了一个刚刚启动的项目,名字叫 BEACON。
它的想法,是把各个领域已经攒下的评测经验连起来。
再建立一套更标准、可复现的评价框架。
科学模型走到下一步,不该只是模仿训练数据,做一个高级复读机。
它需要更严格的考试。
也需要更全面的考试。
宁可承认还没测清,也别把没测过的部分当成会了。
只有这样,才能摸到它可泛化能力的边界。
