

一份能跑对的程序,可能只是慢。
慢到没法用。
规模一大,等待就长。
把它搬到显卡上,是最常见的想法。
听着直接。
做起来远不止换一门语言。
港科大的一支团队没有急着下结论。
他们先做了一把尺子。
要量的只有一件事:大模型能不能把一份可信的处理器程序,改写成结果正确、整体更快的显卡版本。
尺子叫 AccelEval。
这篇论文已被 NeurIPS 2026 接收。
它铺开在 6 个领域。
42 项计算任务,3 种输入规模,外加 43 类加速策略。
快不快要量。
为什么快,也要追。
这把尺子想量的不是一段能跑的并行代码。
它量的是一整条路。
读懂计算结构,找到能并行的部分,再写出一套算得对又更快的实现。
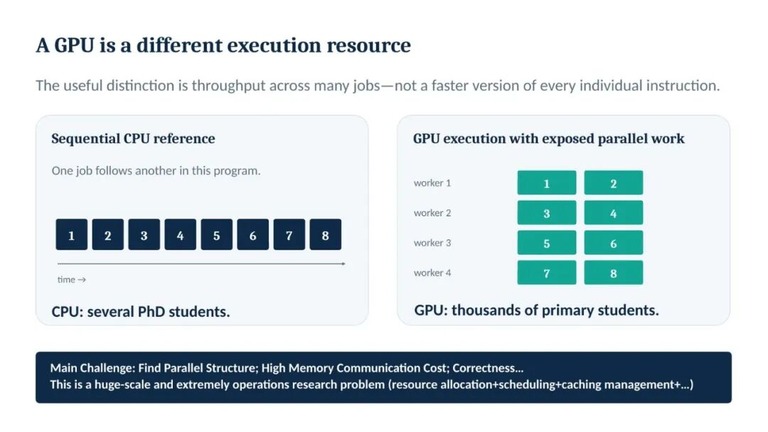
博士生和几千个小学生
先把这件事讲清楚。
一边是几个博士生。
另一边是几千个小学生。
复杂、需要灵活判断的活,交给前者。
规则明确、能拆开的活,交给后者。
处理器(CPU)像那几位博士生。
显卡(GPU)像那几千个小学生。
它的本事,是让大量成员同时干同一类活。
听着很爽。
现实里的程序没这么整齐。
有的题要等前一步的答案。
有的任务会同时去改同一个结果。
还有些时候,发题和收答案花的时间,比解题本身还长。
最短路径就是个好例子。
一个起点到其他地点的最短距离,一种算法是反复检查每条路。
固定上一轮的距离,每条路就能同时算自己的候选答案。
可通向同一地点的候选答案必须先取最小值。
下一轮也得等本轮算完。
数据最好一直留在显卡上,别每轮来回搬。
别把显卡只当成一个更快的处理器。
它换的是一整套分工方式。
算得快 10 倍,用户却可能多等
就算模型写出了一个很快的显卡内核,用户也未必更早拿到结果。
举一个假设的例子。
先看数。
这活处理器上跑完要 10 毫秒。
换到显卡,核心计算只花 1 毫秒。
准备和输入搬运花了 6 毫秒。
收尾和输出搬运又花了 6 毫秒。
光看核心计算,像是快了 10 倍。
用户实打实等了 13 毫秒。
比原来还慢。
差距就在这。
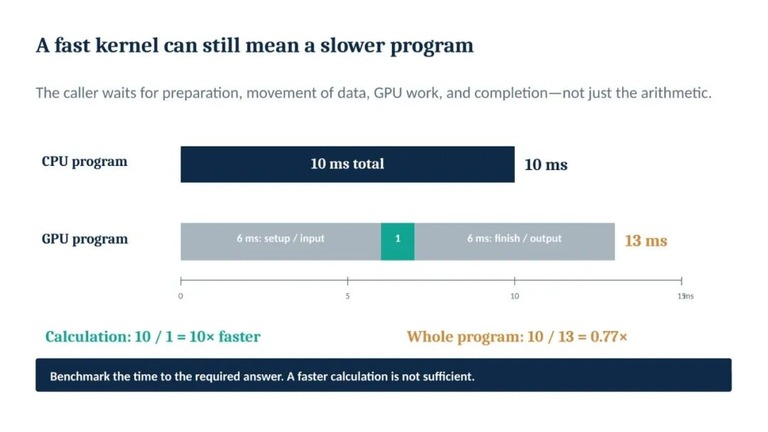
与其盯着那一段数字,不如看用户到底等了多久。
所以 AccelEval 把「端到端」放在中心。
每个任务都从统一入口收输入、返输出。
中间的内存分配和数据传输都算数。
计算和清理也一样。
评测还设了审计,检查有没有把该算的活藏到计时之外。
用户要的不是某一段代码更快。
而是同一个任务,从输入到答案,真正少等一会儿。
从「谁更快」到「为什么快」
这个方向并不新。
KernelBench、TritonBench 这些基准早就在做。
它们让大模型照着算子生成显卡实现。
问题在于,深度学习里的常见算子太规整。
矩阵乘和归一化,卷积也一样。
这些活有成熟的并行范式。
开源框架和代码仓库里铺满了现成写法。
模型做得好,可能只是见过太多遍。
那碰上没有现成模板的程序呢。
这是 AccelEval 想回答的。
42 项任务铺开在 6 个领域。
高性能计算和科学仿真占一块。
图算法、时空算法各占一块。
金融计算也在里面。
运筹优化同样是重点。
有路径计算,有粒子仿真,也有期权定价。
还有多周期库存补货和网络收益管理。
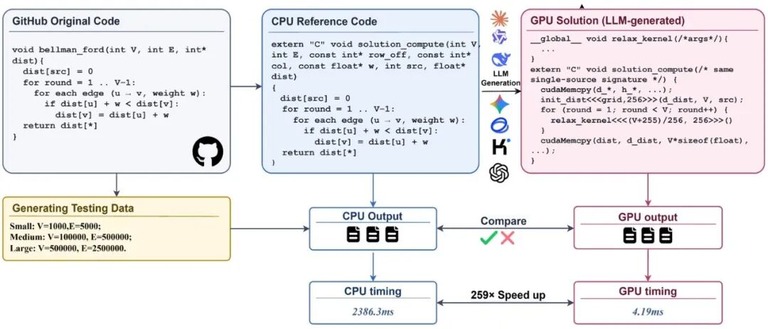
每个任务给一份自然语言说明、一份处理器参考实现和一个固定接口。
输入分 3 档规模。
提交的显卡版本先要能编译、能跑通。
再用同样的输入,和处理器结果逐一比对。
数值敏感的任务,允许预先定好的误差。
先算对。
再谈快。
研究在 H200 上测了 8 个大模型,也在一张消费级显卡上做了跨硬件测试。
设置是每个任务只生成一次代码。
中规模下,谷歌的 Gemini 3.1 Pro 在通过正确性验证的任务上,拿到了 71.2 倍的几何平均加速。
大规模下是 161.5 倍。
数字好看,条件也要看清。
加速比只统计通过的任务。
对照的处理器实现,是统一的单线程版本。
更值得注意的是,模型之间的能力轮廓并不一样。
有的能写对更多任务,却不一定让它们跑得更快。
有的实现已经通过测试,仍然没把并行资源用满。
只看答对多少题,说不清显卡加速这件事。
是两码事。
研究因此同时看三样:正确性覆盖、整体加速,还有离「本次评测中最好的正确实现」还差多远。
11 个有人工基线参照的任务里,逐任务挑出最快的正确方案,跨任务几何平均约为 0.75。
自动化的进展和尚待补的差距,摆在同一条尺子上。
很清楚。
最后一块,是「为什么快」。
如果评测到排名就收,我们只知道谁更快。
知道不了下一步该改哪里。
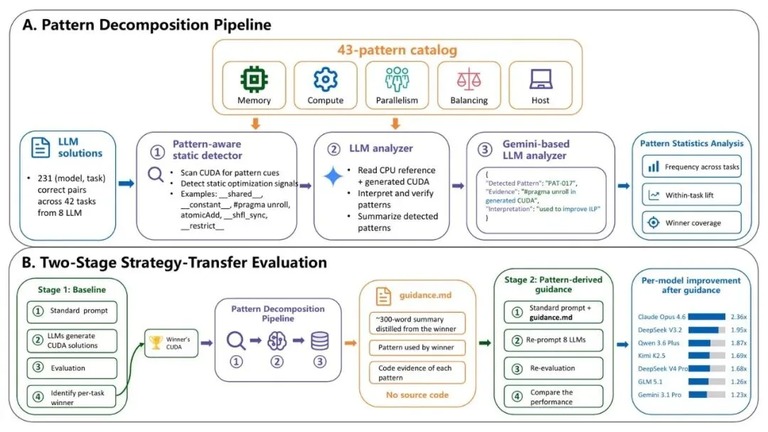
研究把通过验证的显卡代码拆成了 43 类策略。
内存访问与复用是一类。
计算重构、并行组织各是一类。
负载平衡和主机端协调也算。
静态代码检测加上大模型分析,一共拆解了 231 个「模型加任务」组合。
把性能数字和代码做法对应起来。
这些策略不是几个编译选项。
内核融合能把相邻阶段合并,少读写、少启动。
共享内存分块让一组线程复用已经搬到片上的数据。
换个数据布局,调整循环顺序,可能就改变了这项活在显卡上的分工。
研究还看到一个偏向。
内核融合、分块这类结构性做法,和更好的性能关系更强。
只抠单个内核里的细节,收益往往不高。
这份目录的价值,是把一次次试错里隐含的经验显式留下来。
不只记哪个实现更快。
也记它为什么更快,用了怎样的计算组织。
过去几年,大模型已经不断刷新人们对机器能思考到什么程度的想象。
会做题,会写代码,会证明定理。
真正值得期待的,也许不是它还能答对多少题。
而是这些本事什么时候走出屏幕,进入真实的生产流程。
如果未来的模型不只会生成代码,还能像工程师一样理解系统,找到瓶颈,把经验攒下来,那它带来的改变就不只是「帮人完成任务」。
它开始参与计算、工程乃至整套系统的演进。
对每个用 AI工具 的人来说,能感受到的变化其实很朴素。
事情早一点办完。
等待少一点。
这也是 AI对话 正在改写的地方。
过去我们习惯的一问一答,更像一台随时在线的答录机。
AI编程 大概会是最先用上这把尺子的场景。
活多,步骤长,来回确认也多。
一把好尺子,量的不只是机器跑得多快。
它也决定了下一步该往哪里使劲。
AccelEval 想探的,就是这下一步。
Gemini会员中转站 微信:douhanq
