

先想象一个很日常的画面。
桌上有只机械臂。
旁边放着一个方块。
它要把方块抓起来,放到另一处。
抬臂。
伸爪。
合拢。
这些动作它早就练过成百上千遍。
真正难的是最开头那一下。
从哪个姿势起手,往哪边偏一点。
偏多了,后面就全乱了。
这其实是机器人模仿学习里,一个长期被绕开的问题。
起点到底该是什么
先说说机器人的动作是怎么生成的。
研究者给机器人看大量人类示范。
每段示范都是一串动作。
模型要做的,是学会这套动作的分布。
然后在新的场景里,自己采出一串动作来。
现在主流的做法有两类。
一类叫扩散模型。
一类叫流匹配模型。
名字不同,思路相近。
都是从一个起点出发,一步步去噪或者推进,最后得到一串动作。
问题就出在这个起点上。
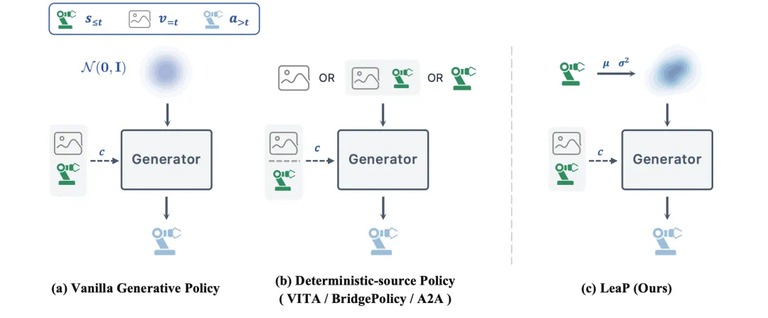
绝大多数方法,用的是标准高斯噪声。
也就是一团完全不看现场情况的随机数。
为什么这样也行得通。
因为后面的生成器会逐步把它修正回来。
可如果起点本身就偏得很远,修正的负担就重了。
近两年有些工作开始换思路。
它们用机器人自身的姿态信息,或者摄像头看到的画面,去构造一个更聪明的起点。
但这些做法通常只给一个确定值。
它们默认自己算出来的起点是对的。
却没考虑到,这个估计本身也会出错。
于是这篇论文抛出一个更细的问题。
动作生成的起点,应该是一个确定的点,还是一个分布。
如果是一个分布,方差不该固定,是不是应该跟着机器人的状态变。
把“起点”交给模型自己学
针对这个问题,东南大学的一支团队提出了一个新方法。
他们给它取名 LeaP,中文可以理解成“可学习的源先验”。
思路很直接。
把原来那个固定的标准高斯起点换掉。
换成由机器人本体感知信息驱动的分布。
具体怎么算。
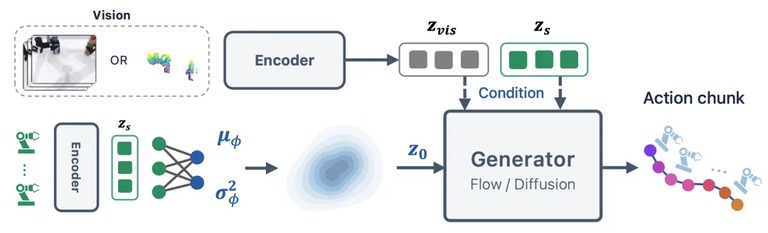
他们把机器人当前的姿态特征,喂进两层小网络。
网络输出两个东西。
一个是均值,一个是方差的对数。
有了这两个量,就构造出一个对角高斯分布。
均值决定起点落在哪儿附近。
方差决定在这个位置周围散得多开。
关键在于,这两个量都随着机器人的状态实时变化。
采样的时候也不复杂。
拿一团标准噪声,逐维缩放,再加上预测出来的均值。
这样得到的起点,就已经带着现场信息了。
训练和推理都保留这个随机采样过程。
一段动作里的各个时间步,共享同一组分布参数。
但每一步都独立采样。
更细的时序关系,交给后面的生成器去学。
这样分工有个好处。
先验只负责看机器人自己的状态。
生成器同时看画面和姿态,负责把动作打磨到位。
两边的活不重叠。
已有的生成器也能直接接上,架构和求解器都不用动。
这套思路和 AI编程 里常见的一件事很像。
与其把每一步都写死,不如让模型自己学一个更合适的起点。
训练用了三个目标一起优化。
第一个管流匹配,学习怎么把源样本变换成示范动作。
第二个是负对数似然,盯着先验那组分布别跑偏。
第三个做对比对齐,让源样本和配对的示范动作在特征空间里靠得更近。
三项损失一起回传,先验和生成器端到端地练。
十五项任务,成功率 81.6%
效果先在仿真里验证了一遍。
团队选了一个双臂操作仿真平台,挑了 15 项任务。
覆盖抓取放置,工具使用,以及双臂协同。
每项任务只给 50 条示范。
每个随机种子跑 100 次,最后报 3 个种子的结果。
所有方法用的都是同一套点云编码器。
这样比出来才公平。
结果里最扎眼的是那组对照。
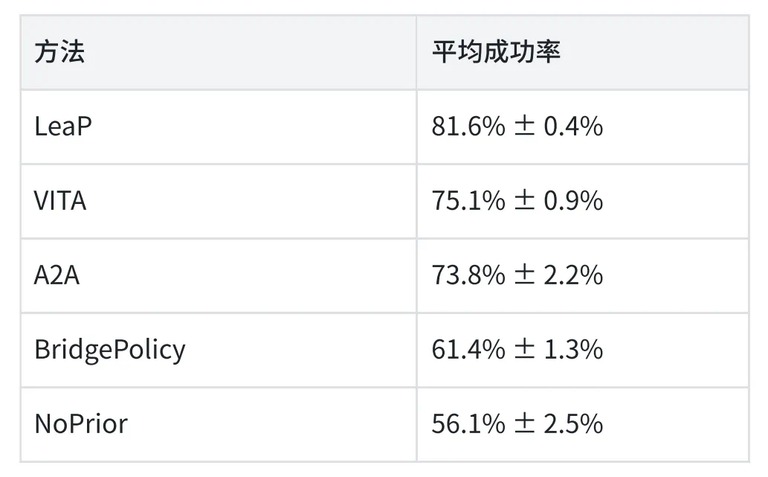
有一个不用先验的基线,它跟新方法共用同一套编码器和生成器。
区别只在起点是不是可学的。
两者的平均成功率差了 25.5 个百分点。
最终这套方法拿到 81.6%。
那两个用确定性起点的已有做法,也都被超过了。
一个差了 6.5 个百分点。
另一个差了 7.8 个百分点。
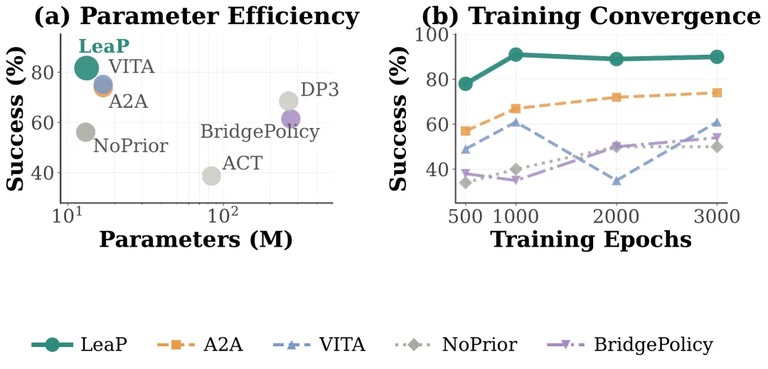
模型本身也不大。
全套参数 1322 万。
其中新加的先验头只有 21 万左右。
占比不到 2%。
像插在生成器前面的一件 AI小工具。
它还顺带改善了训练效率。
在打开笔记本这一项任务上,只练 1000 轮就到了 91% 的成功率。
这个成绩,比几个主要基线练 3000 轮之后还要好。
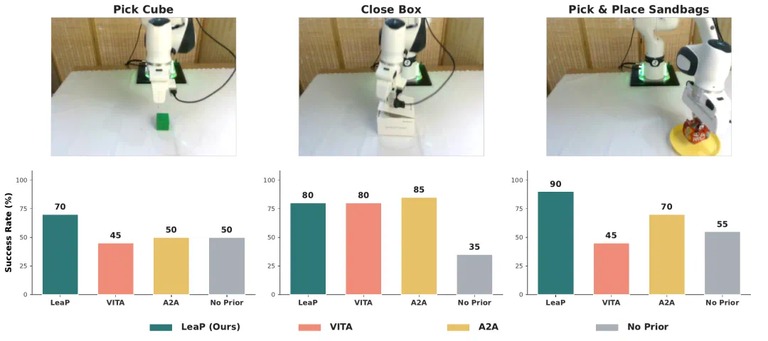
这套趋势在真机上也成立。
团队换了一台研究型机械臂。
给它安排了三项任务。
抓取方块。
关闭盒子。
抓取并放置沙袋。
每项任务先用 100 条遥操作示范。
测试时随机摆放物体位置,每项跑 20 次。
新方法的平均成功率是 80.0%。
对比之下,两个已有做法分别是 68.3% 和 56.7%。
不用先验的基线只有 46.7%。
也就是说,相比基线提升了 33.3 个百分点。
消融实验:光有随机性还不够
光看结果不足以说明问题,团队又做了几组消融。
他们想弄清三件事。
先验该看什么信息。
先验该用什么形式。
先验该接受什么监督。
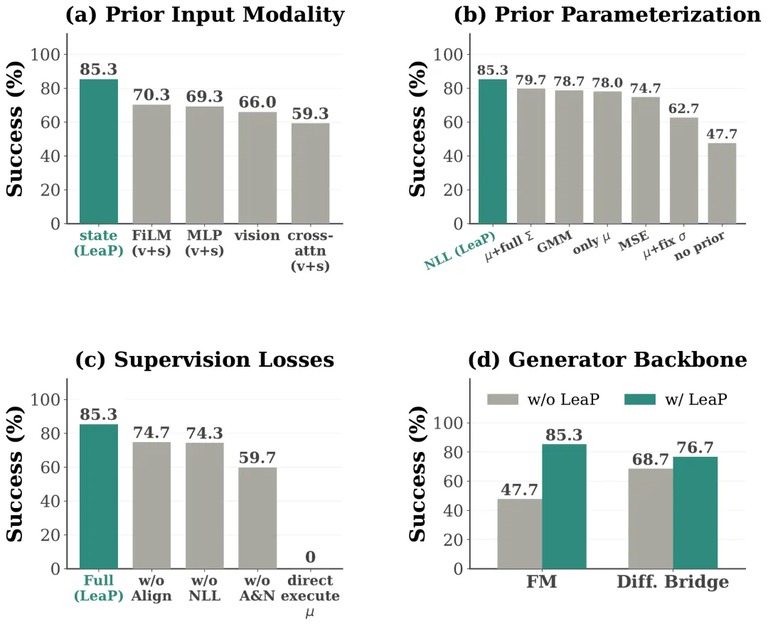
先说输入。
保持生成器看到的信息不变,只换先验的输入。
只用机器人自身姿态的那版,平均成功率 85.3%。
换成视觉,或者视觉和状态融合,成绩掉到 59.3% 到 70.3% 之间。
三种融合方式都没能扳回来。
这说明掉分不是某一种融合特有的毛病。
可视化也给出了解释。
只看姿态的先验,把样本放在了目标动作附近。
而掺进视觉特征的那些变体,反而容易跑偏。
这恰好印证了两边的分工。
先验看状态,负责把起点定在合理的位置。
生成器再看画面,负责把动作细化。
再说形式。
所有可学习的先验,都比固定高斯基线强。
但在这组实验里,表达能力更强的全协方差高斯,还有高斯混合模型,都没有超过对角高斯。
更关键是一组三方对照。
只学均值,成功率 78.0%。
在均值上加固定方差为 1 的噪声,反而掉到 62.7%。
把均值和状态自适应方差一起学,才到 85.3%。
结论很清楚。
有随机性不等于有用。
噪声的幅度得跟着状态走,才真正帮上忙。
最后说监督。
只靠流匹配损失练先验,平均成功率 59.7%。
比没有先验的 47.7% 高一截,但离完整模型还差得远。
补上显式监督就不一样了。
去掉对比对齐,掉到 74.7%。
去掉似然监督,掉到 74.3%。
一个盯条件密度。
一个约束特征空间里的对应关系。
两个信号互相补位。
团队还验证了通用性。
同一套先验,让流匹配的平均成功率从 47.7% 提到 85.3%。
在另一种生成器里,相比只用均值当起点,带上完整分布的版本把成功率从 68.7% 提到 76.7%。
前者说明换掉标准高斯起点本身就有收益。
后者说明,即便已经有了跟状态相关的均值,再学一个自适应方差仍然值得。
这支持把源分布当成一个可复用的模块。
它和生成器的设计,是相互补充的两件事。
这几组对照里,其实藏着两次取舍。
与其堆更多视觉信息,不如先把机器人自己的状态吃透。
与其指望把噪声调大来制造多样性,不如让模型学会什么时候该稳,什么时候该散。
论文本身也没回避局限。
目前的验证集中在桌面操作。
对角高斯也没有显式建模动作各维度之间的相关性。
更复杂的先验形式。
还有更多机器人形态。
都还等着被探索。
回到最开始那只机械臂。
它要抓那个方块,还是得从某个起点出发。
区别在于,这个起点不再是一个拍脑袋的定值。
它是模型根据当下的姿态,临时算出来的一个分布。
往哪边偏,散得多开,都跟着状态走。
论文没有把这件事说得天花乱坠。
它只是把起点,从一个被忽略的常数,变成了一个可以学的东西。
就是这一个小改动,让一堆本来就成熟的生成器,成绩跟着往上走了一截。
说到底,这只是给机器人增加了一件 AI工具。
但这件工具的分量,可能比它 21 万的参数量重得多。
