

当下,具身智能的商业化路线撞上了一堵墙。
这两年的机器人演示一场比一场好看。视频里的人形机器人翻个跟头,顺手把桌子收拾干净。可一进真实场景就露怯。北大与 BeingBeyond 联合发布的 BeTTER 基准,把这层窗户纸捅破了。
最先进的 VLA 模型,在标准静态测试里表现还行。一旦引入空间布局偏移,或者把时间轴往外推一点,成功率就断崖式下跌。斯坦福大学另一项研究把病因定得更细。在接触密集的任务里,这类模型有两个互相独立的失效模式。一个是精度失效。一个是力失效。
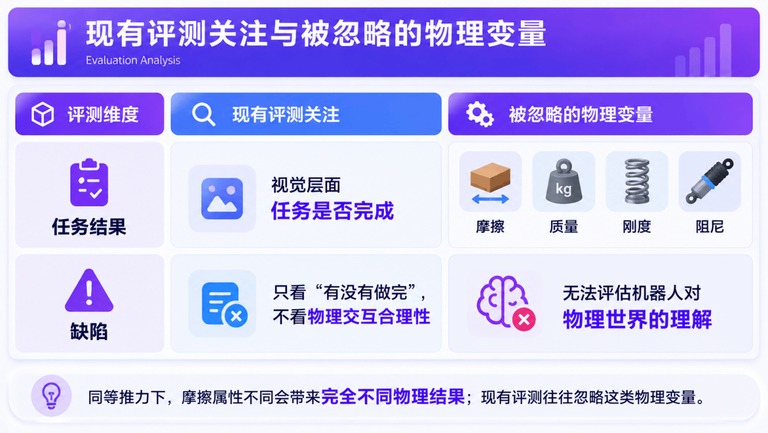
图注:现有评测盯着任务有没有完成,物理变量基本被漏掉了。
换个说法,这类模型驱动的机器人只知道“看到杯子就该抓”。它不知道杯壁有多薄。摩擦力够不够,它没概念。注水之后重心会不会偏,它同样算不出来。它本质上是统计学的模仿者,不是物理世界的参与者。
这个毛病被反复暴露之后,世界模型就成了具身智能跨过商业化奇点的新说法。
一家杭州公司,给机器人补了堂物理课
9 月 26 日,杭州美梦空间科技有限公司在第五届全球数字贸易博览会上首发了两项成果。

图注:美梦空间在展会首发首秀主舞台上公开这两项成果。
一项是 Physical-WAM 物理世界动作模型。按这家公司的说法,它是全球第一个带物理感知能力的世界动作模型。另一项是 RoboTwin-Phys 物理漂移评测基准。它也是业内第一个把物理扰动当成核心评测对象的机器人操作基准。
两件东西的分工很清楚。前一件负责让机器人懂物理,具备接近人类的预判能力。后一件负责验证它是不是真的懂了。
美梦空间的底子不算薄。它由北京大学信息技术高等研究院高文院士领衔的先进视觉系统研究中心孵化。核心团队长期做具身智能、视频编解码和空间计算。2026 年 8 月,A 股上市公司索辰科技完成了对它的独家种子轮战略投资。两边开始在数据、算力和物理 AI 上深度协同。这份答卷就是双方一起交出来的。
缺的不是算力,是训练信号的源头
具身智能往前推,第一个撞上的其实是数据。
视觉和大语言模型拿训练样本的边际成本很低。网页文档能抓。图片能抓。视频也能抓。抓完标注一下就能用。
机器人物理交互数据的生产逻辑完全是另一回事。有效的物理交互样本,只能诞生在真实或者高保真仿真的接触过程里。抓取算一次。推拨算一次。按压也算一次。每一次有效交互,都伴随真机运动、接触反馈和物体状态的改变。
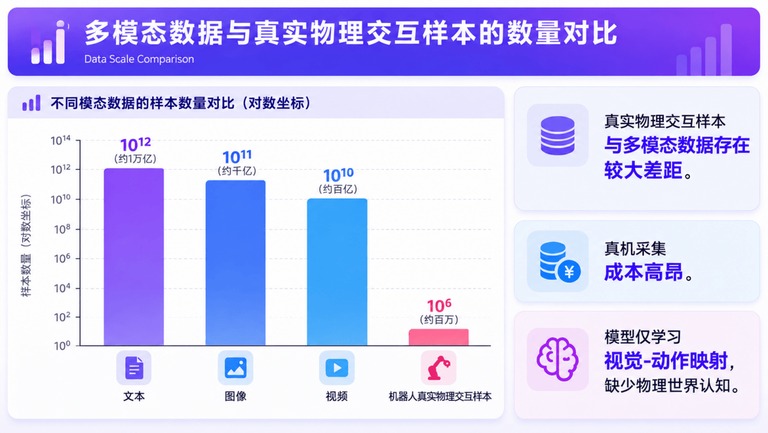
图注:机器人物理交互样本的数量,和多模态数据差着好几个数量级。
这类数据的采集周期长。硬件损耗的成本高。换一个机器人本体,数据往往还得重来一遍。迁移的壁垒很明显。
结果是一个很硬的现实。机器人能用的真实物理交互样本,一直停在百万量级。文本和图像领域早就到了数十亿量级。两边差了好几万倍。
在感知和动作之间,插一层物理表征
面对这个约束,美梦空间给出的解法就是前面那套模型。
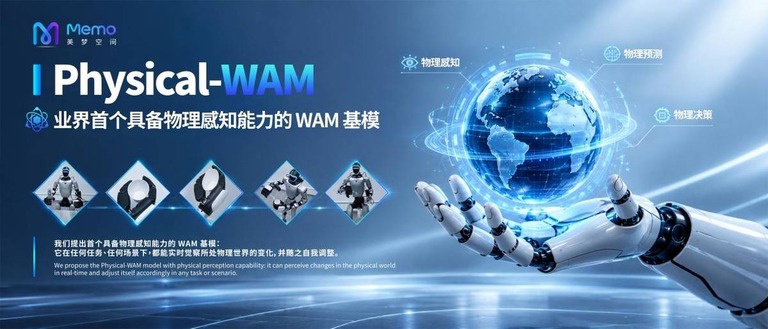
图注:这套模型的概念图。
它的核心设计,是在感知信号输入和动作输出之间,插一层“物理词元”表征。
传统世界模型的中间表征是像素,或者隐空间向量。它能推演物理世界会怎么演化。可它感知不到物理本身。知道下一帧画面会变成什么样,却不知道为什么变成这样。
Physical-WAM 把可观测数据和深层物理数据一起用上。它在真实任务里能实时觉察物理变化,预判动作后果,顺手修正行为。整套模型由三个模块组成,形成一条从感知到修正的反馈链条。

图注:三大模块的架构图。
第一个模块是物理翻译器。它从多模态感知信号里提取摩擦与重量,也提取重心与接触状态。这些量本来没法直接观测。它输出统一的物理词元表征。
对照着看,现有的做法学到的只是反应式映射。模型知道什么时候该伸爪。也知道什么时候该松手。它却不显式推断物体有多重,表面是不是湿滑。翻译器要补的正是这层显式估计。
第二个模块是物理预言家。它结合当前的物理表征、环境状态和候选动作,推演未来的物理状态。打滑或者脱手这类风险,它提前给出评估。
第三个模块负责物理条件化的动作生成。环境一旦发生物理漂移,它自动调整执行策略。
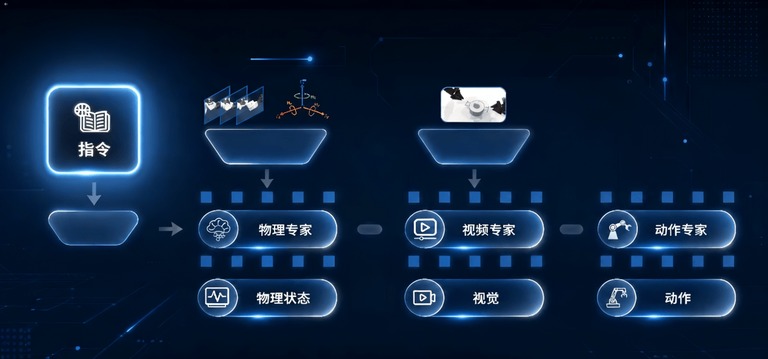
图注:三个模块的数据流,指令从视频专家传到物理专家,再传到动作专家。
举个例子。机器人抓一只纸杯。翻译器识别出纸杯的低刚度特性。预言家算出注水之后负载增加,杯壁可能形变甚至滑脱。生成模块据此调整抓握力度和接触位置,在注水过程中持续修正,直到把活干完。
这不再是动作复现。它更像人的物理直觉。
一把新的尺子,量的是物理适应度
技术路线的竞争,最后总要用评测来裁决。与其在旧标尺上抢那零点几个百分点,不如先换一把能量物理的尺子。
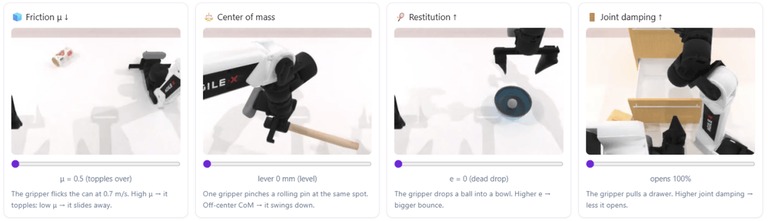
图注:美梦空间用来测试机器人物理理解力的一组场景。
现有的具身智能评测基准有个结构性盲区。它们量的是任务完成度,不是物理适应度。一个模型可以在固定摩擦系数和固定物体质量的测试集上刷出高分。物理参数一扰动,它立刻没有鲁棒性。
同等推力下,高摩擦的罐子会原地倾倒。低摩擦的罐子直接滑飞。夹持擀面杖的同一个位置,重心一偏杆体就摆。这些现实里司空见惯的物理漂移,传统测评很难验证。一项能力没法度量,模型的迭代就失去锚点。
所以第二个答案是一把新尺子。它遵循三层递进逻辑。物理属性推断得准不准。物理扰动下任务还成不成。性能差距的上界在哪里。
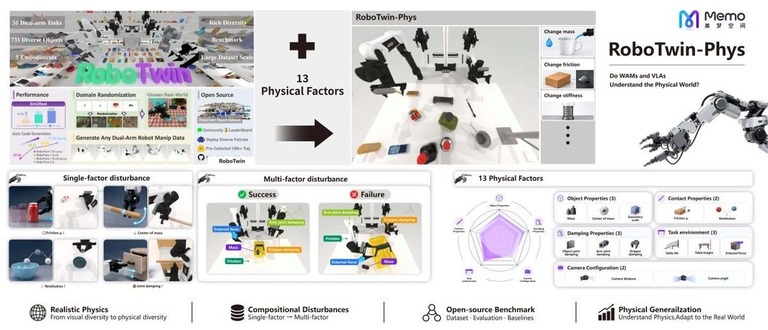
图注:物理漂移评测基准的概念图。
它在原有的机器人操作基准上加了一批真实世界常见的物理扰动因素,一共 13 类。物体属性算一维。接触属性算一维。阻尼、任务环境和相机配置各算一维。单因素扰动能测,多因素组合也能测。
工程价值主要落在三个地方。它提供物理真值。物理值有记录。接触力有日志。物体运动学数据和失败时间线也一并给出。评测因此不只回答成没成功,还能追问模型估计得对不对,从哪一步开始失败。
它还做固定种子配对评估。不同模型面对完全相同的扰动实例,运气成分被压低。
最后是按推断准确性、任务成功率和性能上界逐层递进。这把两种失败区分开了。一种是物理状态识别错了。另一种是识别对了但动作没跟上。等于在链条的每一环各设了一个考位。
这套基准发布即开源。项目代码、数据集和排行榜全部开放,支持第三方验证复现。宁可先把物理变量测准,也别急着把分数往上顶零点几个百分点。
世界模型本身仍是一个没有收敛的概念。学术界至今没有统一的技术定义。
计算机视觉圈把它理解成 AI视频 生成的一个分支。机器人领域把它当成状态预测器。强化学习圈则把它看成环境代理。
毕马威今年 7 月发布过一份报告,给了一个更清晰的坐标系。表征式世界模型回答世界是什么。生成式世界模型回答世界会变成什么。交互式世界模型回答改变世界会发生什么。把理解、生成和预测揉成一体化的那类,则想回答怎么理解,怎么预测,又怎么自主改变世界。
美梦空间这套架构探索了一条可行的路径。它自己也承认,能力边界还在往外推。
第一是物理词元的粒度边界。摩擦、质量和重心是三个高度抽象的参数。真实接触里还有表面粗糙度的各向异性,还有材料的非线性弹性行为。当前表征能力的上限,得靠更系统的消融研究来回答。
第二是跨本体的迁移效率。同一个物体,二指夹爪和灵巧手抓取所需的策略并不一样。物理参数到动作的映射,高度依赖末端执行器的形态和动力学特性。多本体适配的一致性,是检验架构泛化能力的关键。
第三是仿真物理的保真度天花板。推演精度受限于仿真引擎的保真度和真实传感器的噪声。织物的大变形、颗粒材料的流动,这些效应仿真未必建得出来。
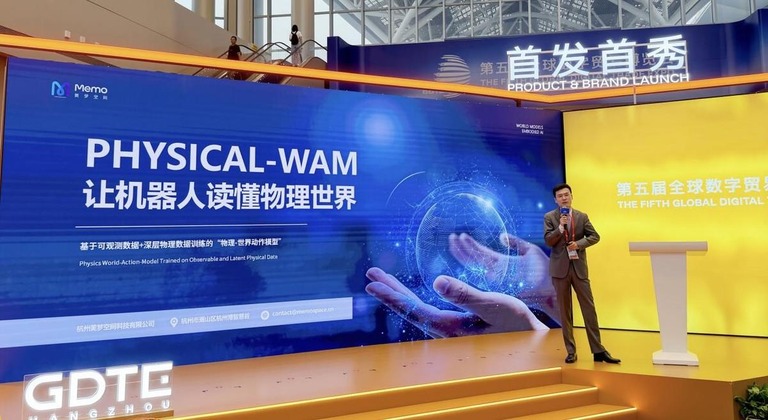
图注:美梦空间 CEO 李明昊在展会现场介绍这套模型。
围绕这些方向,美梦空间的下一步是持续迭代多模态物理表征模型,扩充交互数据集,优化推理延迟和多本体适配。它还想联合产业链上下游,把物理数据、世界模型和评测标准三块拼图补齐。
对做具身智能的团队来说,眼下缺的从来不是算力,也不是新款 AI工具。缺的是能被量化的物理反馈。这条最难的路,总得有人先走一段。
“只有让机器人真正读懂物理世界,具身智能才能从实验室走向真实产业场景。”美梦空间 CEO 李明昊说。他给这件事留了一个说法,叫具身智能的 GPT 时刻。
