

25GB 内存的笔记本,跑起了 744B 的大模型。
还是没有显卡的那种。
做到这件事的项目叫 Colibrì,意大利语里是蜂鸟。
它在代码托管平台上攒到 3.2 万星标,纯 C 写的,不带任何推理引擎依赖。
整包只有几百 KB。
这类硬核 AI工具 能火,靠的不是参数表,而是戳中了一个最普遍的麻烦。
手里没有显卡。
项目主页:3.2 万星标、纯 C 实现,仓库里放着引擎与启动脚本
它最早是冲着 GLM-5.2 来的。
按常规思路,744B 的参数规模已经劝退了几乎所有家用电脑。
Colibrì 的办法相当粗暴。
内存装不下,那就别全装。
模型里暂时用不到的权重,直接扔进固态硬盘。
等推理真的需要某个专家,再从盘里现场捞出来。
GLM-5.2 经过 4 比特量化之后,权重大约 372GB。
于是最低 16GB 内存就能起跑,推荐配置 24GB。
显卡不是必需品。
作者最早做验证的那台开发机,只有 12 核处理器加 25GB 内存。
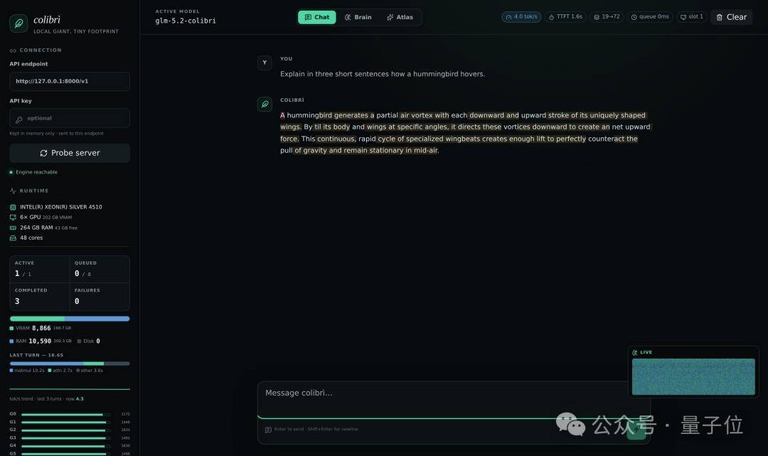
运行时面板:4.0 词元每秒,首词延迟 1.6 秒,Chat 与专家视图可切换
它现在不满足于 744B 了。
能跑的模型扩到九个家族,最大的一位是月之暗面的 K3,总参数 2.8 万亿。
那套权重要占掉 1.6TB 硬盘。
内存 32GB 起步就能跑,同样不强制要求显卡。
744B 的模型,内存里只放 10GB
这个项目敢这么玩,得先谢谢这两年越来越流行的混合专家架构。
拿 GLM-5.2 举例。
整个模型确实有 744B 参数。
但混合专家架构不会在生成每个词元时把 744B 全算一遍。
它会先让路由网络做个判断,这个词元该交给哪些专家处理。
真正被激活的只是一小部分。
GLM-5.2 每个词元实际参与计算的参数,大约 40B。
剩下的绝大部分,此刻根本用不上。
可这些用不上的部分,一直占着昂贵的高速内存。
于是 Colibrì 把模型拆成了两半。
常驻的一半是注意力模块、词嵌入和共享专家,这些每次推理都要用到。
加起来大约 17B 参数。
量化到 4 比特之后只占约 10GB,直接住在内存里。
真正占地方的是另一半,那些庞大的路由专家。
这一半有多少个,19456 个。
即便压到 4 比特,整体仍然要占大约 370GB。
这么大的体积,普通电脑的内存显然塞不下。
Colibrì 索性把它们全部放到固态硬盘上。
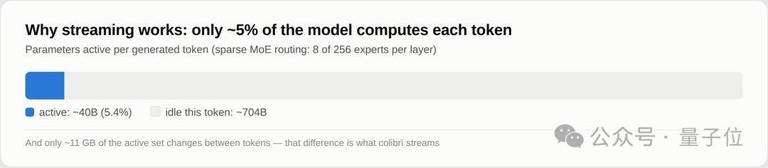
单次生成的参数占用:总量 744B 里只有约 40B 参与计算,其中约 11GB 随词元变化
模型开始生成词元之后,路由网络先挑出这一轮真正要参与计算的专家。
这个项目再检查它们是否已经在高速内存里。
没命中的部分,才临时从硬盘读进来。
算完这层,再处理下一层。
以前跑大模型的思路是先想办法把模型装进内存,然后才开始算。
它把这件事倒了过来。
需要什么就先加载什么。
作者把它类比成一种针对模型权重的即时编译。
AI编程 里常见的懒加载,其实是同一个念头。
传统即时编译不会一上来就编译整个程序,而是看哪些代码真的在跑,再处理热点路径。
这套逻辑被搬到了权重调度上。
744B 参数不再被当成一个必须整体驻留的庞然大物。
它变成了一堆数据。
这堆数据按路由结果,在硬盘、内存和显存之间来回搬。
硬盘被当成了显存
如果每生成一个词元都要去硬盘里现找专家,那这块盘估计得读到怀疑人生。
事实也是如此。
最早那台开发机的配置是 12 核处理器加 25GB 内存。
冷缓存状态下,它只有 0.05 到 0.1 词元每秒。
跑是能跑,就是慢得让人耐心见底。
宁可慢成这样,也比根本跑不起来强。
所以接下来要解决的问题很具体。
怎么少去硬盘里捞专家。
怎么让硬盘、内存和显存协同起来。
这个项目把三种存储组织成了一套分层的模型内存系统。
原则只有一句,越常用的专家,住得越近。
已经待在显存或者内存里的专家,直接计算。
刚刚用过的专家,尽量继续留在内存缓存里。
真正不常用的那些,才继续躺在硬盘上,等需要时再读。
为此它先加了一层最近最少使用的缓存机制。
最近被调用过的专家会优先留在内存里。
后面的词元再点到同一个专家,就不用重跑一趟硬盘。
同时它还会在运行过程中记录每个专家被用了多少次。
跑得越久,哪些专家是常客就越清楚。
高频专家会拿到更高的缓存优先级,被尽量留在更快的存储层。
更有意思的是,它不会等路由网络点完名才动手。
根据项目测试,相邻层之间的专家路由存在相当明显的相关性。
提前一层预测专家的准确率能到 71.6%。
于是这一层还在算的时候,后台已经去读下一层可能要用的专家了。
一边算一边读,原本串行的计算和硬盘读写被尽可能重叠起来。
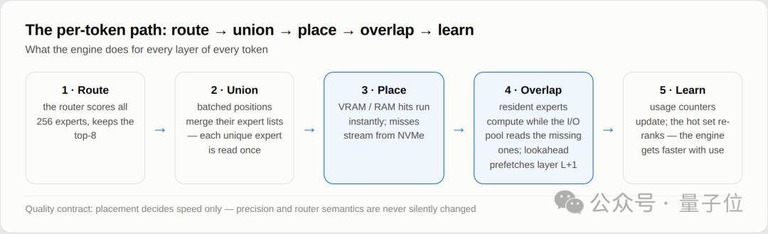
每个词元的处理路径:先路由,再取并集,然后放置,接着重叠,最后学习
硬盘本身也还能继续堆。
机器里如果正好有两块固态硬盘,它可以放第二份模型副本。
读取任务分摊到不同盘上,就能并行吃两块盘的带宽。
这一套下来,更像是在给混合专家模型做权重分级调度。
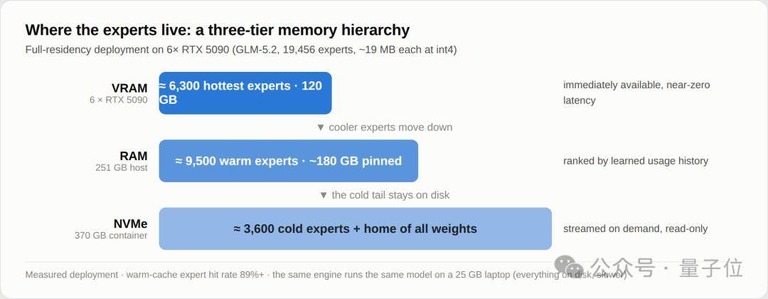
专家住在哪里:显存、内存和硬盘三级存储的分布示意
容量最大、速度最慢的硬盘负责兜底。
内存负责缓存更多常用专家。
如果有显卡,显存则继续接住最适合放进高速存储的那部分。
哪里快,就把最常用的权重往哪里搬。
哪里大,就负责装下剩下的模型。
开发者把这套思路叫作 AI 内存多层化。
这里有一条设计原则很关键。
专家放在哪一层,只决定速度,不改变模型本身。
一个专家无论待在显存里,还是临时从硬盘读进来,路由网络的选择都不会因此改变。
用的权重精度也完全相同。
它不会因为你的内存少,就偷偷少算几个专家。
到了 128GB 内存的纯处理器桌面机,能缓存的专家更多。
速度可以到约 1.8 词元每秒。
如果一路堆到六张高端显卡,让全部专家常驻高速存储层。
解码速度能来到 5.8 到 6.8 词元每秒。
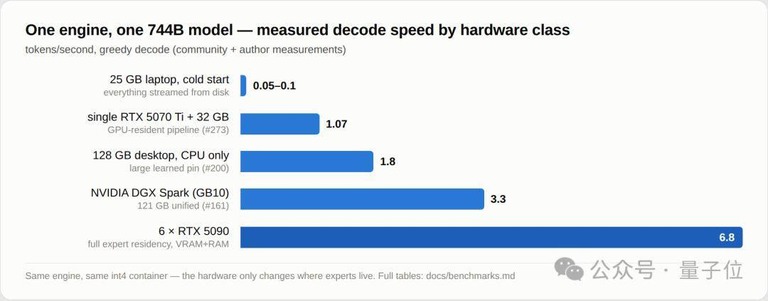
按硬件档位实测的解码速度:25GB 笔记本冷启动只有 0.05 到 0.1 词元每秒
跑前沿大模型,不一定非要用机房里的服务器。
想自己跑一遍,要准备的东西只有两样
一是几百 KB 的程序。
二是大约 372GB 的模型。
这个项目已经放出了预编译版本,主流桌面系统都有。
不想折腾编译的话,下载解压就行。
想从源码开始,也只要有个带 OpenMP 的编译器。
模型那边同样省事。
已经转好的 4 比特版本可以直接下载,也能从更高精度的原始模型自己转。
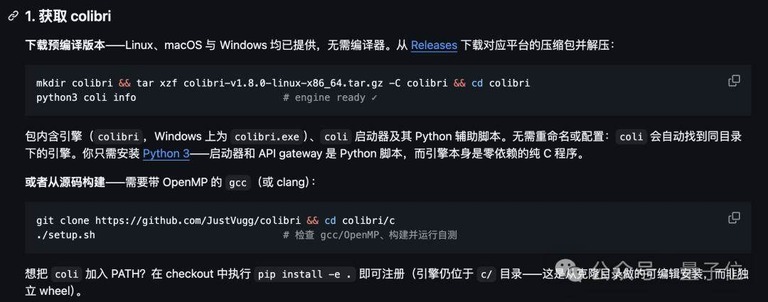
第一步:下载对应平台的压缩包并解压,再用一条命令确认引擎就绪
权重放好之后,一条 coli 启动命令就能进 AI对话。
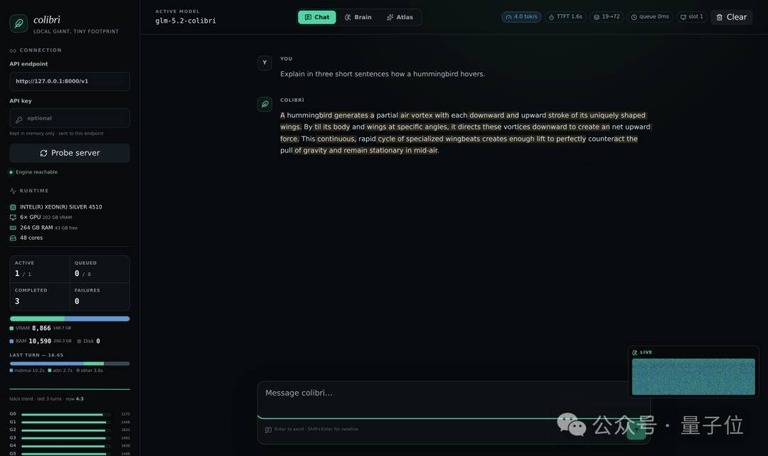
对话界面:可以边聊边看当前激活的模型与首词延迟
想更直观一点,可以直接打开网页控制台。
里面能实时看到生成速度,各阶段耗时,还有此刻有多少专家待在显存、内存和硬盘上。
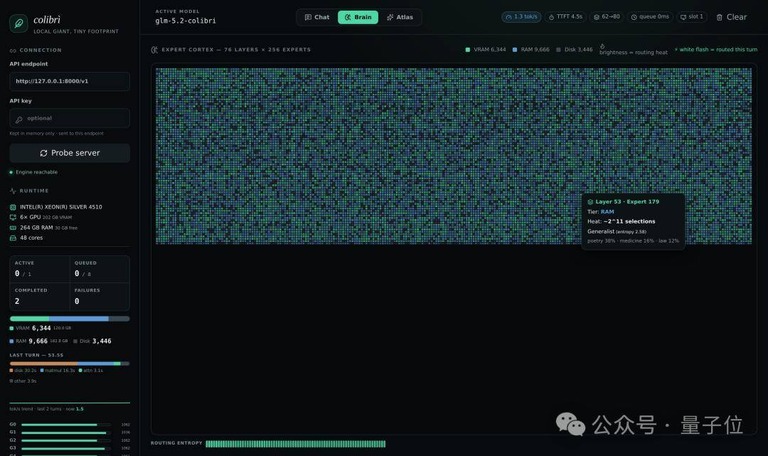
网页控制台:实时显示生成速度,各阶段耗时,还有三个存储层里的专家数量
它还专门做了一个专家面板,把 GLM-5.2 的 19456 个专家全部画了出来。
哪个专家刚被点中过,现在住在哪一层,调用热度多高。
这些都能直接看到。
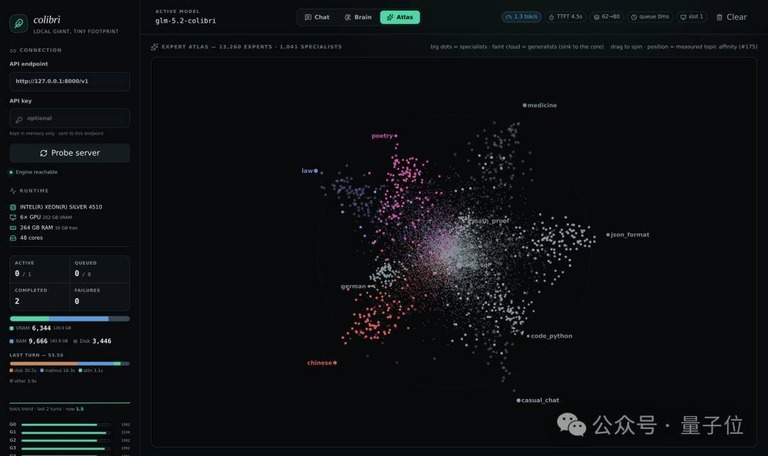
专家面板:19456 个专家的实时调用热度与所在存储层
支持的模型跨度也很大。
小尺寸那边,有千问的几个轻量版本,还有一个来自学术界的开源模型。
中间的 DeepSeek V4 Flash 是 284B。
GLM 系列这边,5.2 和 5.3 都是 744B。
另外还有个 321B 的 Flash 版本。
再往上是 975B 的 Inkling。
最大的一位就是前面提到的 K3。
权重需要大约 1.6TB 存储空间。
但按项目给出的配置,内存从 32GB 起步就能跑,同样不强制要求显卡。
作者还在邀请更多人参与实验,一起找更省资源的方案。
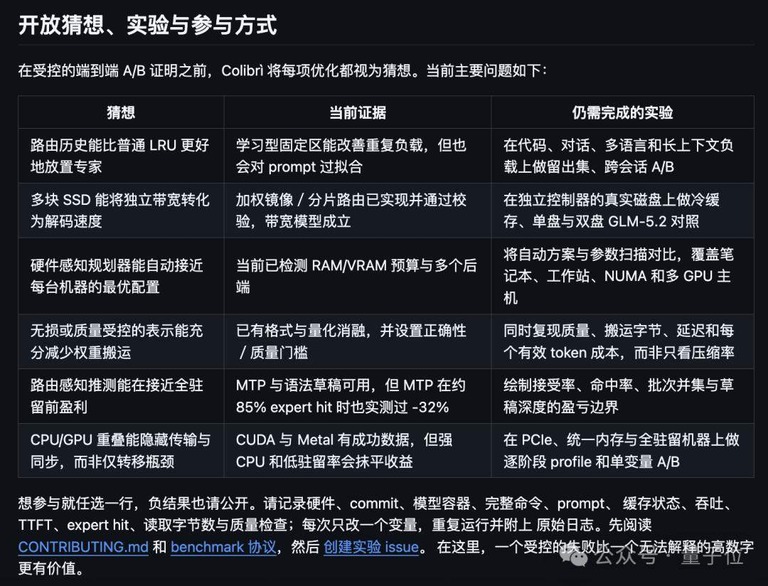
作者公开的猜想清单:每条优化先当成假说,再补对照实验
微小引擎,庞大模型。
这只蜂鸟的胃口不小。
项目地址:https://github.com/JustVugg/colibri
