

10 月 15 日,昆仑万维放出一款叫 Matrix-Game 4.0 的东西。
说它是游戏,不如说它是一套跑在显卡上的世界。
480p 分辨率,每秒 60 帧,从按键到画面响应不到 150 毫秒。
整套东西压在一张 RTX 5090 上。
显存峰值 18.5 吉字节,单步生成的稳态速度能到每秒 83 帧。
这几个数字放在一起,意思其实很朴素。
视频模型第一次真正坐进了玩家的机箱。
它做的事可以拆成三句。
代码写出游戏逻辑。
结构画面给出空间约束。
视频模型负责实时渲染。
这条链路以前没人跑通过,现在跑通了。
项目代码和权重同步公开,技术报告一并发布。
有消息说,周亚辉本人也进了这轮研发。
一家模型公司的创始人下场调游戏,这件事本身就说明方向。
之前同类尝试大多停在能看这一步。
画面好看,但你按不了键。
能按了,也撑不住十秒。
这一版把两端都往中间拉了一段。
换句话说,它想解决的是可玩这两个字。
视频模型跑游戏跑了一年,能上手的很少。
技术报告的首页,标题写着 Matrix-Game 4.0 与 Engine-Grounded Neural Rendering。
一、画面现画,世界记账
团队把方案拆成四块。
单卡实时,让可玩的视频模型离开机房。
新的承载方式,让引擎当裁判,让模型当画师。
一条从数据到推理的工程链路。
还有发布即开源,让创作者改得动。
这四块里,第二块最要紧。
因为它第一次把世界归谁管这件事说清楚了。
过去的做法是让模型把所有东西记在参数里。
现在的做法是给世界找一本账,账由代码记。
模型只负责把账面画得像那么回事。
二、上一代卡在三件事上
上一代交互式世界模型,画面早就够看了。
卡点不在画质,在更下面。
第一件事,世界状态没有独立的维护机制。
场景和物体能不能一直在,靠的是模型的内部表示和历史记忆。
它能记住看过的画面。
但开发者读不出,也改不动,更验不了某个物体的状态。
视野之外的角色和事件,更没法保证按同一条规则继续走。
第二件事,长时间交互的一致性守不住。
自回归生成依赖上一次的结果,局部偏差会跟着连续交互往下传。
玩家反复回到同一个地点,或者让物体多次进出视野。
场景结构会漂,物体身份会漂,交互结果也会漂。
加长上下文,引入记忆,能缓解一点。
但拿不到游戏级的长期保证。
第三件事,合理的画面不等于可靠的规则。
开门、碰撞和攻击,模型都画得出来。
一款完整的游戏还要算账。
生命值怎么减,道具归谁,任务走到哪一步,胜负怎么判。
这些得能被明确写下来,也要能被改、被测试。
三个问题指向同一个地方。
旧路线把世界寄存在模型的记忆里。
游戏要的是一个能读也能改还能验的世界。
所以这支团队换了个起点。
与其让模型硬记整个世界,不如给世界一个显式的载体。
搭轻量游戏引擎的成本,正好被这一轮 AI编程 的进步压了下来。
这类 AI工具 要解决的不是画得像,而是画得住。
三、三个模块,各管一段
整个系统由三个模块组成,分工很清楚。
第一个是引擎,它负责裁决。
引擎记录世界里到底发生了什么,也决定操作会换来什么结果。
它不做精细画面。
只用简化的几何模型,描述道路和建筑,还有角色与可交互物体。
生命值、背包这些由代码明确维护,重力和碰撞也一样。
不是从生成画面里猜。
物体离开视野了,状态照样按规则存着。
第二个是编程智能体,它负责建造。
玩家对着 AI对话 窗口提需求,改地形,摆物件,调 NPC 的行为。
接到需求以后,它要把想法落成代码。
比如想让怪物从四面八方涌来。
画面里多几只只是表象。
生成位置和移动方式都得写进去,攻击行为与胜负条件也一样。
同一个简化建筑,可以是海边旧屋,也能是未来都市的商店。
这段文字描述会和结构画面一起,指导视觉生成。
第三个是视频模型,它负责作画。
在保留结构约束的前提下,生成材质和光照,还有氛围与外观细节。
按因果自回归的方式,接着历史画面往下画。
再靠面向实时重渲染的少步蒸馏,把等待时间压短。

Harness 那一层的结构图,中间是条件接口,两侧分别是构建与渲染。
运行时的顺序是这样的。
玩家按下操作,引擎更新世界状态。
再输出结构画面和控制条件,模型据此渲染。
画面回到屏幕上。
关键动作是把两件事拆开。
游戏怎么跑,交给代码和引擎。
游戏怎么好看,留给模型。
四、把每一毫秒抠出来
要跑起来,先得有数据。
团队用虚幻引擎五搭了一套跨域对齐数据集。
场景取了四类。
超大城市的街区,开放的沙漠,复杂城堡和高动态空战。
这四类覆盖的东西不太一样。
城市考验的是密集遮挡和海量物件。
沙漠几乎是空的,远距离的地平线最容易露馅。
城堡是室内外频繁切换的连续场景。
空战则是高速运动下的相机姿态变化。
光有场景还不够,还得一对一对得上。
自研的轻量化采集管线,让相机轨迹和时间戳严格对齐。
复杂场景被压成低模结构。
保留的是空间拓扑、刚体位姿和动力学轨迹。
再和高模的影视级画面逐帧做像素级对齐。
一边是可计算的骨架,一边是可观看的成片。
同时并行抓取的还有物体实例编号。
可见性状态和因果交互事件也一并记下来。
凑成一条带语义的动态元数据流。
这套数据集不是采完就完事。
四类场景各自要跑不同的运动轨迹。
相机怎么走,物体怎么动,都得在采集前设计好。
对齐是最费时的一步。
时间戳差一帧,低模和高模就对不上。
它也解释了这套东西为什么能少依赖资产。
模型学到的是结构到画面的映射。
不是一堆提前做好的模型文件。
换个场景,只要引擎画得出结构,画面就能长出来。
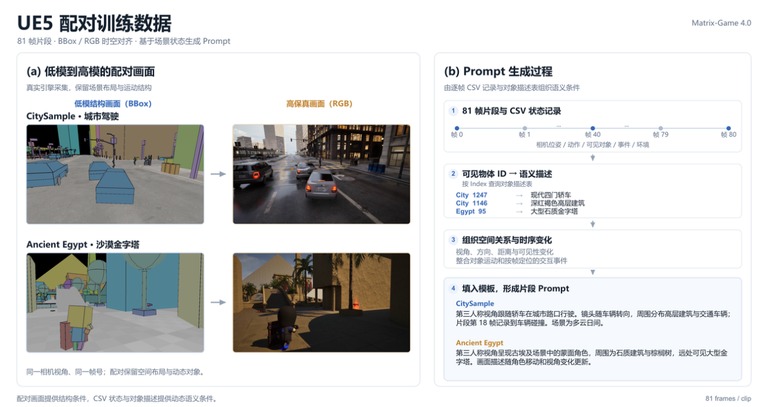
UE5 配对出来的训练样例,上半是低模结构,下半是同一帧的高模画面。
还有个麻烦。
可交互游戏里,画面跟着操作一直变。
转个视角,可见的物体就不同。
固定的文字描述跟不上这种变化。
于是团队做了动态字幕。
系统把物体编号和语义描述绑在一起。
运行再从引擎取当前可见的对象和状态,填进模板。
结构画面给位置和运动,字幕说清有什么。
两边一起约束生成。
可控生成这一步,模型从一个 50 亿参数的开源版本改起,模式换成视频到视频。
引擎渲染的结构画面和待生成的视频按通道拼接。
一共 148 个通道,等于告诉模型画什么、画在哪。
另外还输入三样东西。
场景事件提示词负责细节,空间记忆参考图负责一致,第一帧负责衔接。
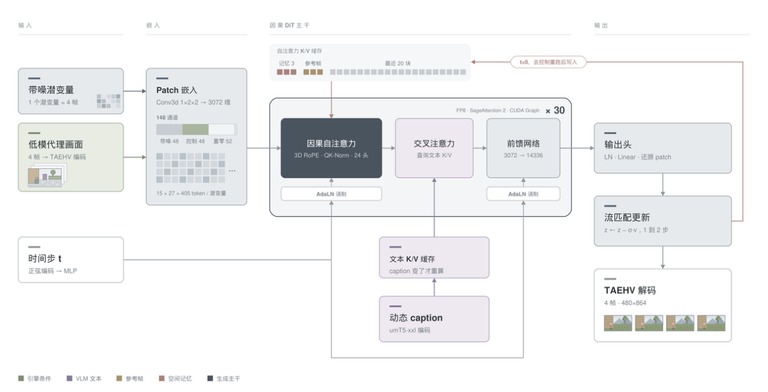
主干的输入排布,低模代理画面和带噪潜变量一起进 Patch 嵌入。
推理加速是最后一道关。
主干的算子序列被预先录成执行图,运行时一次重放。
位置编码、归一化和八位量化编成融合算子。
同一层的查询、键和值共用一次输入量化。
文本条件的缓存只在字幕更新时重算。
视频历史的缓存改成环形,自注意力按窗口切分后并行。
编解码换成轻量的一套。
最后三类计算全部常驻在那张显卡上。
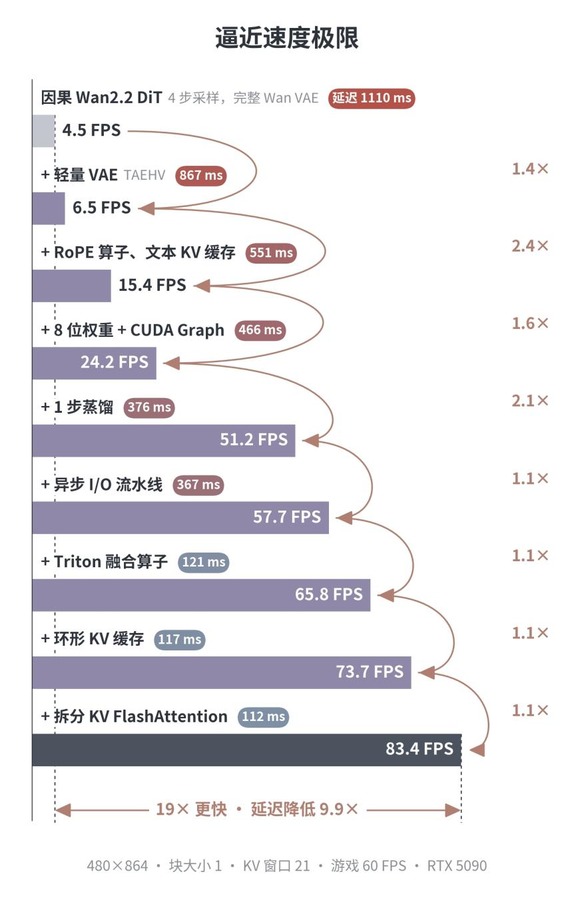
这一页在算速度账,四步采样下的延迟 1110 毫秒,异步流水线再拿到 1.6 倍和 2.4 倍。
最容易被忽略的地方,是它有多好改。
玩家可以在现成代码上动自己的游戏。
不用打开编辑器,一层 AI对话 窗口就能说清需求。
想调地形,想摆物件,想改 NPC 的行为,都能落下去。
团队也鼓励创作者接着改。
这类 AI工具 的用处,不在于把一款大作做出来。
而在于让一个人也能把想法跑成原型。
过去一年,视频模型跑游戏出了不少新成绩。
但能不能在普通玩家的电脑上跑起来,是另一回事。
一张对比表把差距摆了出来。
从按键到出画面,第一种方案要 10.2 秒。
第二种 545 毫秒,第三种 878 毫秒。
这套系统是 112 毫秒。
大约是前者的九十分之一,是后两者的五分之一和八分之一。
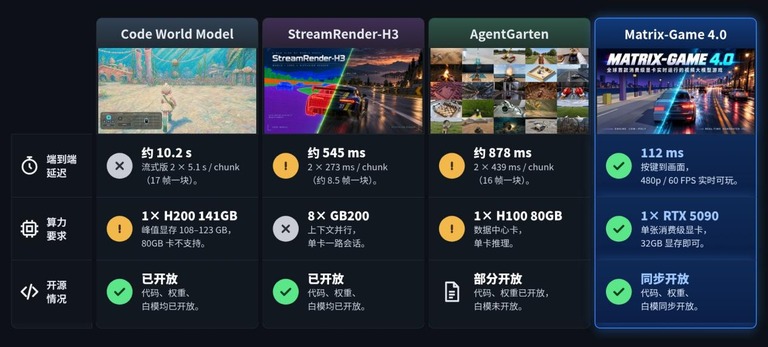
四家的横向对比表,Code World Model 打头,StreamRender-H3 与 AgentGarten 依次排下去。
算力上,别的方案分别要一张 141 吉字节显存的数据中心卡。
要八张更强的那款,还要一张上一代旗舰。
它只用一张消费级显卡和 32 吉字节显存。
开源程度上,两家已经开放,一家部分开放。
它把代码、权重和低模资产一起放了出来。
接下来团队还有几件事要做。
部署精修模型,把画面分辨率再抬一档。
试多人联机,让不同视角看到一致的世界。
给画面更细的控制粒度,支持更多场景类型。
从可控制的视频,到可运行的世界。
这一步的分量,可能被低估了。
真正被改写的不只是画质,还有资产生成在流程里的位置。
以前做一款原型要一支美术团队,现在要一张显卡和一句话。
门槛降下来,先受益的是小团队。
它让创意的门槛降了下来。
也让想象力的边界往外推了一格。
