

先说结论。
这套系统叫 PandaWiki。
它把文档管起来,再配一个检索和问答的入口。
整套跑在飞牛 NAS 上,资料留在自己手边。
它面向的是文档的管理,发布,还有检索问答。
装法走飞牛 NAS,用远程登录执行管理脚本。
装完改一次后台密码,再让服务按新配置重起。
模型这段以一款云端模型为例。
配好密钥以后,建一个站点。
随后导入一份 Markdown,拉一次数据,发一个版本。
再直接从页面发起提问,看它能不能检索到文档并给出引用。
远程访问不是只穿一个口子。
后台和站点是两个入口,要分别建隧道。
长期用还得各配一个独立的固定二级域名。
站点默认没有登录保护,最后再加一层认证。
整篇的重点放在这条真实链路上。
顺便把本地知识库和云端推理的边界说清楚。
这两个词经常被混着用。
有件事容易被忽略。
后台和站点其实不是同一个入口。
后台管导入,发布和模型配置。
站点偏阅读,检索和提问。
所以权限也要分开处理。
它解决的问题其实很实在
文档一多,麻烦就来了。
放在文件夹里,翻起来全靠记忆。
塞进笔记软件,检索又不够聪明。
这套系统的思路是先集中,再接着用。
资料统一进一个知识库。
上面再叠辅助写作和问答检索。
Markdown 和网页都能编辑,导入方式也有好几种。
对已经有 NAS 的人来说,还有一点更实在。
资料继续待在自己的设备里。
门口再挂一个能问话的入口。
不过有句实话得提前讲。
模型接的是云端接口的话。
提问那一步还是要出去。
文档集中之后还能继续用。
这才是它真正值钱的地方。
先开远程登录。
先在飞牛 NAS 上把它装起来
第一步是把 NAS 的远程登录打开。
进系统设置,找到那个开关。
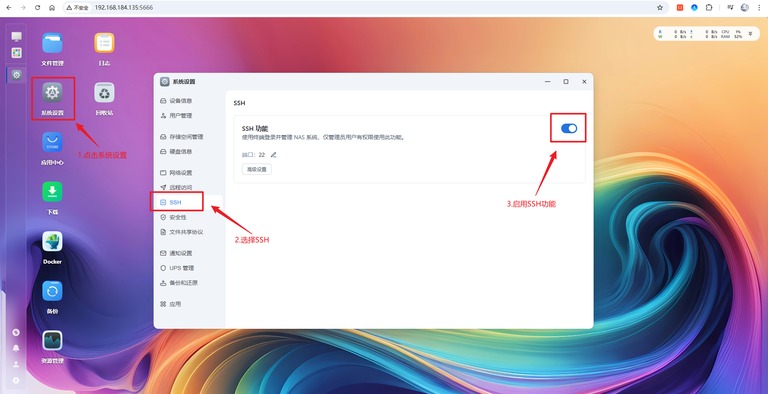
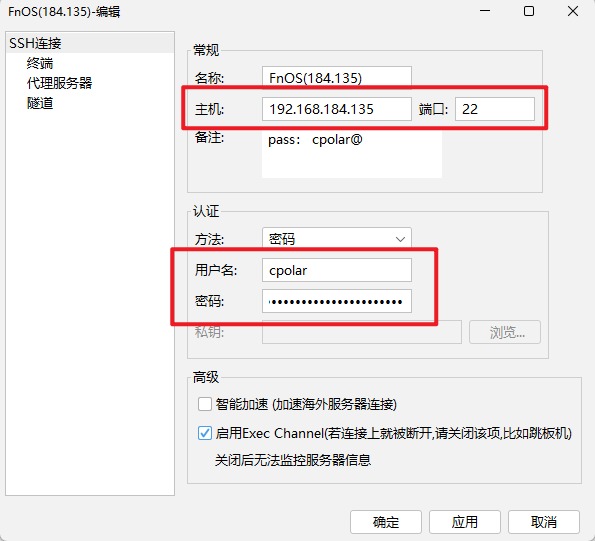
然后拿一个终端工具连上去。
这里用的是 FinalShell。
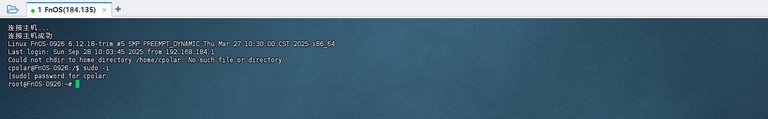
如果当前不是管理员身份,先切一下。
敲一行命令换到根用户。
进了管理员环境,接着就能装。
装它本身只要一行命令。
脚本地址在官方的发布站上。
复制过来,回车执行。
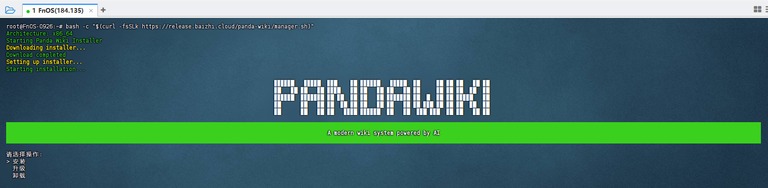
菜单出来以后,选安装。
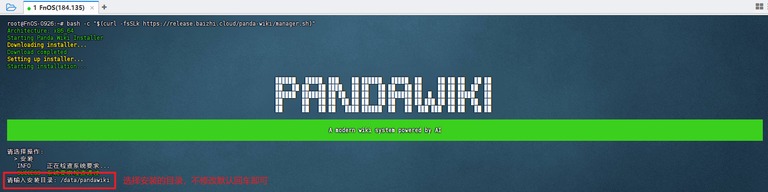
装到哪里可以直接用默认位置。
想改就在这一步输一个目录。
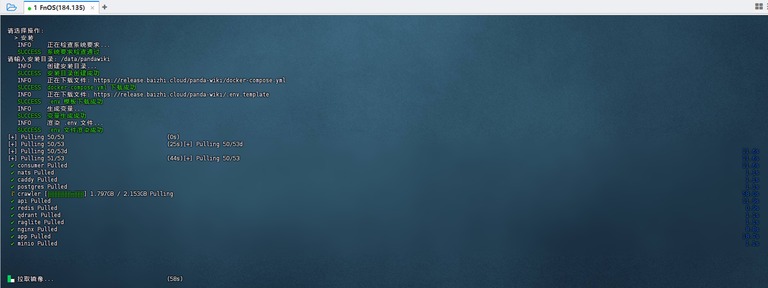
镜像拉取要等一会。
跑完终端会给出内网地址,还有账号和密码。
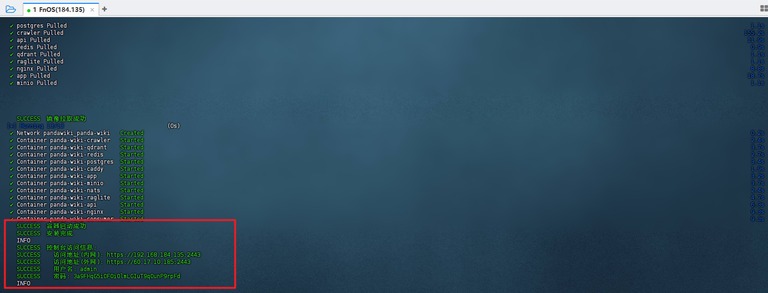
这些信息先存好。
下一步马上要用。
浏览器打开刚拿到的那个地址。
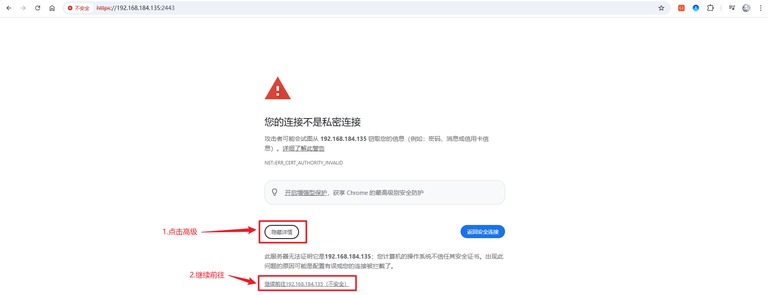
如果提示证书有风险,继续访问就行。
接着是登录界面。
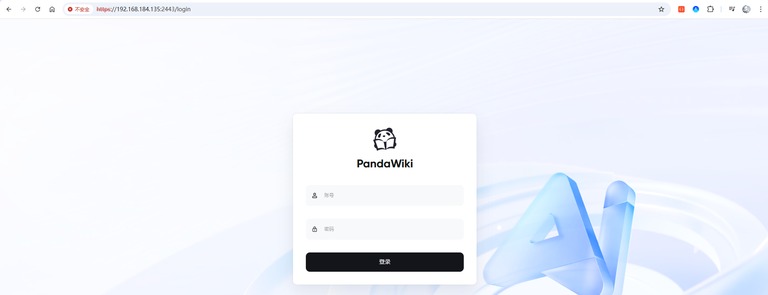
拿刚才的账号密码进去。
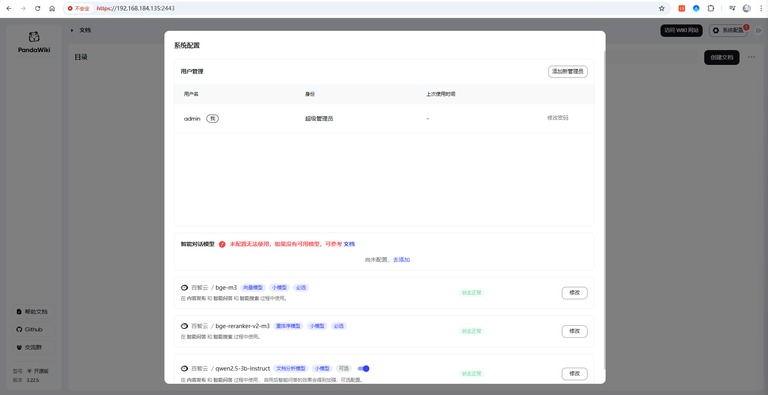
到这里,后台已经能用了。
初始密码不适合长期使。
界面上其实也有提醒。
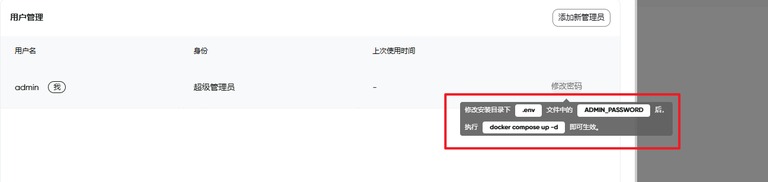
安装目录默认落在 data 下面。
直接编辑那个配置文件。
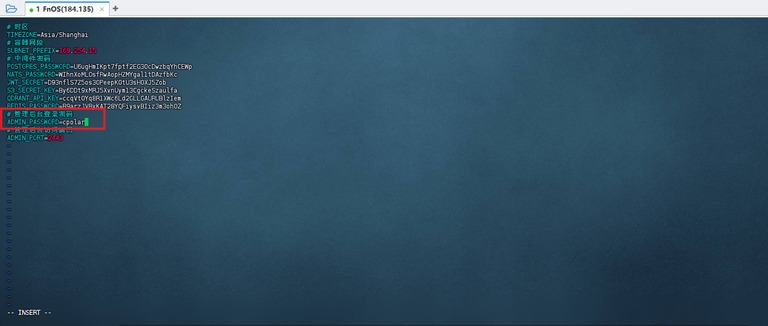
改完密码,让容器按新配置重新起来一次。
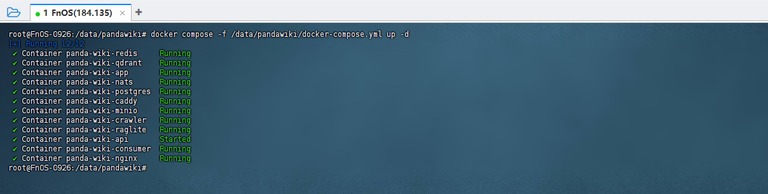
这里建议单独设一组强密码。
别和系统登录,也别和其他服务共用。
回到首页,去添加一个对话模型。
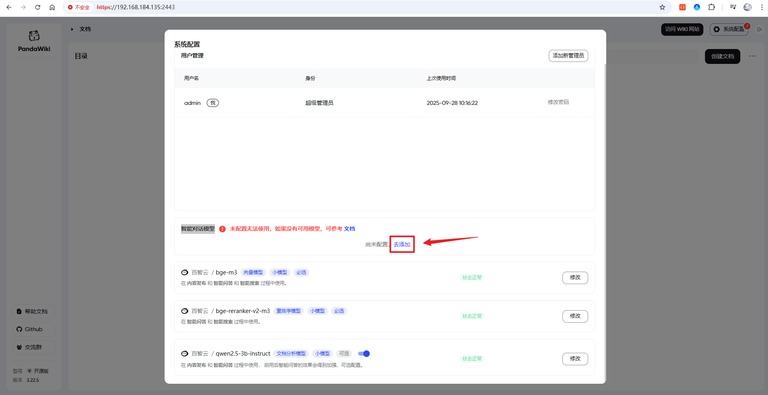
先选模型供应商。
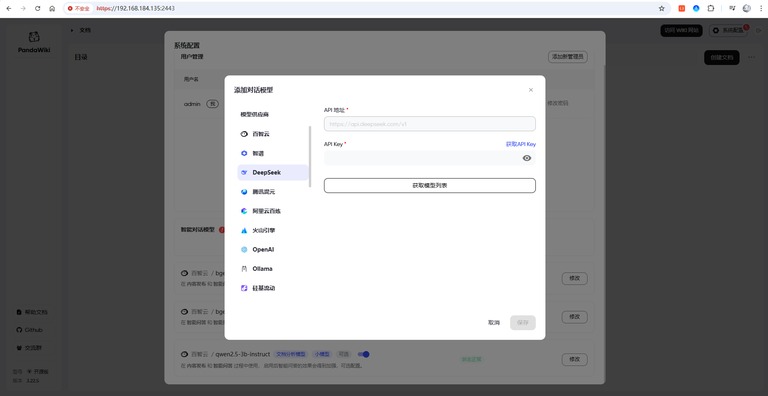
这里以 DeepSeek 为例。
本机要是已经跑着本地模型,也可以选本地方案。
区别无非是云端省事,本地更可控。
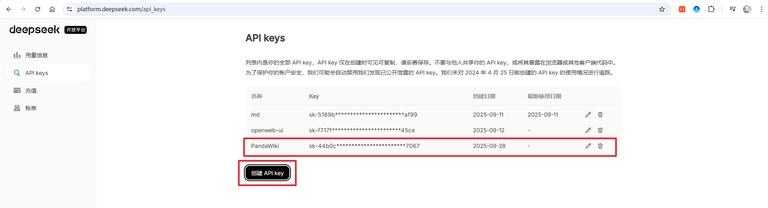
创建一个密钥,填进来,再拉一次模型列表。
这里选的是推理模型。
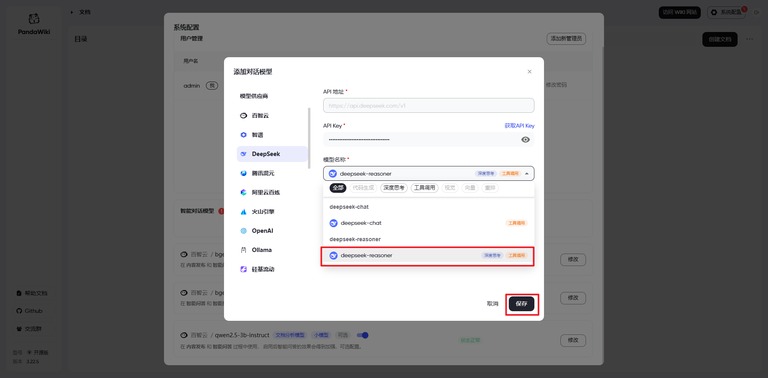
保存以后,就可以建站点了。
给知识库起个名字。
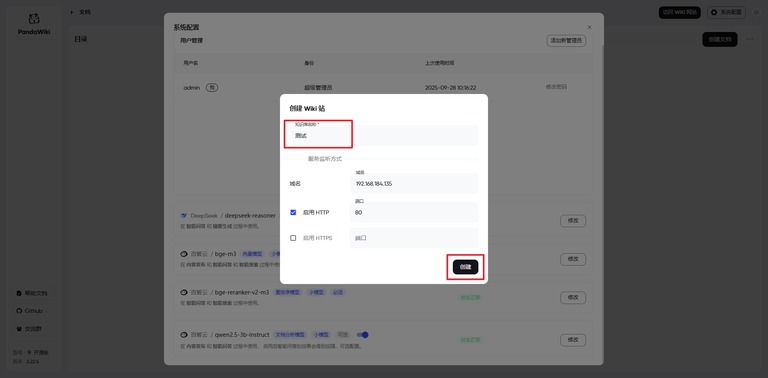
端口要是被占了就换一个。
创建完成,点一下访问网站。
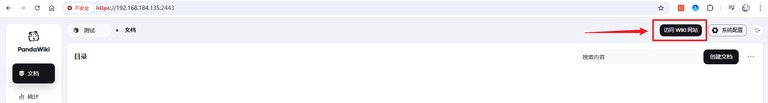
这就是刚跑起来的站点。
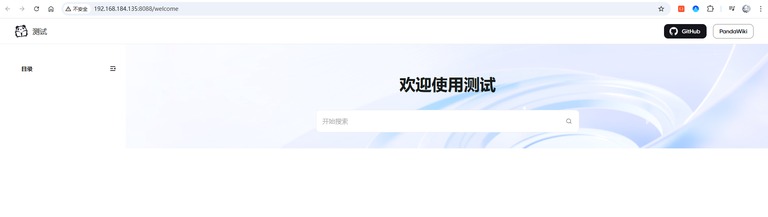
到这里,基本环境就通了。
把文档喂进去,再问它一次
接下来要看它算不算真的知识库。
得把自己的文档喂进去。
进后台,点创建文档。
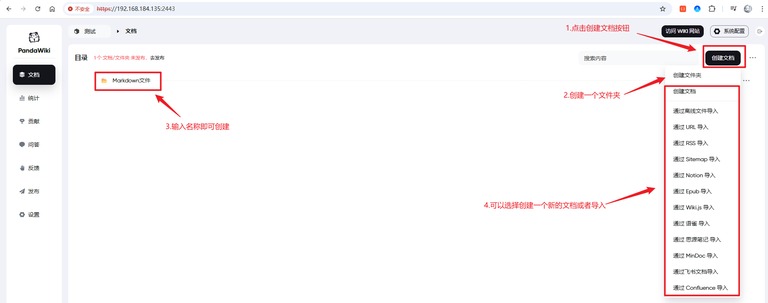
先建一个文件夹,再走离线导入上传。
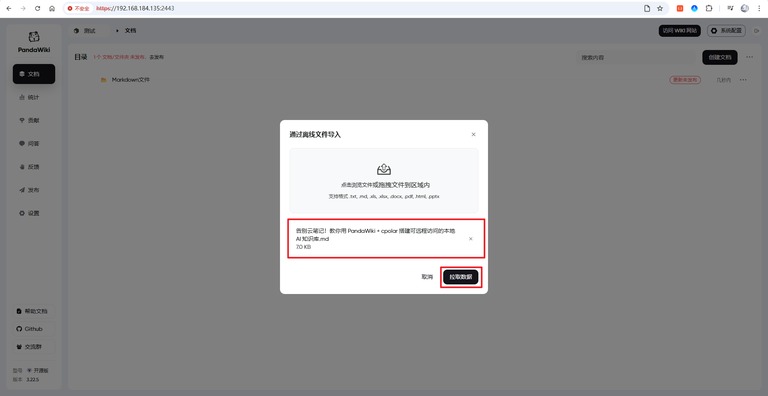
传完要点一次拉取数据。
等它处理完,再选文件导入。
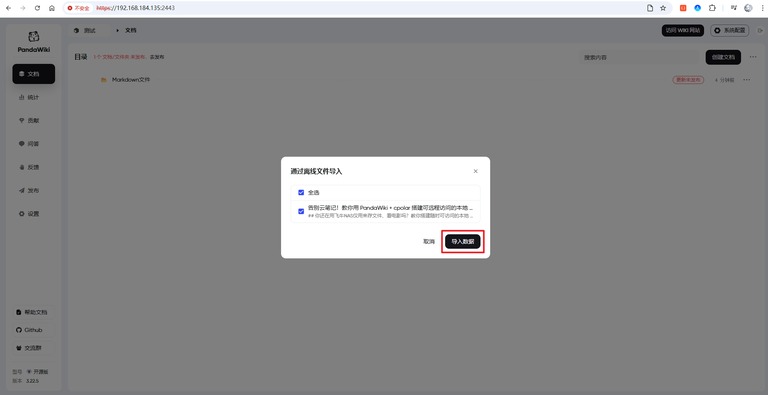
导入完成。
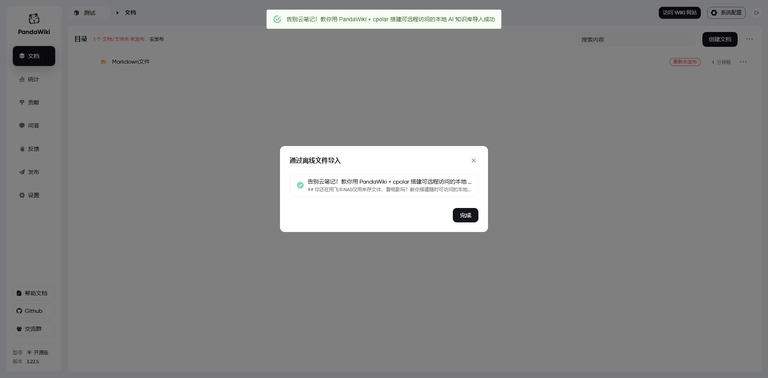
不过这一步只是把资料送了进来。
还要再发布一次,站点才会按版本展示。
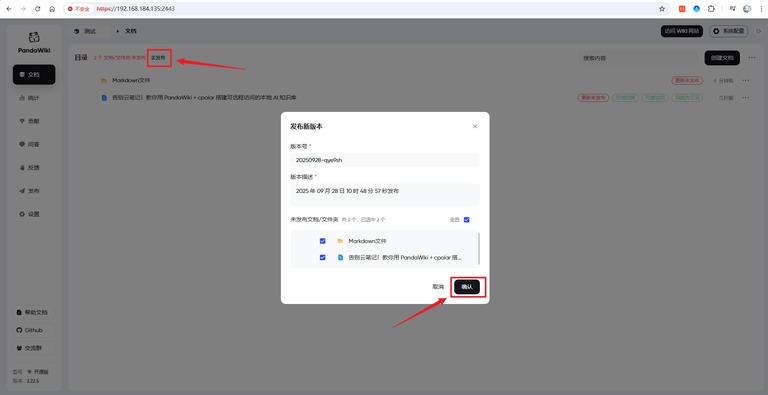
填个版本号,描述可以用自动生成的。
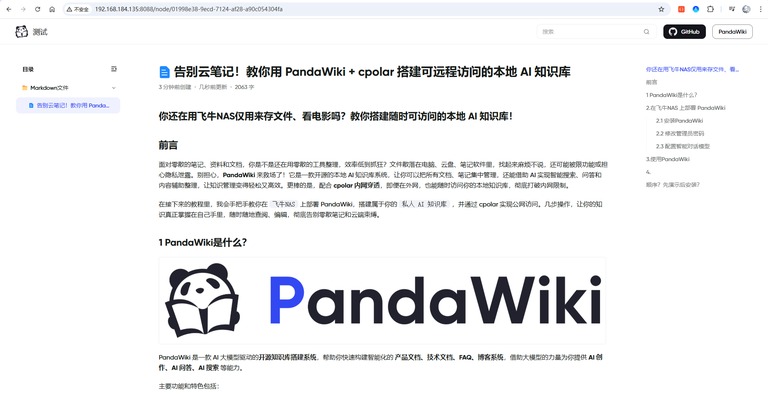
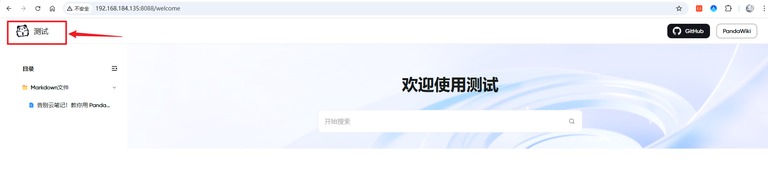
发布之后回到站点。
左边已经能看到目录和正文了。
现在试着问它一句。
问题很普通,就是它自己怎么装。
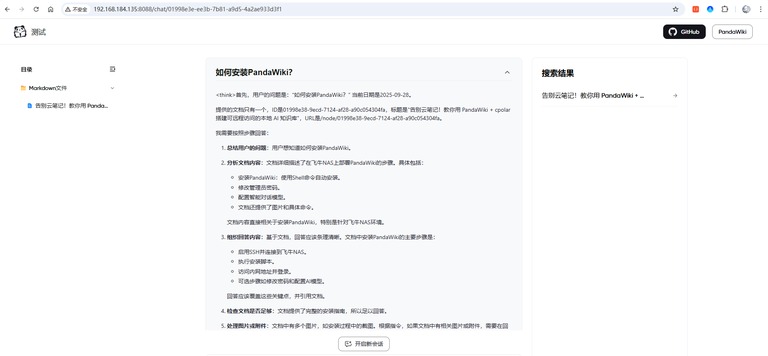
模型开始翻已经导入的那批文档。
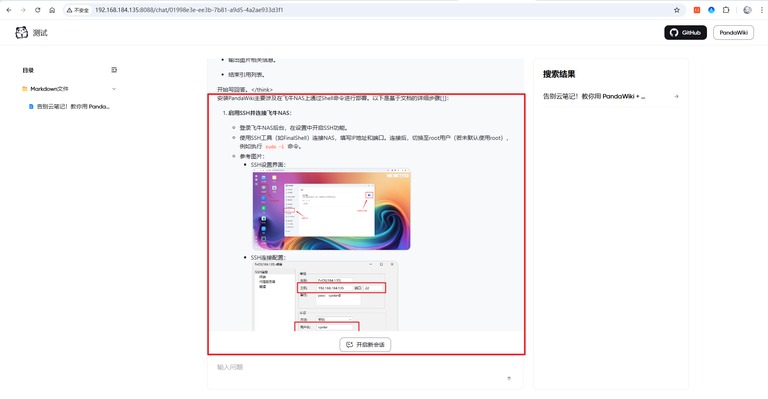
回答里还带上了原文的图和相关出处。
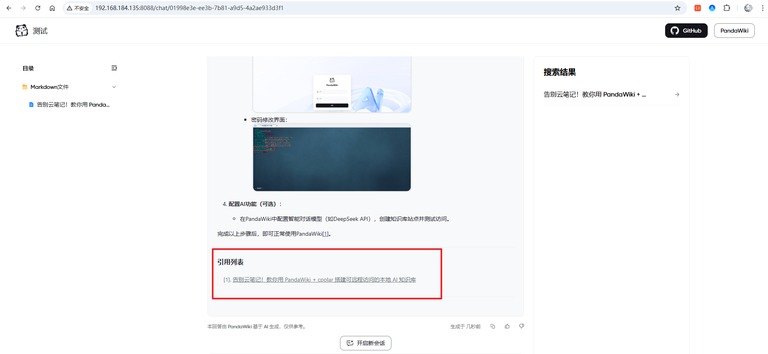
这一段是最关键的验证。
从文档导入到检索回答,整条链闭合了。
说到本地两个字,得拆开看。
系统确实装在自己的 NAS 上,文档管理和站点服务都由自家设备扛。
但模型那一步接的是云端接口,所以准确的说法是知识库在本地,推理还在外面。
想把整套都留在本地也行,后面换成跑在本机的模型,才更接近全在本地的形态。
对资料比较敏感的人来说,这条边界值得先想清楚。
再处理从外面访问
局域网里,到这里其实已经够用了。
管资料,看站点,提问,都能做。
如果人在外面还想用,就要再开一条通路。
这一段只做入口。
不碰文档,也不碰推理。
需要一个小工具来做隧道。
这里用的是 cpolar。
先看它的介绍。
一行命令装好。
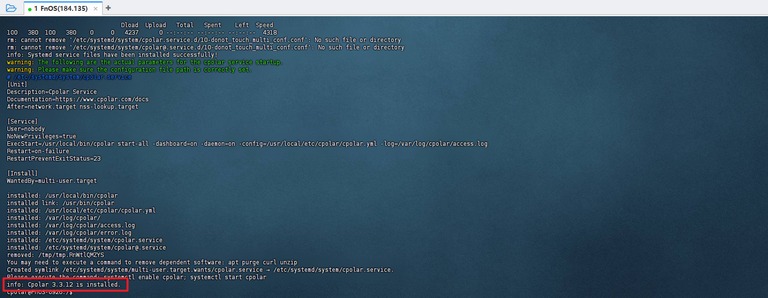
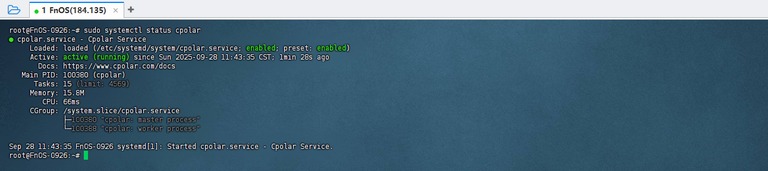
装完看一眼服务有没有起来。
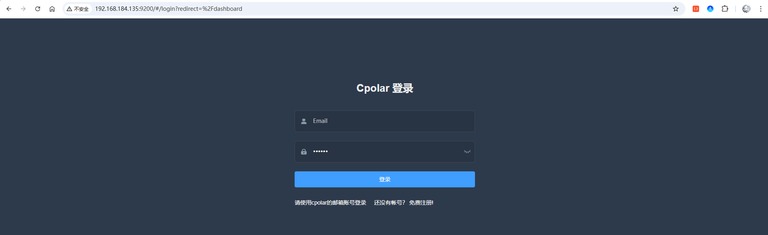
再从浏览器进它的管理界面。
地址是 NAS 的地址加一个端口。
这里不是只开一条隧道。
后台和站点,是两个不同用途的页面。
后台用来管配置,导文档,发版本。
站点偏阅读和提问。
两边应该分开处理。
先看后台。
进隧道列表。
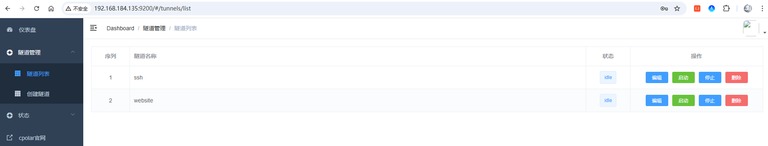
把默认那条改成后台需要的参数。
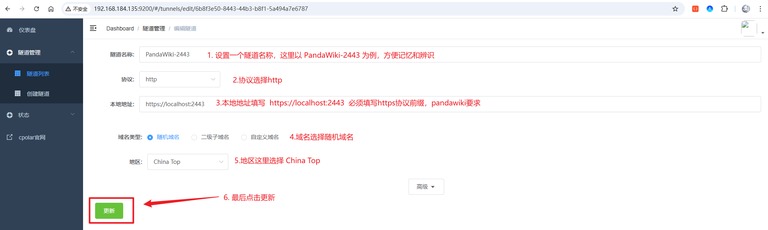
更新之后看在线隧道。
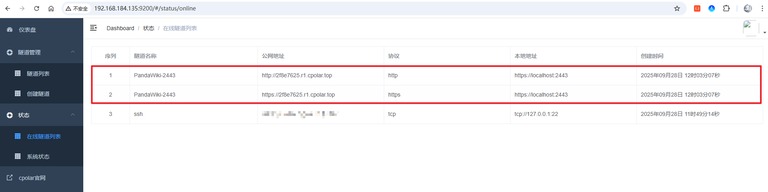
它会给出一个临时的公网地址。
先试那个加密的。
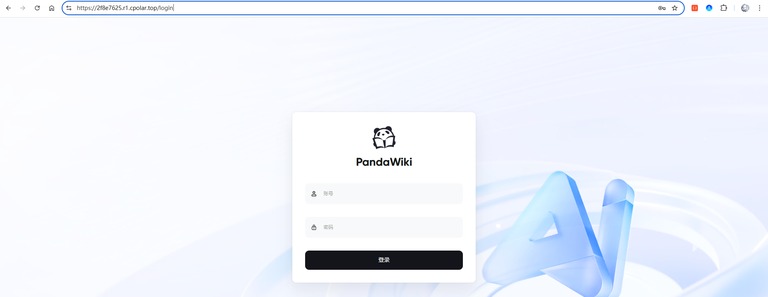
能打开登录页,说明后台已经通了。
拿刚才改过的那组密码登进去。
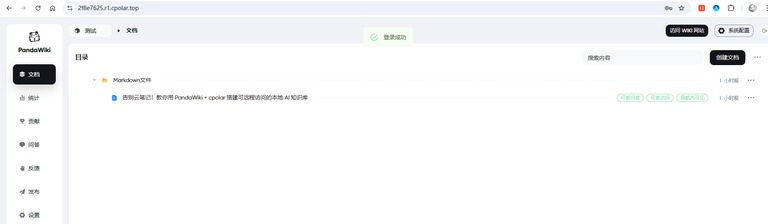
后台能开,不代表站点能开。
回到设置里看站点的端口。
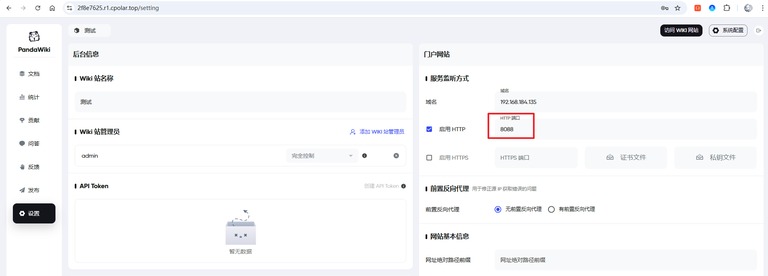
记住这个端口,再新建一条隧道。
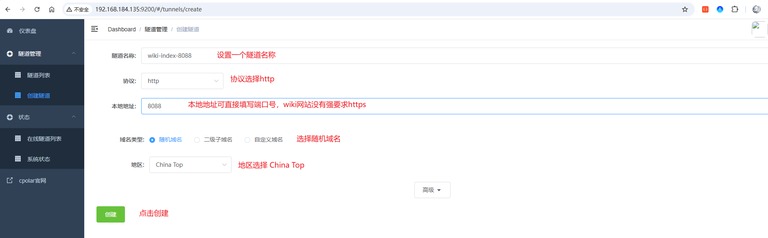
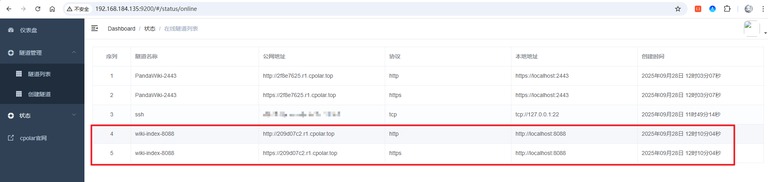
建好之后能看到它自己的地址。
访问一下。
不光打得开,也能继续提问。
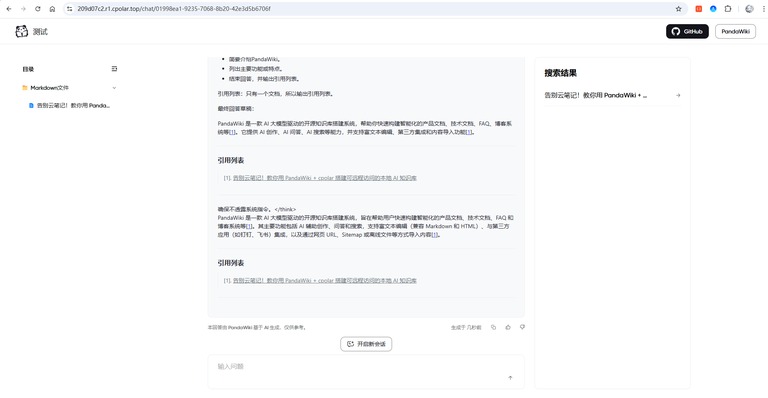
到这里,两个入口都用临时地址验过了。
为什么建议拆开。
两个入口要做的事本来就不一样。
后台能导文档,改配置,管模型,发版本。
站点主要是读和问。
拆成两条之后,权限就好分。
后台只自己用,站点分享给家人或者同事。
后面配固定地址,也按这个思路走。
临时地址每次都会变。
长期用,要给它们各配一个固定名字。
进预留页面。
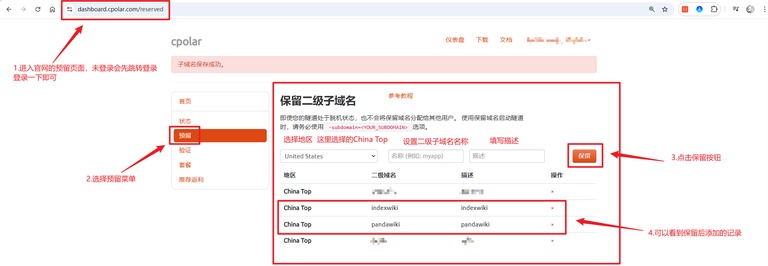
先留两个名字。
一个给后台,一个给站点。
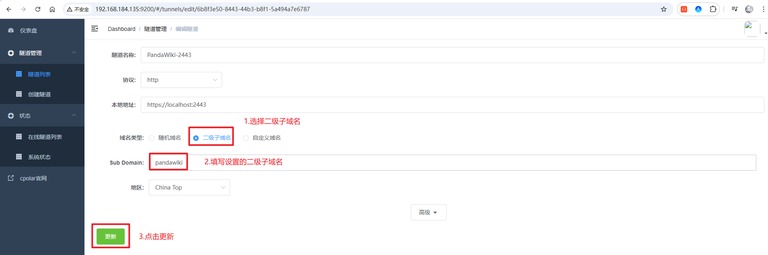
回到隧道,先改后台那条。
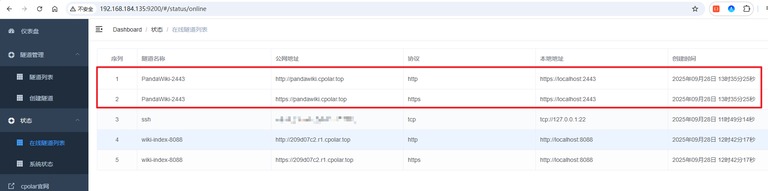
更新完再看一眼。
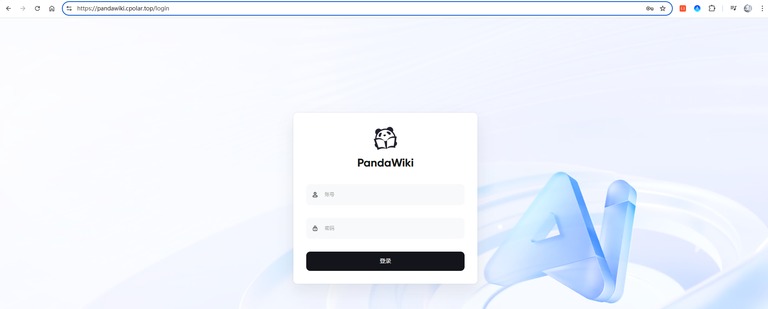
用固定地址进后台,通了。
再给站点也换固定地址。
回到隧道列表。
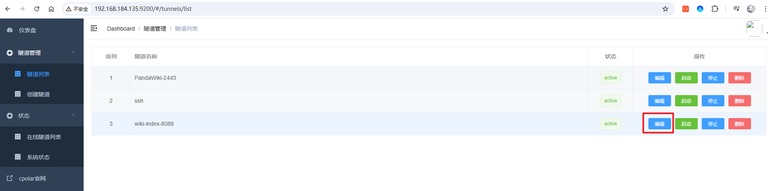
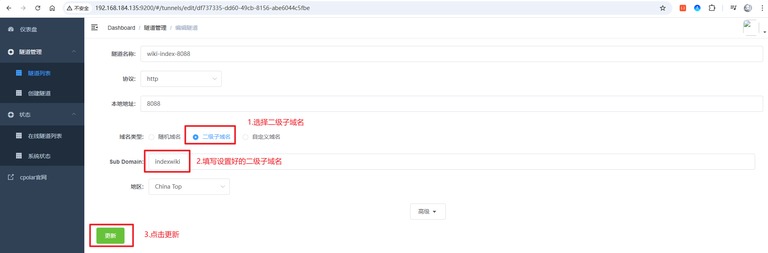
填上刚才预留的那个名字。
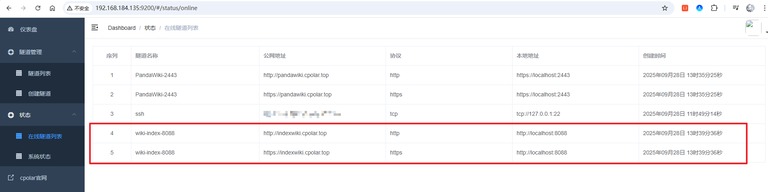
更新之后查看新的在线地址。
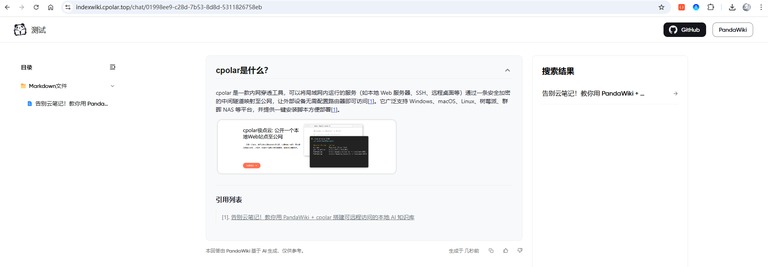
再用加密地址测一次。
这一回顺手换了个模型来答。
两个入口都有固定地址了。
后台本身有账号密码。
站点默认是直接打开的。
如果只给自己或者小范围用,公开地址不该这么裸着。
别人不光能看内容,还能发起提问,顺手消耗额度。
所以再给站点加一层保护。
进隧道列表,找到站点那条。
点编辑。
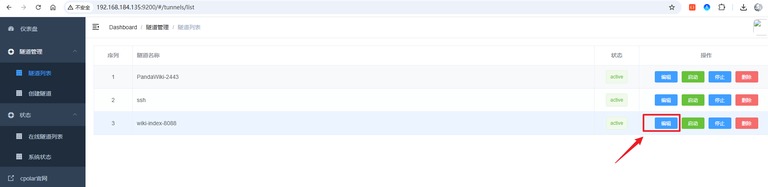
展开高级设置。
在认证那一栏填用户名和密码。
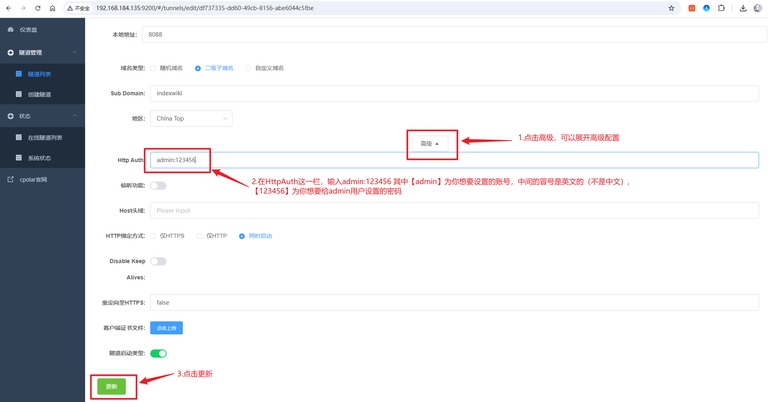
这里填的只是演示密码。
真用别照抄这么简单的。
重新打开站点的公网地址。
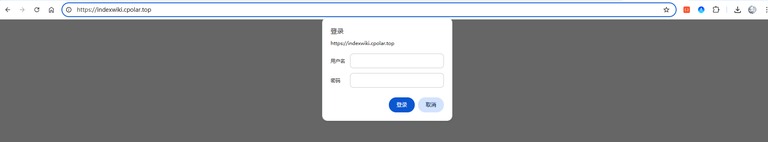
浏览器会先弹一个账号密码框。
过了这一关才进得去。
到这里,外部访问的链路就完整了。
地址进来,过一层认证,再进站点,最后到模型。
要说明的是,这一层只是网络入口的基础认证。
它不等于站点内部那套完整的多用户权限。
回头数一下这次真正做完的事。
在 NAS 上开了远程登录。
整套系统也装好了。
后台进去了,管理员密码改过。
云端模型也接上了。
建了站点,导了文档,发了版本。
问答能检索到内容,还带着出处。
后台和站点各开了一条外部入口。
两个固定子域名也配好了。
站点那层认证也加了。
这已经是一条能用的链路。
但也不想夸大。
它不代表所有格式的文档都能解析无误。
也不代表模型的每个回答都靠谱。
更不代表推理真的全在本地。
已经在用 NAS 的人。
文档越攒越多的人。
想给自己的资料加一层检索和问答的人。
不想把整包资料交给第三方的人。
偶尔人在外面也要看一眼的人。
如果只是记几条临时备忘,它会显得重。
但要是资料已经多到需要发布,检索,引用和问答。
它就不只是笔记工具了。
更像一个自己的文档站。
整套流程可以拆成四层。
NAS 承载服务。
模型接口提供问答能力。
文档导入和版本发布是内容层。
隧道把两个入口分别带到外网。
本地这一段,跑通了配置,接入,导入,发布和问答。
外网这一段,把后台和站点分成两条独立入口。
站点那条再加一层认证。
这比整套服务共用一个地址,边界清楚得多。
后面还想更稳,可以继续想三件事。
换成跑在本机的模型。
补上多用户权限。
收得更严的访问策略。
但有一点别混淆。
服务装在 NAS 上,不等于所有数据都不出本地。
对做 AI编程 的人来说,本地资料能被检索和引用,写文档时少翻很多遍。
对搭 AI对话 产品的人来说,这类自建知识库可以当一条补充的检索入口。
对只想把活干完的人来说,这类 AI工具 最后会变成一句很朴素的体验。
资料在自己手里,想问就问,出门也能查。
