

给一个 AI编程 助手派活。
让它实现登录功能,再补上测试。
它最后回一句,功能做完了,测试也过了。
很多人看到这句就放心了。
把它交给另一个模型打分,多半给个九十分。
可这句话本身,什么也没证明。
代码是不是真存在。
登录逻辑是不是按需求写的。
测试到底有没有跑。
流水线是不是真的绿了。
跑出来的结果对不对得上预期。
这些才是要害。
原来的问题,是这段回答写得好不好。
现在的问题,是这件事到底有没有做成。
两个问题,不该用同一套评法。
传统 AI对话 产品,评价对象就是那段文字。
内容对不对,贴合不贴合上下文,有没有违规。
智能体留下的东西多得多。
代码和文件。
提交记录和流水线结果。
还有部署地址、测试报告。
评价对象换了,评法也得跟着换。
前者评文本,后者评交付物。
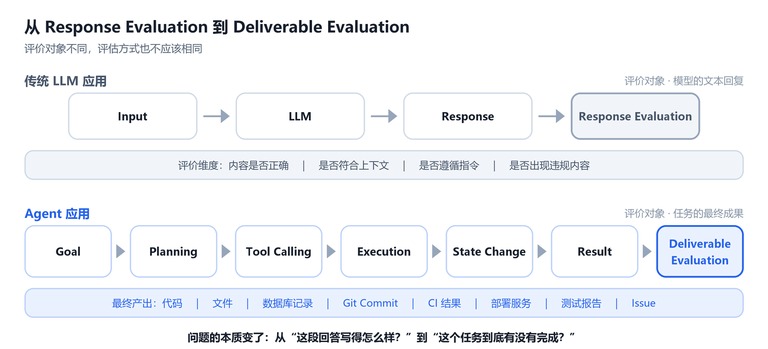
模型说完成了,不等于任务做完了
有人会说,那就让模型直接打个总分。
行不行,先看它被逼着做了几件事。
逐条判断标准。
累加总分。
敲定最终状态。
后两件,本来就不必交给模型。
模型的长处是理解语义,短处是做算术和记总分,后面这两件本就不必交给它去干。
说白了。
假设五条标准权重一样,三条过两条不过,总分就是四成。
算分交给代码,更稳,也更可复现。
所以模型只回每一条过或不过,外加一句理由。
分数一栏,它压根不给。
总分和最终状态,全由代码来算。
再往前一步,还有个更基本的问题。
证据够不够。
有条标准要代码和运行结果两类证据。
可交上来的,只有一句已经实现、运行正常。
只留过和不过两种状态,评审的人就只能靠猜。
所以这里补了第三种状态。
叫需要复核。
证据齐了,当场给结论。
证据缺了,退回让它补。
它不是含糊的待定。
它在说,现有信息不够负责任地下结论。

把能确定的交给代码,把要理解的交给模型
落地的时候,整条流程拆成四道闸门。
第一道只看一件事,证据类型齐不齐。
它连模型都不叫。
这儿有个关键细节。
提交者自己写的说明,不算硬证据。
一句我做完了,替不了代码,也替不了流水线。
好处很实在。
明显缺证据的活,当场拦下,省掉一次模型调用。
第二道更省,它只认确定性事实。
比如有的标准只要求测试结果。
代码仓库那边回,全部成功,就直接算过。
全部失败,直接算不过。
其余情况,交给模型。
原则只有一句。
确定的事,优先于模型的判断。
有些活,甚至一次模型都不用叫。
真正需要模型出手的,是语义判断。
代码内容到底有没有对上需求。
这一层会把收集到的证据整成文本,交给评审模型逐条判断。
代码和说明。
流水线结果和报告。
工单也要一条条过。
但模型的权限被卡得很死。
每一条都得看,不许漏。
每一条都要给出证据出处。
没有运行证据,不能因为代码看着合理就说它跑通了。
这里有个很容易被高估的边界。
仓库里躺着一段登录函数。
它只能证明代码写了什么。
证明不了用户真的登得进去。
依赖版本、环境变量。
数据库连接、网络权限。
哪一环都能卡住。
所以规则里写死了一句。
代码只能证明写了什么,不能证明跑没跑通。
眼下判断跑没跑通,靠三样东西。
流水线的执行结论,运行说明,还有一个能打开的部署地址。
这里也得说清一个限制。
这套东西自己不跑用户代码。
它没有沙箱,也没有测试运行器。
边界与取舍
还有一条设计,容易被忽略。
不是所有评价项都有一样的分量。
有的项有阻断权,不过就整单不过。
有的项只用来找知识漏洞,不直接导致失败。
有的项只产出复盘信息,不参与判定。
换句话说,答错不等于交付失败。
核心不在名字,而在那个字段。
这条标准,有没有阻断权。
有,就该在数据里写明白。
不该全塞进一个总分公式。
真正费时间的地方,不在主流程。
而在各种边角异常。
一种是模型写到一半断了。
结构不完整,数据一解析就报错。
后来加了判断,遇到截断就把上限抬高一档再试。
另一种是格式没错,意思错了。
比如回上来的编号,根本不属于这次任务。
结构校验恰恰查不出这种。
所以现在除了看结构,还得看语义。
编号必须属于这次送审的集合。
证据和理由两栏,都不能空。
该覆盖的项,一条不能少。
结构对,不等于结果对。
还有一种更隐蔽的。
出现了文件名,不等于真有这个文件。
说明里写一句,以后会生成某个文件。
字符串一匹配,系统就当成证据存在了。
这是眼下已知的一个漏洞。
往后得改成真的去查。
查文件在不在,能不能读出来。
缓存这件事也值得做。
用户连着点五次提交,代码和证据一点没变。
没必要叫五次模型。
所以缓存不按时间,也不按会话做。
它给证据拍个快照。
把快照的哈希,当成缓存键的一部分。
同一份证据,就不会反复烧额度。
这里有个明确的取舍。
提交标识没有直接进缓存键。
好处是,同一份证据不因为提交号变了就重评。
坏处是,新提交只改了采集范围外的东西,可能命中旧结果。
这是效率和版本敏感之间的平衡。
没有脱离场景的标准答案。
这套方案目前做不到什么。
它也愿意说清楚。
不跑沙箱,不自动跑测试,不做语法分析。
不做代码检查,不做多智能体协作验收,也不自动改代码。
更没有正式的准确率数据。
做 AI工具 的团队,也能照着这套思路改自己的验收。
现在能讲的只有一句。
它把能确定的事交给代码,把要理解的事交给模型。
证据不够的,单独归到需要复核。
至于它是不是比人工评得更准,还没有实验能证明。
这些能力没做,不是做不到。
沙箱执行和自动测试属于执行态能力,硬塞进验收链路只会把两边的职责边界搅浑。
一是这套东西的定位是验收,不是执行。
二是静态分析这类增强,更适合以插件协议的形式往外挂。
三是大规模人工标注太贵,早期先把主流程跑通。
前面聊的是通用问题。
这套东西最后落到了一个具体项目上。
一个面向编程类项目制学习的系统。
它的流程不是学生问一句、系统答一句。
而是一个完整的项目闭环。
学生说做完了,不算数。
真正进到评审里的,是仓库里的代码。
还有流水线结果、工单和运行证据。
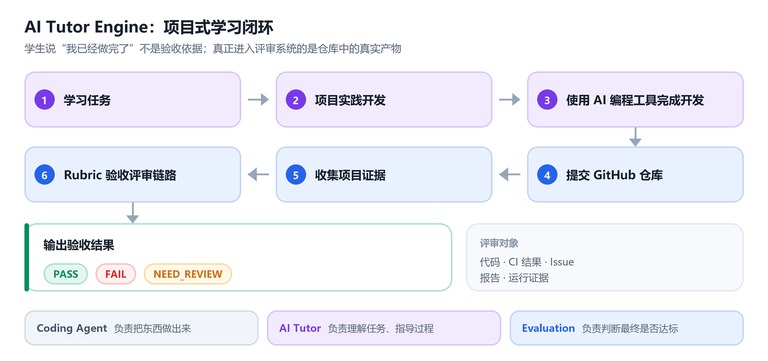
所以它没有往让助手自己写代码的方向走。
写代码的,理解任务并指导过程的,判定是否达标的,是三件事。
它们可以配合,但没必要全塞进一个智能体里。
回头看,整件事能压成一句话。
别问模型,你觉得这活做完了吗。
先问系统,我有什么证据能证明它做完了。
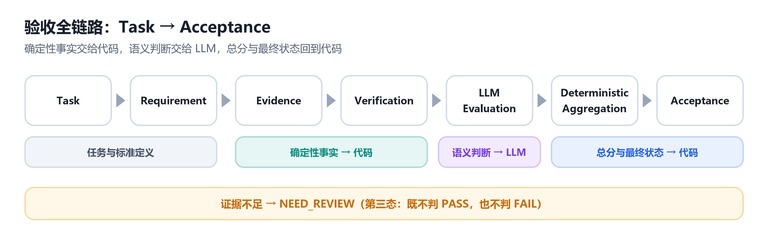
职责也就清楚了。
确定的事实交给代码。
语义判断交给模型。
总分和最终状态,回到代码。
证据不够,退回补证。
这套方案还有很多要补的地方。
运行环境和静态分析。
证据真实性和缓存粒度。
还有评估基准、人工对照。
它更像一次具体的工程尝试。
当智能体的产出不再只是一段文字,而是一个要交付的结果时。
评价的方式,也该围着证据重来一遍。
