

AI 助手正在换一种工作节奏。
一边和你说话,一边在后台替你办事。
听着简单。
做起来一直不简单。
谷歌近期更新 Gemini Live 时,就把后台的工具调用直接塞进了实时交互里。
助手先回一句「我去查一下」,再慢慢处理那些要花时间的工作。
这个顺序变了。
问题也跟着来了。
查资料要时间。
做分析也要时间。
用户的新问题却随时会冒出来。
工具任务还在跑,它还能不能继续接话。
这是真问题。
要把这件事说清楚,得先看一个词。
全双工。
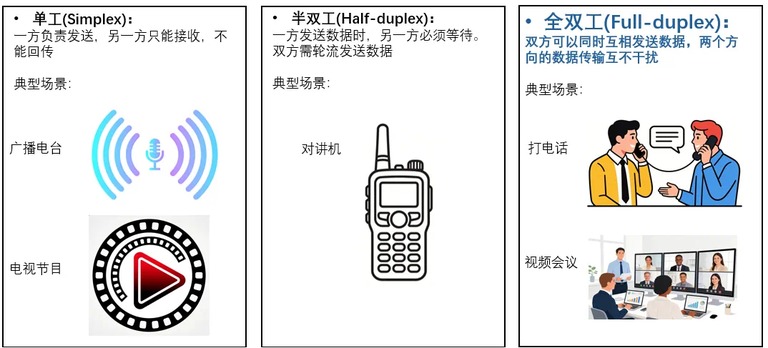
从用户的感受出发,传统语音助手更像对讲机。
你说完一段,它才开口。
它说话的时候你插一句,往往会被打断,或者干脆忽略。
全双工像打电话。
它一边听一边说,你能随时插话、补充。
对话不再严格按「你说完我再开口」的回合往下走。
对用户最直接的变化,不是多了一个技术名词。
是等待感被压掉了。
就这么直接。
不用等它说完,也不用迁就它的节奏。
与其迁就它的节奏,不如想到就补一句。
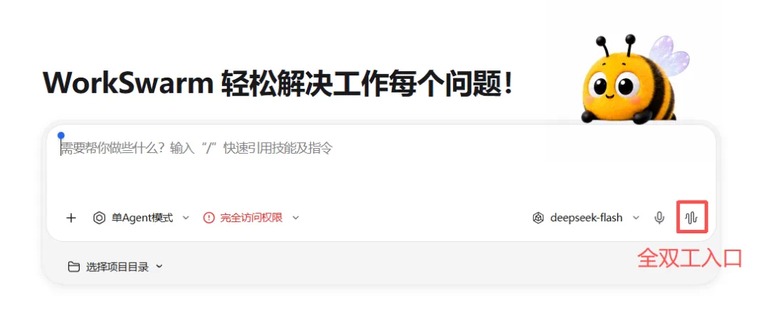
WorkSwarm 的全双工多模态,就围绕这件事展开。
openJiuwen 是一套开源的 AI 智能体平台。
它由华为 2012 实验室牵头,华为云与终端等多个团队也一起参与了共建。
此外还有高校、企业和开发者。
一起来做。
WorkSwarm 是它开源的办公编码统一工作台。
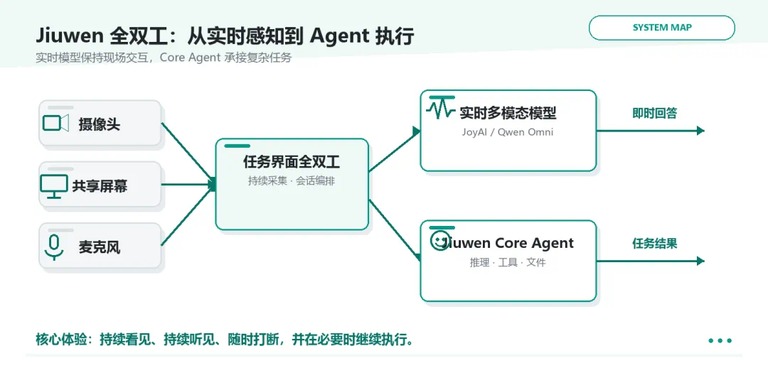
它把实时音视频交互和一层叫 Core Agent 的后台执行接在同一个任务里。
用户能展示眼前的画面,也能随时插话。
那些还需要继续处理的工作,可以直接交给后台。
这套能力没有停在演示层面。
它已经能装。
openJiuwen 已经给出 Windows、Mac 与 HarmonyOS 的一键安装包。
进官网下载装上,就能直接体验。
能打断,才叫实时对话
人与人交流,很少严格遵守一方说完另一方再开口。
看到新画面,发现理解偏了,或者只想先听重点,人都会直接补上一句。
「先别介绍背景,直接说结论。」
这句话可以在它播报的时候说出来。
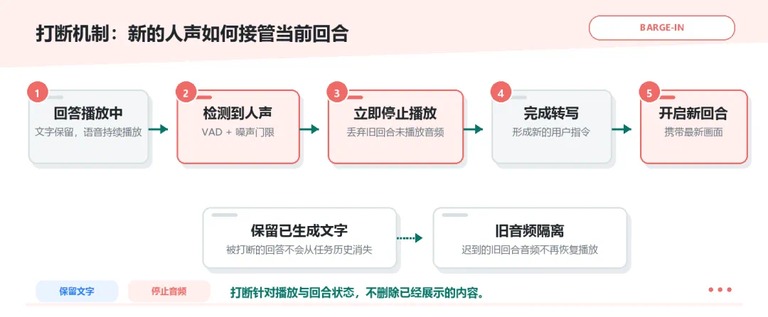
系统检测到新的有效人声,就会停下当前播报,转去处理新指令。
已经生成的那段文字,仍然留在任务记录里。
语音活动检测和噪声门限,用来压低背景声造成的误打断。
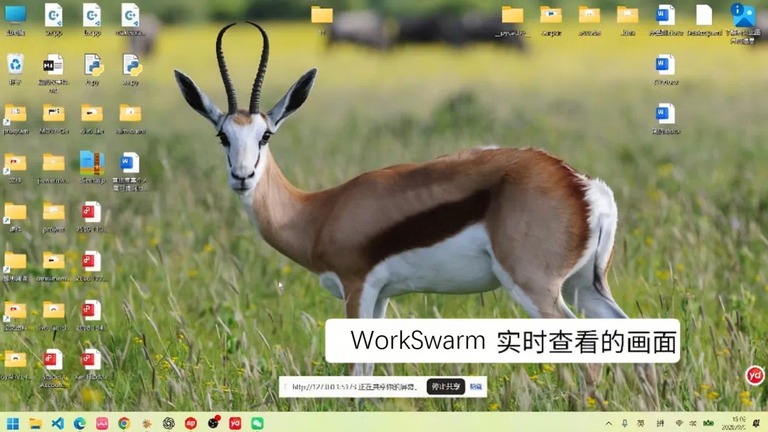
视频里我们让这个助手先朗读《岳阳楼记》。
读到一半,直接开口说朗读《兰亭集序》。
它就能自然地快速切过去。
切换很顺。
插话改变的是当前这轮对话。
已经交给后台的工具任务,有自己独立的运行状态。
想取消它,得单独到任务控制里手动停。
两件事。
用户说话的时候,系统其实要同时应付两个层面。
对话层接住新要求。
任务层管好已经跑起来的工作。
一边聊天,一边办事
「这是什么品牌。」
问完,用户可能还会补一句。
「查一下它的资料,整理成一份文档。」
一个看图的问题,就这样变成了一串活。
先搜索。
再分析。
最后还要生成文件。
资料还没查完,新的问题可能又来了。
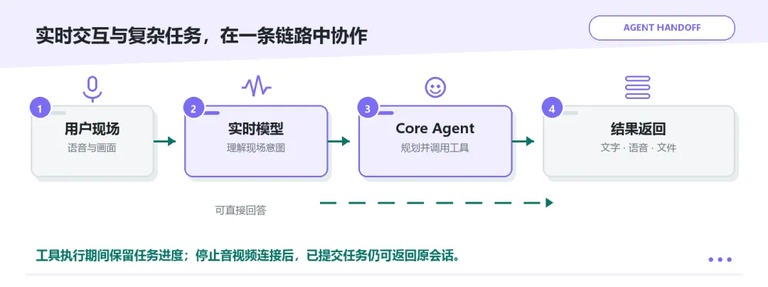
它用两条路径接住这两种节奏。
实时模型负责看画面,听要求,及时回应。
后台执行层负责拆任务、调工具,把后面的活往前推。
搜索在后台跑,对话在前台继续。
节奏不打架。
用户还能追问眼前的画面,也能随时打断播报、补充要求。
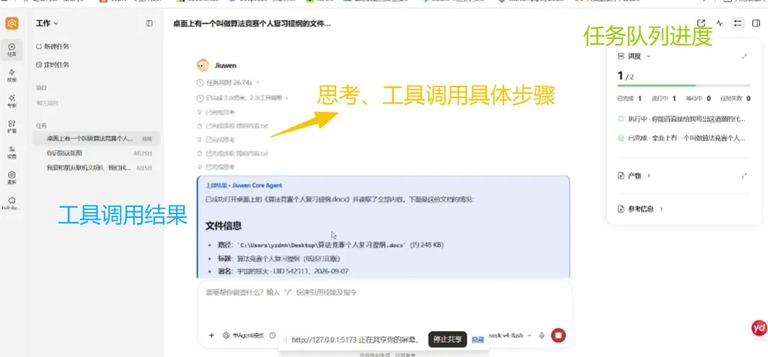
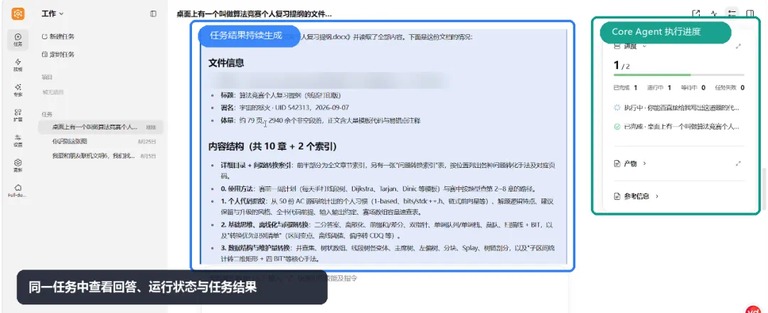
任务进入后台执行层之后,页面会持续显示它的状态。
工具调用记录和执行结果都在同一处。
文件产物也摆在那里。
用户看到的不再只是一个转个不停的「加载中」。
而是事情正在怎样一点点往前推进。
不再是黑箱。
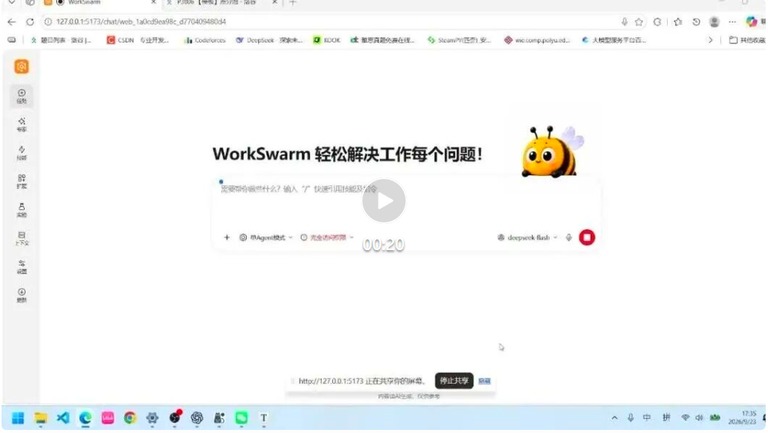
视频里我们先下发一个任务。
让它通过工具调用,去读我们的算法文档。
这时候右上角的任务队列里,能看到任务正在运行。
与此同时,我们还能正常和它聊天。
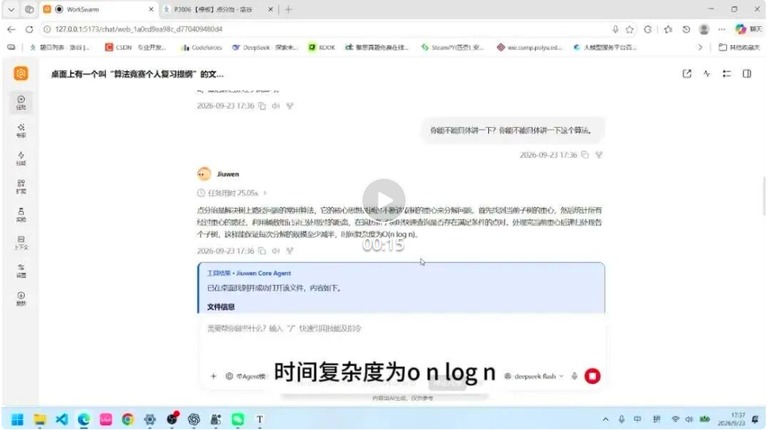
任务完成以后,系统不会打断正在进行的对话。
它会先把总结信息输出在文本框里。
等这一轮对话结束,才开口汇报工作。
汇报的时候也不照本宣科。
挑重点说。
它会像人一样挑重要的信息说,而不是把全部内容都用语音念一遍。
任务排队,各走各的
前一个搜索还没结束,用户又交代了第二件事。
怎么办。
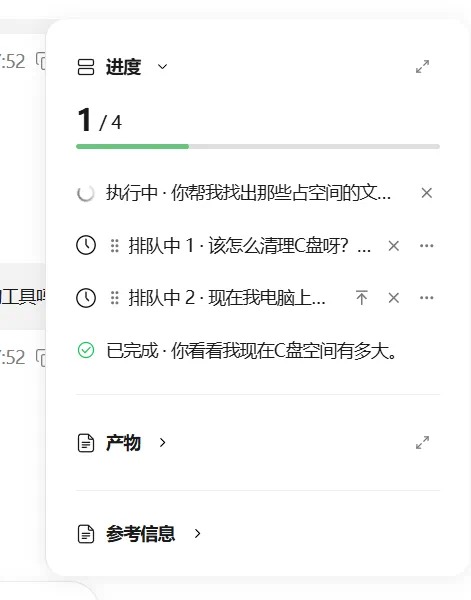
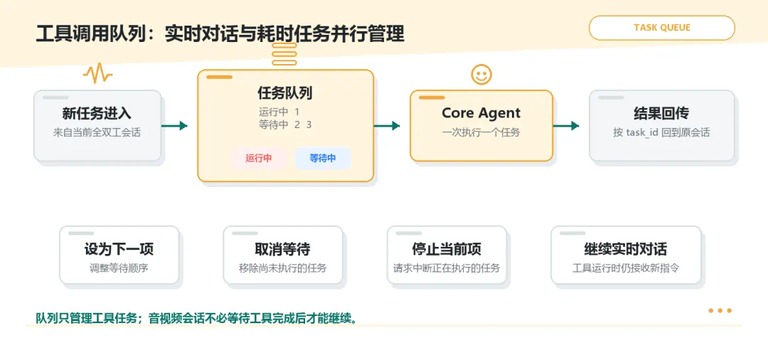
它的全双工任务队列,会给后面交代的要求留出一个明确的等待位置。
用户能调整顺序,把某项任务设成下一项。
也能停掉正在等待或者正在执行的任务。
与其把几件事挤在一起,不如给它们排个先后。
对话在继续,哪些事在做、哪些还没开始,都有明确的状态。
一目了然。
音视频连接和工具任务,也是分开管的。
就算把全双工的音视频关掉,已经交给后台的任务照样能跑完。
完成后的文字、工具结果和文件,会回到原来那轮对话里。
比如通过镜头发起一次品牌查询。
用户可以结束音视频交互,过一会儿再回来翻资料。
现场交代的工作,于是有了一个能追踪的过程。
可以回溯。
把这两件事放在一起看,这套工作台的意义就清楚了。
它不只是让 AI 能边听边说。
它让实时对话和后台执行真正并行起来。
用户在前台像聊天一样,随时打断,随时追问,随时补充。
复杂任务在后台按自己的节奏,查资料,调工具,做分析。
这种对话不中断、任务不停跑的体验,已经走出演示。
它开始变成一种能用的协作方式。
这很难得。
AI工具的形态,也在从一问一答往同事式的并肩干活挪。
如果我们过去习惯的 AI对话更像一台随时在线的答录机。
那现在它更像一位坐在旁边的同事,边聊边把活干了。
这也是 AI编程 这类重度场景最先受益的地方。
活多,步骤长,来回确认也多。
这正是它擅长接住的部分。
省下大量来回。
当 AI 不再要求人迁就回合,人机协同的下一段节奏,也就此开始。
怎么用起来,官方也交代得比较细。
模型和语音通道都能在设置里配。
配置不算难。
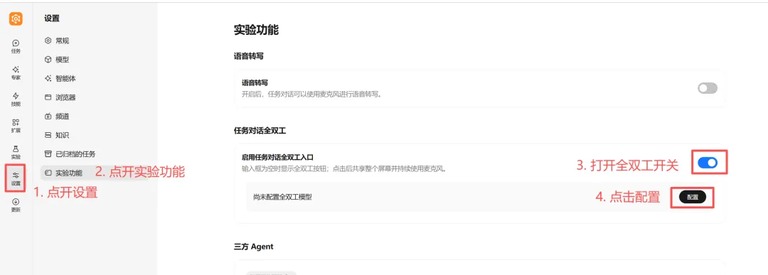
目前支持 JoyAI 协议和 Qwen Omni 协议。
点一下模型通道就能切换。
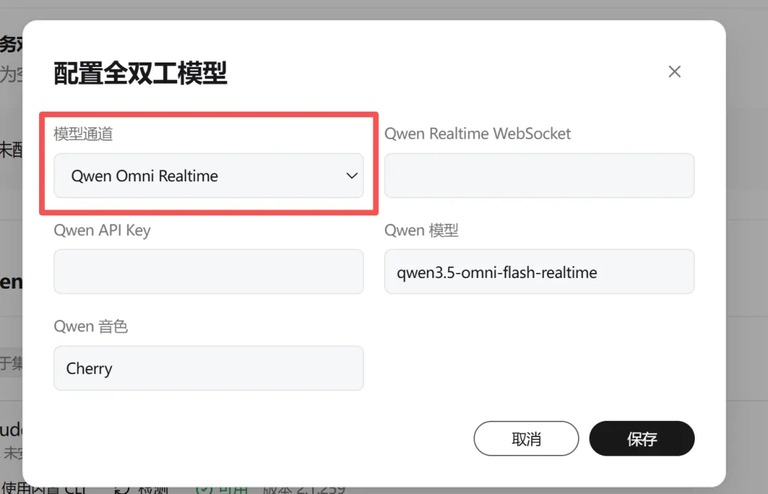
Qwen Omni 那条通道,填官方地址或者本地部署地址都行。
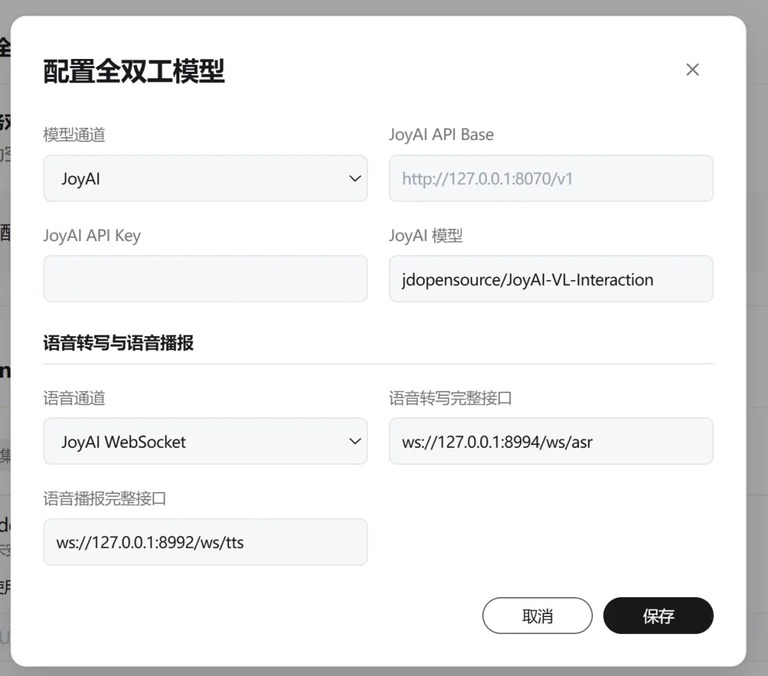
JoyAI 则是把三种模型拼在一起。
拆开也能用。
语音识别、语言模型和语音合成,各用一家也可以。
这套能力还支持在昇腾系列的算力卡上本地部署。
借助华为云的 ModelArts 平台和 vLLM-Omni 推理框架,可以把全双工多模态模型跑在自己手里,再对接回它的全双工能力。
在线体验和资源入口,官方都放在了 openjiuwen.com 上。
Gemini会员中转站 微信:douhanq
