

AI 助手把你刚升的职位说错了。
你的第一反应大概是,它又在胡说。
真的如此吗。
不一定。
它可能整理对话时就记岔了。
也可能旧记录还在。
新职位压根没覆盖上去。
还可能记忆里存对了。
回答那一步却换了个头衔。
用户看到的,是同一句错话。
出错的位置,却完全不同。
这个问题以前很难被拆开看。
中国电信研究院与上海记忆张量公司等研究者提出了一套评测基准。
名字叫 HaluMem。
它把评测插进记忆系统的内部操作。
信息怎么被提取,怎么被更新,最后怎么被用来答题,逐环核对。
论文已被自然语言处理领域顶级会议 EMNLP 2026 主会接收。
一个形象的说法是,笔记本身写错了,翻得再熟也只是更准确地找回错误。
要判断 AI 的记忆靠不靠得住,得看笔记怎么写出来,怎么被修改,又怎么被使用。
一、同一个错误答案,背后可能是三种故障
现有评测大多走端到端问答。
给一串对话,再提问,然后比对答案。
这能看出系统最后答得准不准。
却看不出它为什么不准。
对多数 AI对话 助手来说,这个盲区一直都在。
HaluMem 的做法,是给中间每一步也配上可核对的标准答案。
它拆成三环。
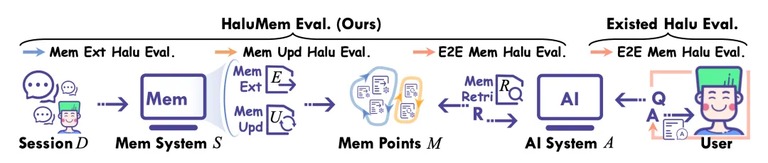
第一环是记忆提取。
该记的信息有没有被完整记下。
有没有把虚构的细节一起写进去。
举一个例子。
用户说,我最近开始喜欢鹦鹉了,以前确实不喜欢。
系统却提取成,用户不喜欢鹦鹉。
错误在写入的第一步就已经发生。
问题就出在这里。
第二环是记忆更新。
新信息进来后,旧记忆有没有被正确改写。
有没有漏改。
有没有改错。
有没有留下互相冲突的两条记录。
有一类情况更隐蔽。
助手顺口编出的细节,被系统当成了用户事实。
用户从没确认过,它却已经进了长期记忆。
一次未经证实的表达,就可能成为下一次回答的依据。
这就不只是记性差。
第三环才是记忆问答。
系统最终能不能靠这些记忆答对。
答错和因信息缺失而答不出,各占多大比例。
这三环按对话的时间顺序走。
相关会话一处理完,检查就立刻触发。
所以报告出来的不只是一个总分。
还能看到问题卡在哪一环。
二、给 AI 一段十余年的人生,再加百万级干扰
要判断记忆有没有出错,先得知道某一刻它究竟该记住什么。
真实的聊天记录给不了这么完整的标注。
偏好会变。
旧信息会过时。
有些事实还藏在上下文的缝隙里。
只在对话结束后补几个问答,很难还原整条记忆的演变。
HaluMem 为此造了一条六阶段的数据流水线。
从用户画像出发,搭出人生发展的骨架,再展开成事件流。
接着生成会话摘要和记忆点。
最后才是多轮对话和评测问题。
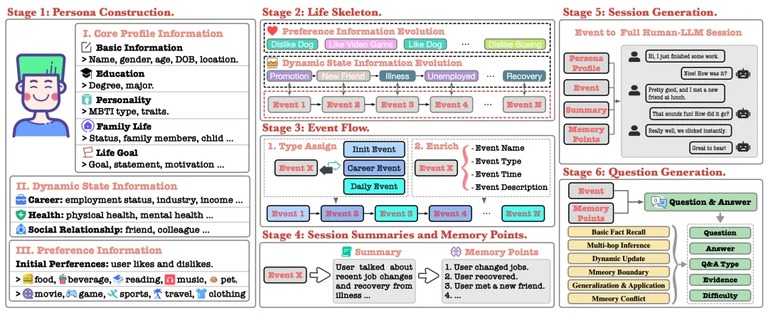
这套流程模拟的时间跨度是十到二十年。
职业变化,健康状况,兴趣偏好,人际关系,都沿着时间往前走。
记忆分成画像、事件与关系三类。
有更新时,数据会保留新旧信息之间的对应关系。
该怎么改,事先也有据可查。
生成对话时,研究者还故意放进两类噪声。
一类是助手误引或凭空编出的细节。
另一类是隐含表达和指代。
系统既要挑出值得保存的信息。
也要判断哪些说法还没得到用户确认。
数据集分成两版。
中等版覆盖 20 位用户,共三万零七十三轮对话,平均每位约十六万词元。
里面有一万四千九百四十八个记忆点和三千四百六十七个问答。
长版保留同样多的有效记忆,却在会话内外插进大量无关对话。
每位用户的上下文被撑到百万词元量级。
总对话数达到五万三千五百一十六轮。
设计的关键点在这里。
长版多出来的是干扰和上下文负担。
需要记住的核心事实,一条没加。
两版结果的差距,正好能看出系统在更长更嘈杂的交互里还剩多少记性。
问题也不只考记没记住。
六类问答覆盖的东西很杂。
有基础事实回忆,也有多跳推理。
还有动态更新和记忆边界。
泛化应用与记忆冲突同样在列。
它既要答出用户现在的状态,也要识别问题里预设的错误前提。
甚至要能承认,某条信息从来没被提供过。
为检查数据质量,研究者对中等版里的七百段会话做了人工评估。
覆盖超过一半的会话,逐条核查记忆点与问答。
人工检查得到的正确率是 95.70%。
三、记得多和改得少,都可能掩盖问题
参评的有 Mem0,Mem0-Graph,Memobase,MemOS,Supermemory 和 Zep。
六套系统。
两种上下文规模,各测一轮。
更新任务检索前十条相关记忆核验,问答任务检索前二十条。
答案统一由同一款通用模型生成。
Zep 因为官方接口拿不到会话级的提取记录,没有报告提取指标。
先说覆盖。
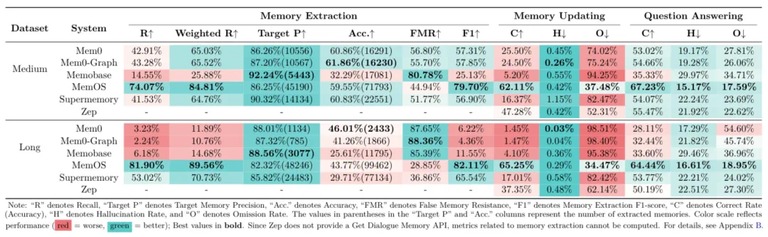
中等版上,Mem0 和 Mem0-Graph 的记忆召回率分别是 42.91% 和 43.28%。
Memobase 只有 14.55%。
也就是说,相当一部分本该被记住的信息,在提取环节就没留下来。
换成百万词元的长版,三者进一步跌到 3.23%、2.24% 和 6.18%。
核心记忆一条没变,只是加了无关对话,部分系统就漏掉绝大多数目标信息。
另一端也有麻烦。
MemOS 在长版上的召回率高达 81.90%。
Supermemory 也有 53.02%。
覆盖的目标记忆更多,干扰过滤不足的问题也跟着露出来了。
这套基准用虚假记忆抵抗率,衡量系统能否忽略助手提过、但用户没确认的干扰记忆。
数值越高越好。
长版上,MemOS 和 Supermemory 分别是 28.85% 和 36.86%。
覆盖面扩大,并不自动带来更强的真假分辨力。
可靠的记忆要同时做到两件事。
该记的不能漏,不该信的不能存。
单看召回率或者记忆条数,都容易忽略另一侧的代价。
再说更新。
只看更新幻觉率,结果相当乐观。
主实验里,所有系统在两个版本上的这一项都低于 1.2%。
把遗漏率放在旁边,画面就变了。
长版上,六套系统里有五套的更新遗漏率超过 60%。
Mem0 和 Mem0-Graph 分别达到 98.51% 和 98.40%。
对应的正确更新率只有 1.45% 和 1.47%。
MemOS 的正确更新率最高,65.25%,但仍遗漏约三分之一的目标更新。
为什么很少改错,会和大量漏改同时出现。
因为更新幻觉率的分母,是那些真正执行过的更新。
大量更新压根没做,错误更新的比例自然也就很低。
这个数单独看,判断不出系统有没有真正掌握更新。
而且更新还依赖前面的提取。
旧事实要是从没被存进去,后面根本没有可改的对象。
操作级评测在这里揭出一个重要关联。
更新不足,可能从第一次写记忆的时候就已经开始了。
最后看回答。
统一的问答设置下,所有受测系统的正确率都没到 70%。
MemOS 在中等版和长版上分别是 67.23% 和 64.44%,是两组里的最高值。
但离稳定可靠,还有明显距离。
有些系统在长上下文里掉得特别厉害。
Mem0 的问答正确率从 53.02% 掉到 28.11%。
问答遗漏率同时从 27.81% 升到 54.60%。
这个变化,和它上游记忆召回率的暴跌完全对得上。
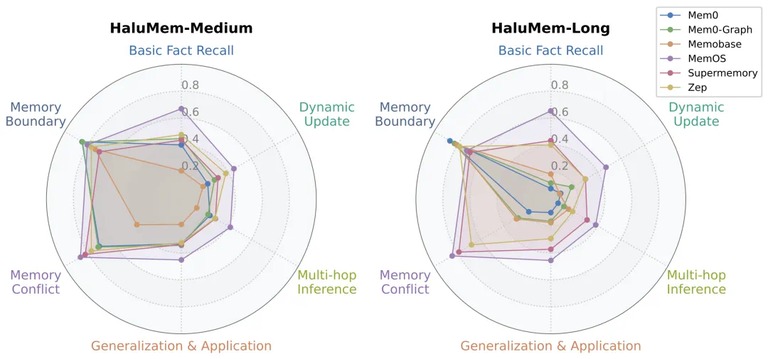
不同题型还暴露出能力差异。
多数系统在识别未知信息或错误前提时表现还行。
碰到多跳推理、动态更新和泛化应用,短板就很明显。
最终答案是整条记忆处理过程的共同产物。
想改善回答,得同时检查三件事。
事实有没有被记下。
变化有没有被更新。
检索出来的信息有没有被用对。
论文还随机抽了十位用户,换了一款模型做裁判复评。
具体分数有变化。
整体排名没变。
主要趋势也没变。
提取覆盖与干扰抵抗之间的取舍没变。
更新遗漏严重这一条也没变。
四、从能记住到记得可靠,还缺什么
这套基准的价值,是把改进方向说得更具体。
如果问题出在提取,就得同时看信息覆盖和来源可信度。
如果问题出在更新,就得查新旧记忆的关联,以及该做的修改到底做没做完。
如果问题出在问答,还要结合上游记录和检索结果继续往下挖。
这也解释了为什么单看一项漂亮指标不够。
高召回可能伴随虚假信息被写进去。
极低的更新幻觉率可能伴随大面积遗漏。
而最终问答分数,则可能遮住内部不同环节的失败。
当然这项工作还有可扩展的空间。
当前数据围绕模拟用户的画像、事件和关系记忆展开。
工具调用、技能插件等其它记忆形态,还没有全面覆盖。
不同系统开放的接口,也会影响内部操作能被观测到什么程度。
但它已经给出一条可复用的评测思路。
把最终答案背后的记忆操作逐一摊开核对。
让哪里出了错,从一句抱怨变成可以测量的问题。
回到开头那个把新职位说错的助手。
下一次我们除了问它为什么又答错,还可以多问三句。
这条信息最初记对了吗。
升职之后改过了吗。
回答时用的到底是哪一条记录。
一个愿意把记忆过程摊开给你看的 AI工具,才是更值得托付的那种。
而当这些问题都能被逐一回答,AI 距离真正可靠的长期记忆,才算有了清楚的改进路径。
