

9 月 4 日凌晨,OpenAI 放出了新一代旗舰模型 GPT-6 Astra。
让它出圈的不是跑分。
是一段演示。
有人让它在虚幻引擎里造一座曼哈顿。
它花了一周。
一条街一条街地搭。
另一次测试更夸张。
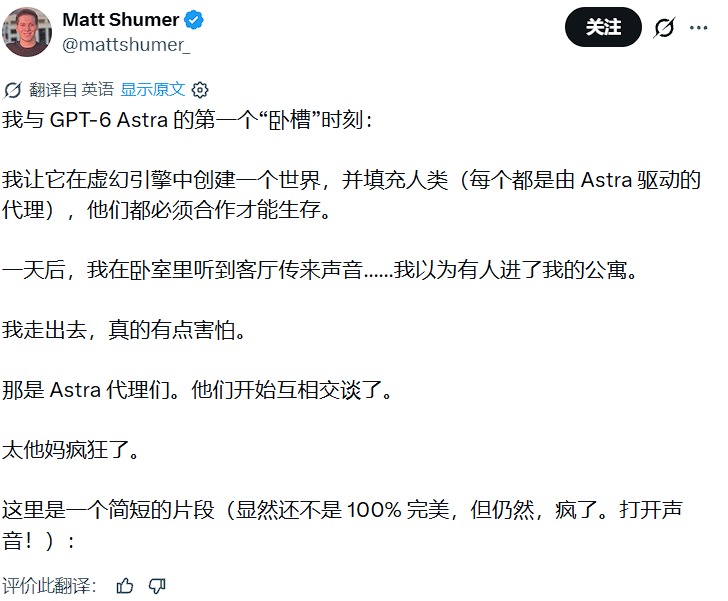
那位开发者让它建一个虚拟世界。
世界里每个人都是独立的智能体。
任务启动后他去睡觉了。
第二天,他在客厅里听到了那些虚拟人的说话声。
发布会的最后,这家公司的总裁说了一句“欢迎来到通用人工智能时代”,这话当时没人真的当真。
但第一批拿到模型的人,已经开始用真实任务试它的边界。
比起跑分,实测里的细节更有意思。
一、它会自己回头检查结果
第一份测试报告来自一位开发者。
他让它在三维软件里做一艘 4K 飞船模型。
更值得看的不是模型,是过程。
它会打开刚做完的页面。
检查元素,读一遍报错,改完再测一遍。
过去的模型是做完就交卷。
它多了一步自我核对。
这是自检。
当然它也会错。
这位开发者说,它不是每次都完美。
关键是它能自己发现问题,也能自己修。
另一位测试者的玩法更直接。
他让它在同一个三维软件里做一个游戏。
游戏能直接在浏览器里跑。
从开始到能玩,大概半小时到两小时。
中间没有人插手。
他后来把这次测试当成了衡量模型能力的新标准。
这类活过去得靠 AI编程 工具一段段写。
现在它自己走完了全程。
二、它开始直接上手操作软件
接下来他们把镜头对准了专业剪辑软件。
要做的是一整套后期流程。
导入素材,调色,同步片段。
它得打开软件界面。
自己点按,自己拖拽。
不再只输出文字建议。
那是一段将近两小时的直播评测。
两个人一边看它操作,一边实时反应。
他们最后给了它最高的评级。
同时也吐槽了它的毛病。
毛病出在收尾。
它有时做完一个中间步骤就停下来。
话说得很含糊,让人以为整件事已经完了。
后面其实还有活没干。
这种“看起来完成了”,比明显报错更麻烦。
三、它能干一星期,但还不能放手
演示很夸张。
长任务一跑起来,问题就露出来了。
第一个问题是钻细节。
它会花大量时间打磨某一栋楼的纹理。
反复调试某个虚拟人的行为逻辑。
别的街区还荒着。
你让它建一座城市,它有可能沉迷于把其中一栋楼的门把手做得特别精致。
得有人在旁边提醒一句,差不多行了,先往前推。
第二个问题是它不知道什么时候该停。
整个项目里,那位测试者做的其实更像项目经理。
他要判断当前阶段是不是该收尾。
他还要决定下一步做什么。
关键决策也得由他把关。
它负责执行,方向得人来定。
与其催它加快节奏,不如先把终点写清楚。
两条放在一起看,结论就比较清楚了。
它能把任务推得更远,也能推得更久。
但它还不会自己定义终点。
目标清晰的时候它干得又快又好,目标模糊的时候,旁边就得有人一直引导着往前走。
想图省事就彻底撒手,现在还不是时候。
更早的时候,这类能力装在一个 AI对话 窗口里。
现在它更像一个极其靠谱的执行者。
差距就在这里。
执行者可以被交付一件具体的活。
合伙人得自己找活干。
最后说回这批实测本身。
它们大多来自提前拿到模型的开发者和从业者。
任务设计不统一,环境也不一样。
所以这些案例更适合用来看能力边界。
不适合当成严格横评。
一个能自己检查结果的 AI工具,价值不只是省时间。
它把“差一点完成”这个老毛病往后推了一截。
但真要让那座数字城市运转起来,盯着屏幕的人一个都没少。
