

拍了几十年的月亮,数据先成了麻烦
人类拍月亮已经拍了几十年。
从阿波罗时代的胶片,到绕月探测器持续传回的高清影像。
这些资料攒在一起,是一份体量惊人的月球信息库。
麻烦也跟着来了。
数据越积越多,想真正看懂反而越来越难。
一张张翻,人眼翻不完。靠人工标注,更标不过来。
NASA 给这件事找了个 AI 解法。
它和 IBM 研究院长期合作。合作的还有多家学术机构。它们一起推出了 NASA-IBM 月球基础模型。
这是第一批专为月球科学开发的开源模型之一。
模型和配套数据都已经公开。研究人员拿来就能接着训练,再适配到自己的任务上。
这种做法省掉的是重复造轮子的成本。过去每做一个新任务,团队都得从零搭一套模型,再自己凑数据。有了共用底座,后面的人只要接一小段微调就行。
这不是一个陪你聊天的产品。它更像一台专读月面的仪器。
判断它好不好用,不看话术,看它在几件苦活上做成什么样。
它不是普通的多模态,是奔着尺度去的
这套模型不是把月球照片丢进一个视觉模型就完事。
它用了多模态、多分辨率的设计。
训练数据大约覆盖 11 种模态,同时横跨约 1 米和 100 米两种尺度。
数据来自月球勘测轨道飞行器过去 17 年收集的成果。
这个体量比所有其他行星任务加起来还大。
整个月球的高分辨率拼接图,几乎被无缝拍了下来。
模型在这批数据里约 200 万张图像瓦片上训练。
里面有超过 100 万张 1 米分辨率的高清相机图像。
另有近 96.4 万张 100 米分辨率的多光谱图像。
这么多图,走的是 ViT-B 编码器加解码器的架构做预训练。
模型一边学,一边从不同数据里补全缺失的信息。
它要学的不只是像素。照明角度要学。太阳参考坐标要学。连地理范围也算在内。
除了主数据集,它还吃过别的料。
GRAIL 重力探测任务的成果。月球探勘者号。日本宇宙航空研究开发机构的地形数据。
喂进去的类别越多,模型对地形的理解就越厚。
代价是训练和调参的门槛也跟着抬上去了。
这类底座的取舍一直很清楚。通用性强了,单点上就未必最灵。想要极致精度,往往还得拿自己的小样本再练一轮。
三件硬活:找冰,认火山,数陨石坑
预训练完之后,模型被推去做几件现阶段很难的任务。
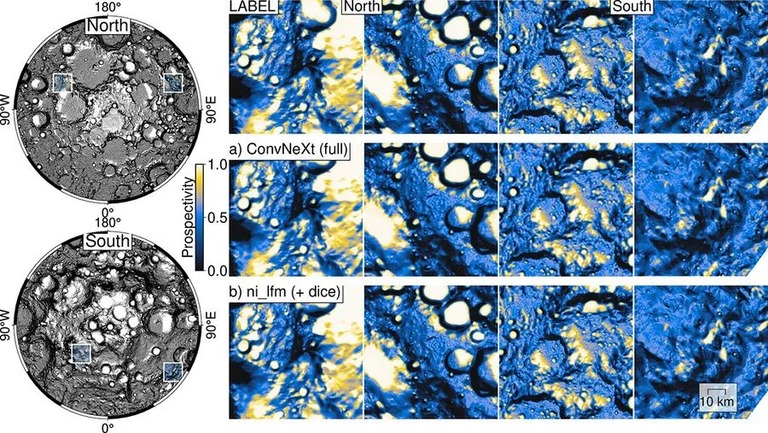
第一件事是找月球极区可能存在的冰。
那些永久阴影区常年黑暗,温度极低,冰层能在那里保存几十亿年。
它还能帮研究者判断冰层在表面和地下可能出现的位置。
看懂这些冰,就是在读月球的旧账,也为未来的太空活动勘路。
第二件事是找年轻的火山结构。
月球一般认为已经不再活跃。
可它的表面还有些被叫作不规则月海斑的异常地貌。
这些结构看上去相对年轻。
它们到底怎么来的,会影响科学家对月球冷却和热演化史的理解。
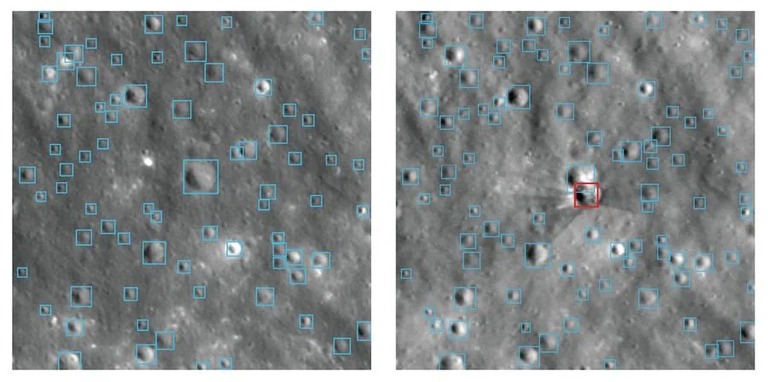
第三件事更经典,是陨石坑识别。
这些撞击形成的环形地貌铺满月面。
它们的数量、分布和尺寸,能帮科学家判断不同区域的年龄。
再往前推,就能重建太阳系早期的历史。
三件事里,找冰最考验模型的泛化能力。陨石坑识别反而最吃标注积累。
它的边界也摆在那里。模型读的是影像和地形,推不出没拍过的地方。极区永久阴影带光线本身就弱,样本稀,结论最终还是得靠人去核。
跟强基线比,它赢在哪
整体看下来,它跟其他几个强基线模型放在同一个 排行榜 上比,做到了持平甚至更好。
三件里它占优一项。另两项打成平手。
陨石坑测绘和不规则月海区域的分割上,结果相当。
估算极地冰层稳定性这一项,它明显占优。
这个优势不算意外。冰层判断靠的是多模态信息的交叉印证,单一图像模型很难补上。
这次发布是该机构首席科学数据官办公室 AI4S 战略的一部分。
它归属两家机构之间那项规模更大、还在持续的合作。
同一批成果里还有别的模型。
用地球观测数据预训练的 Prithvi,能做灾害检测和洪水测绘,也能预测作物产量。
用高分辨率太阳观测数据训练的 Surya,用来盯太阳耀斑这类空间天气。
为方便全球科研社区接手,团队一并放出了预训练数据集和基准测试集合。
给的不只是模型,还有数据和测评尺子。这才是这批成果最实在的地方。
别人复现得出来,也就能在同一张尺子上比出高下。
模型被集成进开源工具包 TerraTorch。
配套论文挂在开源模型社区上,结果可重复。
靠一次 AI对话 式的问答,解决不了这些活。科研要的是可复用又能比较的底座,最好还能持续优化。
这套东西真正的价值不在演示。它让几十年没人看得完的月面数据,变成一个能被反复调用的 AI工具。
对做研究的人来说,这比多一个漂亮的演示重要得多。
宁可先把它当底座用起来,也别指望它替你给出结论。
