

天文观测大概是最容易让普通人产生浪漫想象的一类科学。
巨大的穹顶缓缓打开,镜筒转向几亿光年之外。一束从宇宙深处赶来的微光落进探测器,人类才知道那里几百万年前出现过超新星、伽马暴或者中子星合并。研究的问题也从重元素从何而来,一路盖到恒星如何死亡。
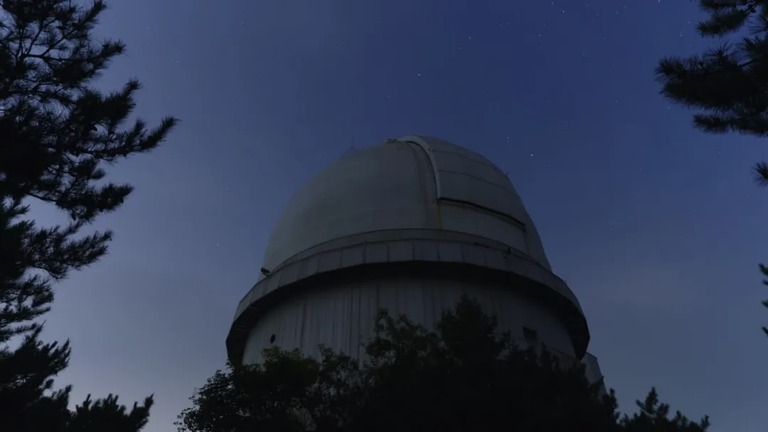
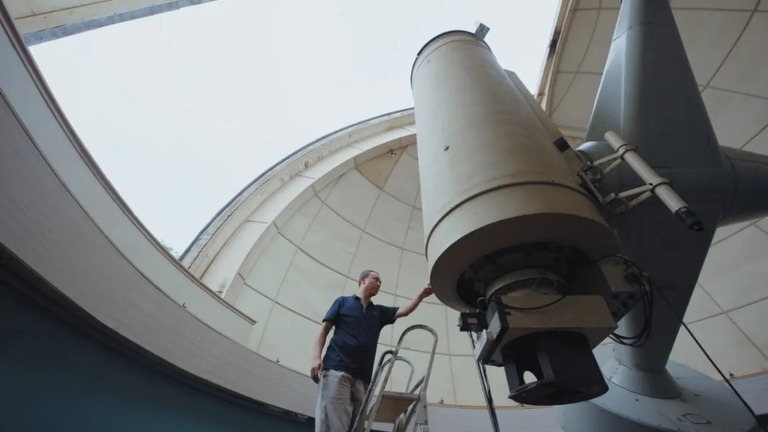
但这份浪漫落到具体的望远镜上,会变得琐碎又辛苦。冬天夜长,国家天文台兴隆观测基地一次值班常常要熬十几个小时。值班人员得整夜守着望远镜和控制软件。盯目标位置,看天气,查设备状态,调参数,排任务。
地球在转,目标也在移动。云层、湿度和月光都会影响观测。机械、网络和供电也可能出状况。只按既定计划守一晚,就已经够累。
对瞬变观测来说,麻烦还不止夜班长。超新星和伽马暴无法提前推算。爆发初期亮度和光谱变化极快,有些特征过几个小时或者几天就消失了。发现得越早,跟得越快,留下来的数据才越完整。
中国科学院国家天文台高级工程师、兴隆观测基地天文组负责人郑捷,把这种情况形容成「天上掉馅饼」。
而「看到馅饼掉下来」本身就是复杂的第一步。瞬变意味着原定任务要被打乱。今晚已经排了三个科学任务,预警系统突然报出一颗疑似极早期超新星。这个目标重不重要。它现在是否在可观测区域。天气允许吗。哪台望远镜能接手。原来的任务又该挪掉哪一个。这些判断要在极短时间里做完,接着还要逐级协调排程与设备调用。
今年,国家天文台科研团队在千问办公的协助下做了一次新尝试。基于千问办公的 Agent Harness,团队用不到 3 天、千元左右的成本,搭出一套科研级望远镜仿真环境。望远镜组件和传感器接口被包装成 MCP,智能体可以读取设备状态和可观测条件。随后相关框架又接入了「司天」探路者和「司天」原型机。
望远镜自动化早就有,为什么还要智能体
望远镜自动化不是大模型时代才有的技术。简单分一下,可以拆成三步。发现异常,分析异常,资源调度。
最成熟的是资源调度。拉斯坎布雷斯天文台把全球 7 个站点的 27 台机器人望远镜当成一个整体运行。科研人员提交观测请求,中央调度系统按目标可见性、天气和设备时间窗口安排任务。某个站点天气变差,任务可以被重新分配到别的站点。整个网络的计划每小时会重算多次。
发现异常这一侧也有进展。2026 年 2 月 24 日,薇拉·鲁宾天文台一个晚上发出约 80 万条科学告警。系统全面运行后,这个数字预计最高到每夜 700 万条。天空里的一次变化被发现后,公开告警大约两分钟内就能发出。
候选数量能随着巡天能力迅速增长,适合做后随观测的望远镜时间却始终有限。于是新问题出现了。这些海量异常到底值不值得跟。先跟哪一个。有限时间里用哪台设备跟。判断的代价并没有同步下降。
国家天文台相关团队从 2025 年起就开始试着用 AI 解决这件事。公开资料显示,星语望远镜由国家天文台银河系三维结构组与兴隆观测基地合作开发。它以千问为基础模型,把观测计划、望远镜控制和数据处理放进同一套智能体框架,再部署到多台望远镜组成的观测网络上。它能生成观测列表,控制设备,处理数据,发现新的瞬变后继续触发后随任务。这项工作被写进斯坦福大学以人为本人工智能研究院发布的《AI Index Report 2026》。在报告里,它是 2025 年物理和天文领域,以及化学与材料科学领域的代表性智能体。
固定工作流能把模型、程序和望远镜接口提前串起来。对于确定的流程,这种方式很好用。可到了真实现场,用什么波段,曝光多长,安排在哪个时间窗口,天气和设备状态怎么算,临时冒出来的高价值目标怎么处理,这些参数和流程仍然需要人回来调。
考虑到智能体能在运行时选择工具、读取结果再决定下一步动作,团队开始把尝试往设备一侧推进。
但一个问题绕不过去。新的控制方式需要大量测试,真实望远镜经不起这样的试错。
先造一台能反复试错的仿真望远镜
一台科研望远镜比多数人想象的要复杂。国际上主流的 10 米级地面光学望远镜,一个有效观测小时的运行成本可以达到数万元。钱还只是一部分。镜筒、转台和相机,还有大量传感器彼此联动,错误控制可能带来设备风险。正常科研时间也不可能专门腾出来,让智能体反复尝试各种失败策略。某台单体望远镜临时故障、几颗高优先级目标同时出现,这类情况在现实中根本没法按开发计划排练。
所以在千问办公的协助下,团队先给智能体准备了一台仿真望远镜。
过去开发一套专业仿真系统,需要科学家先把观测流程、设备逻辑和实验需求讲给软件团队。开发人员实现之后再交回来验证。遇到偏差就继续改。按项目团队的说法,同类开发往往要数月和数万元。
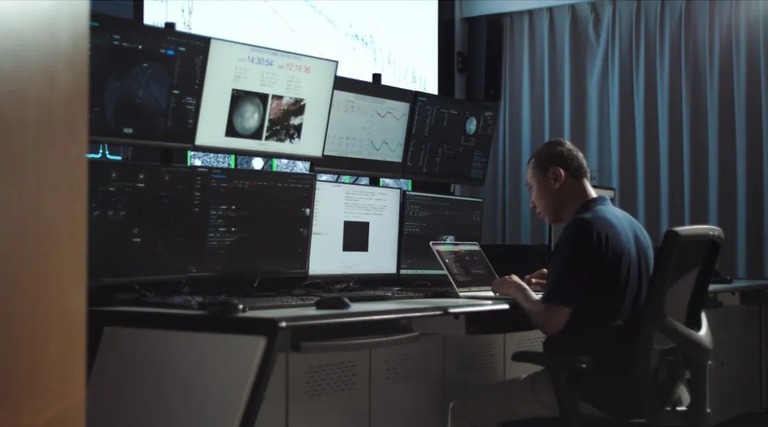
千问办公把这段过程压缩到了 3 天左右。第一版仿真系统没有追求复制一台真实望远镜的全部物理行为,它先把一次观测的数据链跑通。
假设系统收到一颗刚出现的超新星候选。专业模型先判断候选的性质和大致演化阶段,天文程序根据时间、台站和坐标,算出它现在能不能看,还能看多久。天气系统返回云量、风速和湿度,设备端给出当前状态。这些数据的获取都有各自成熟的工具。智能体直接读取程序返回的结果,再把它们组织成一份观测计划。什么时候开始,用什么波段,曝光多长,放在当前队列的哪个位置。
计划生成以后,再通过 MCP 调用仿真设备。望远镜完成模拟指向和曝光,数据进入原有处理管道,分析结果回到下一轮计划。设备能做什么,也提前写进了接口。机械限位和合法参数范围,还有强制停止条件,都由底层系统约束,重要节点仍然保留人工确认。一次任务里验证有效的方法,还可以沉淀成后续调用的技能。
第一版跑通数据流以后,团队开始加入硬件响应。真实设备日志被用来模拟电机等组件收到指令后的运动,传感器和控制器逐步进入这套环境。观测任务怎样落到设备动作,设备状态怎样反过来改变计划,最终都在同一个仿真环境里发生。
有了这套系统,过去观测中的选择困难会变成历史。假设晚上同时出现三颗值得跟踪的候选。A 的科学价值最高,但两小时后会落到低空。B 的条件很好。C 刚刚爆发,早期特征消失得最快。原来的队列里还有排好的任务,凌晨天气又开始恶化。真实望远镜只能选一条路线。仿真里可以把各种可能和环境变量提前演练很多遍,再加速现实中的判断。
目前团队已经在仿真系统里,把同一批目标和同样的天气变化交给不同调度策略,比较最后拿到多少有价值的数据,又漏掉了哪些目标。设备故障和多目标竞争这些现实中难以重复制造的情况,也可以主动加进去。链路跑通之后,智能体开始和天文望远镜一起,对准真实夜空。
从一颗候选到一个观测对象
仿真解决的是策略演练,真实瞬变链路解决的是另一个问题。机会真的出现时,怎么让它更高效。
团队先从发现端抢时间。单台望远镜拍摄同一区域,两次拍摄之间的间隔可能比较久。如果超新星爆发的关键变化正好落在两次观测之间,有价值的信息很容易错过。国际天文团队为此训练了一套跨波段光变基座模型,把来自不同波段和不同望远镜的数据在时间上对齐。原本分散的观测点组合起来,时间采样会更密,也就能更早识别处于爆发初期的候选。
候选出现以后,真实的观测工作沿着和仿真环境相似的链路运行。在千问办公的 Harness 框架里,模型先给出候选信息。专业程序继续计算可见性,天气和设备状态被读入。相关工具通过 MCP 接入智能体,定时任务持续检查新的结果。智能体根据当前任务形成后随方案,还能通过消息系统通知科研人员,触发下一步操作。
截至当前,这套框架已经接入「司天」探路者和原型机,预警约 8 颗极早期超新星候选,其中 2 颗在天气条件允许时触发了后续观测。
对比过去,传统观测里一条预警弹出来,接下来是一套线性流程。值班人员开始逐项查目标,查天气,算可见窗口,看设备,再调整原来的队列。链路连通以后,智能体可以随着候选出现一起启动,并行推进。科研人员看到一颗新目标时,能同时看到它大致处于什么阶段、当前有没有观测条件,以及系统给出的后随方案,再做最后的科学判断。
单台望远镜的控制只是开始,真正的挑战是望远镜阵列。
提到阵列,绕不开「司天」工程。这是我国面向时域天文学提出的大型分布式米级巡天望远镜阵列项目,目前已经入选联合国教科文组织「科学十年」认证计划。按官方介绍,它希望构建覆盖全球的百余台 1 米级宽视场光学望远镜。这些设备对全夜空做高频次和多色持续监测,寻找超新星和中子星合并,还有黑洞潮汐瓦解恒星等极端事件的早期信号。
在这个网络里,哪几台负责持续巡天,哪一台去观测突然出现的目标。两个站点都能看的时候该选谁。一个站点天气恶化以后,排队中的任务怎样重新分出去。哪个事件值得多台设备同时跟进。这会是一套更复杂的调度系统,也是一件只有借助智能体才能完成的事情。
尾声
一边是几亿光年之外的恒星爆发,一边是企业级的 AI 智能体。过去很难把这两件事联系起来。
但本质上,从办公到生产再到科研,工作中被消耗掉最多的时间其实都差不多。从一个系统拿到信息,交给另一个程序处理。看完结果,再决定打开哪个软件、改哪组参数。计划一变,后面的流程重新接一遍。这些十几分钟、几十分钟的提升,放在一天的工作流里并不起眼。
也正是在这样的地方,千问办公这类 AI办公软件 的边界,正从办公室伸向科研现场。而对天文团队来说,可用的 AI工具 也早就不是写材料那么简单。
当一束光走过几万年甚至更久才抵达地球,让我们能仰望天空、想象自己在群星中的位置时,留给人的时间窗口只有昂贵且不可逆的几个小时。这时候,哪怕 1 分钟的加速也很珍贵。
