

一段人坐上椅子的视频,对人来说再普通不过。你不仅看见「人坐下来了」,还知道椅子在承重。人和椅面贴住了,身体最后停稳。重力、接触和受力,这些关系共同构成了真实世界里的物理交互。
但对今天的三维重建系统来说,「看见动作」和「重建交互」是两回事。一个视觉上准确坐在椅子上的人体,扔进物理仿真后,椅子可能因为结构缺失散架。人体也可能和椅面严重穿模。画面里成立。物理上不成立。
近日,大晓机器人联合两家机构发布了一项研究。合作方是南洋理工大学 S-Lab 和上海人工智能实验室。项目叫 HSImul3R,做的是人–场景交互重建。它盯的是三维视觉里长期存在的那道缝。感知和仿真之间,一直隔着一层。
这套框架想把三维重建从「视觉正确」推到「物理可执行」。这项工作已被 ECCV 2026 正式接收。
旧方法的评价标准,大多是人和场景重得像不像、对得齐不齐。新框架把重力稳定性、真实接触和交互稳定性一并纳入。团队称它是首个面向非标定稀疏视角输入的重建框架,能做到稳定可仿真。它还支持单目视频输入。
数字能说明差距。难度递增的三档任务里,这套框架的表现是这样。稳定率 53.68%、30.56% 和 13.92%。对照组只有 10.52%、4.50% 和 2.66%。人–场景三维穿模率也从 69.51% 降到 22.90%。
论文和项目主页已经公开。arXiv 编号 2603.15612,代码仓库也一并放出。
从「视觉正确」到「物理成立」
近几年,三维重建、人体运动估计和人–场景交互建模一直在往前走。机器从图像和视频里恢复三维世界,理解人类行为的能力不断提升。可传统方法的主要标准,仍是几何准确、姿态还原和视觉对齐。回答的问题更像「人和场景重建得像不像」。
麻烦在于,机器人最终面对的是一个真实世界。重力和碰撞说了算,摩擦和接触也在里面起作用。一个视觉上高度可信的场景,进了仿真器可能立刻失效。椅子因为结构缺失站不稳,人体和物体发生穿模。原本看着正确的交互,就这么不成立了。
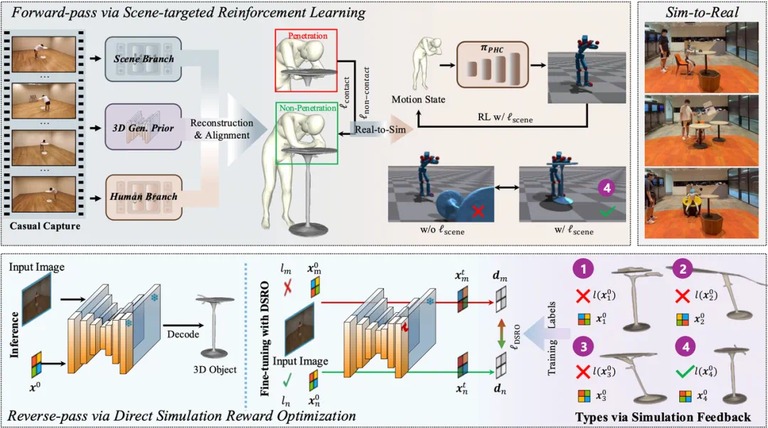
▲HSImul3R 概览图
这套框架因此把标准往前推了一步。它不要求人和场景在画面里对齐。它要求重建结果能真正进入物理仿真,并且保持原来的交互关系。
更关键的地方在顺序上。它不走「先重建、再用仿真器验证」的老路,而是让仿真反馈直接参与重建。正向过程优化人体。反向过程修正场景。仿真器从最后的裁判,变成了过程中的监督者。
动作可行还不够,交互得真正成立
物理闭环的第一步,是让恢复出来的人体运动真正适应当前场景。传统动作跟踪和强化学习更关注人体自身稳不稳,动作离原始轨迹远不远。问题是,人体动作物理上成立,也可能已经偏离了原来的人–物关系。
举个例子。一段「坐在椅子上」的动作,经过普通运动优化后,人体可能为了保持平衡而偏离椅子。人没摔倒。可「坐椅子」这个交互已经没了。对具身智能来说,只做到动作可行显然不够。
▲去掉面向场景的强化学习后,仿真里出现了非预期的物体位移,交互难以稳定
为此,团队提出面向场景的强化学习。它在运动跟踪的基础上,进一步加入场景交互约束。系统会看人体关键接触点和物体表面的空间关系。优化后的动作既要忠实于原始观测,又要和当前场景保持正确稳定的接触。
换句话说,它优化的不是一条抽象意义上「符合动力学」的轨迹。它优化的是一段能在特定场景里真正成立的物理交互。「坐下」意味着人必须真的坐到这把椅子上,而不是在空间里复现一个相似动作。
用真实交互反过来优化三维世界
但仿真失败不一定是人动错了。也可能是场景本身没重建对。人类遮挡严重的场景里,桌腿椅腿这类结构往往很细。图像生成三维模型容易丢掉结构,或者把几何形状做歪。人体动作再合理,也撑不起真实交互。
针对这个方向,团队在反向过程里提出直接仿真奖励优化。做法很直接。把物理仿真的交互结果当作监督信号,去反向优化三维物体的生成模型。评价标准也跟着变了。从「物体自己能不能站稳」,提升到「人和它交互之后还能不能稳住」。
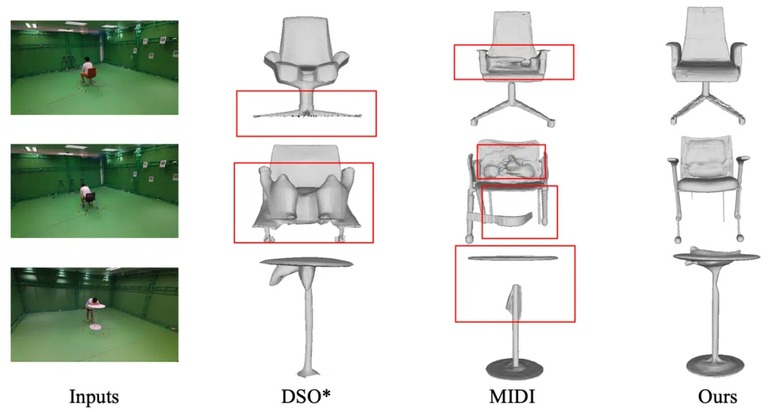
▲图像到三维物体重建的定性对比
团队把仿真反馈分成四种状态。从「物体在重力下失稳」,一直到「人和物体实现稳定交互」。物体自身要稳。交互之后还得稳。人和物体之间必须形成有效接触。三条都满足,重建才算真正成立。
所以一把椅子单独摆在地上不会倒,人坐上去却翻掉,它依然没有被重建对。这套标准的落点变了。从「物体自己是否物理合理」,推到「物体在人–场景交互里是否物理合理」。人类交互本身成了监督信号。
HSIBench:不只看像不像
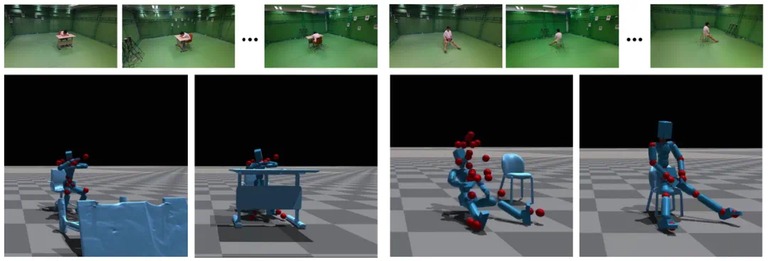
为了验证这套新标准,团队搭了面向人–场景交互的测速台。数据集里有 19 个场景物体。人体动作序列超过 50 段,独立交互实例有 300 个。3 名参与者完成采集,每个案例从 16 个视角同步记录。
和传统三维重建基准不同,这个基准把交互稳定性当作核心指标之一。它不只判断物体在重力下稳不稳。它还要求整个交互进入仿真后保持稳定,并且保留有意义的人与物体接触。三维重建不只要通过视觉和几何考试,还得过一遍物理实操。
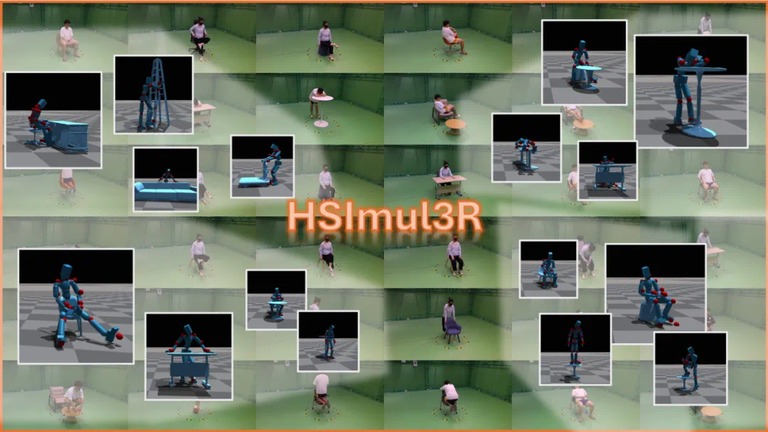
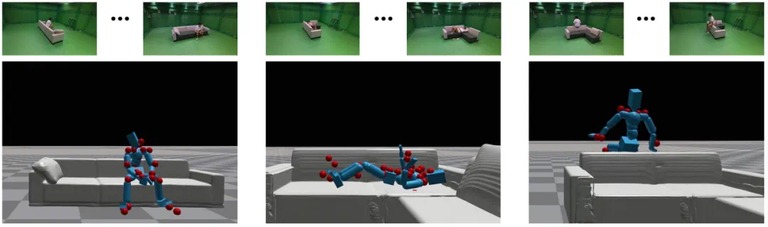
▲HSIBench 示例及对应的仿真结果
实验结果前面已经提过。三档任务的稳定率全面领先对照组,穿模率从 69.51% 降到 22.90%。这些数字说明一件事。当三维重建真正服务于具身智能,渲染得足够真实就不再是终点。重建出来的世界,还得承受机器人真实的动作和交互。
从人类视频到真实机器人
如果研究到仿真这里就停下,它完成的只是从真实世界到仿真的迁移。这项工作还有后半程,把经过物理优化的人体动作迁移到真实人形机器人上。
团队先把动作重定向到 Unitree G1。再把这些动作当成先验,在仿真环境里训练全身控制策略。最后直接部署到真机上。
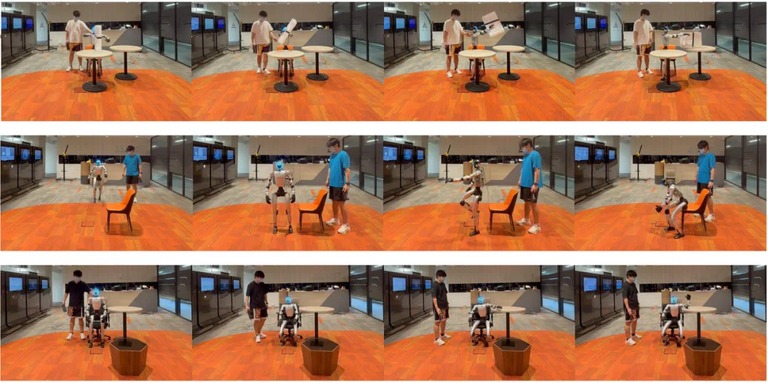
▲部署在 Unitree G1 上的仿真到真实结果
至此,一段人类视频里的行为走完了全程。先从图像或视频里恢复三维交互关系。再用物理仿真,修正那些看着合理、物理上却站不住的部分。接着把人体动作转成机器人能学的先验。最后交给真机重新执行一遍。
这打开了一条更有想象力的路径。互联网上已经堆着规模巨大的人类行为视频。这些素材过去大多被当成 AI视频生成的原料。如果其中的交互能被持续重建,也能通过物理验证。再迁移到不同机器人本体。它们就不再只是给机器「看」的数据,而可能成为机器人学习真实物理技能的重要来源。
后半程里有一段绕不开的活。训练全身控制策略要用到 AI编程。仿真环境里的策略迭代要靠它。动作重定向后的参数校准,也得靠代码跑出来。模型再强,也得有人把这一层搭好。
当然,这条路还在早期。复杂交互、多物体场景,还有动态环境,挑战都还堆在那里。但方向已经给出来了。机器人从人类视频里学的,不该只是人看起来怎么动。它还该包括,这个动作为什么能在真实物理世界里成立。
对普通用户来说,这套东西看着还远。可它决定的是另一件事。你在各种 AI工具里看到的那些演示视频,背后是一个个还在补物理课的重建系统。补完这一课,机器人才算真正看懂了人类那一下动作。
