

AI 智能体现在会调工具,会操作软件。
也能把几十步的流程一次跑完。
可它卡住的时候怎么办。
这是今年最实在的一个问题。
过去两年,模型能力一直在涨。
围着模型搭起来的智能体,接的活越来越重。
从问答,到调工具,再到独自跑完长流程。
与此同时,预印本平台上每天都有新的智能体论文挂出来。
最直觉的办法,是训一个更强的模型。
可实测下来,表现并不只由模型决定。
工具怎么调。上下文怎么留。
经验怎么复用。任务怎么拆。
这些细节都在改最后结果。
围着模型转的这套 AI工具 和流程,业内叫运行框架。
今年有研究试过自动改它。
做法是让一个会写代码的智能体去翻失败记录。
找到反复出错的地方。直接改框架代码。
再拿实验挑出更好的版本。
这条路能出成绩。天花板也很清楚。
智能体能想到的改法,超不出它脑子里已有的知识。
一种它没见过的失败。一个它不知道的解法。它想不到。
人遇到同样的墙会去翻论文。
看看别人提出了什么。再搬回自己系统里试。
那智能体能不能也这么干。
加州大学圣塔芭芭拉分校和微软的一个团队,做了一个叫 ScholarEvolve 的系统。
它把读文献,写实现,跑评测这三件事串成了自动流程。
一篇论文从挂出来到进生产系统,中间隔着阅读,复现,集成。
这三步过去全靠人。

这是论文首页,标题是 Learning from Research,作者 Jingbo Yang。
思路说起来不复杂。
不让智能体只靠自己那点经验找改法。
让它主动去文献里拿新方法。
阅读只是第一步。
难点在后面。
论文成千上万,怎么挑出真正不一样的方向。
又怎么把纸上的方法,变成能拼在一起的框架。
挑错了,后面的实验预算全白花。
为此它搭了一套自动的研究与演化流程。
先说结果。
底层模型一个字没改。
把一个 27B 模型在挑战赛上的完成率,从 49.6% 抬到 63.6%。
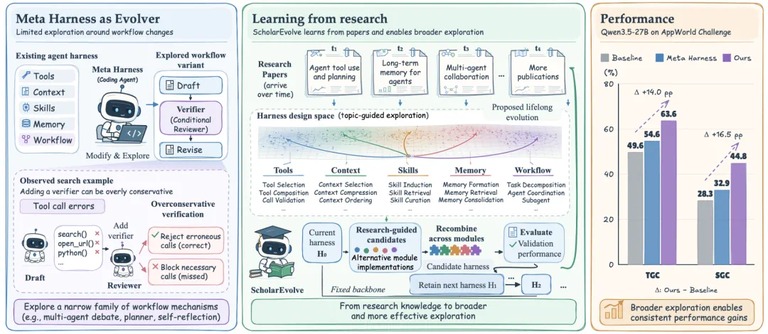
左边是 MetaHarness 那条老路,右边是 ScholarEvolve,横轴标着 Performance。
第一步,把运行框架拆成五个模块。
工具接口,上下文管理,技能,记忆,工作流。
拆开之后。改进就有了着力点。
经常丢历史信息,就去研究上下文压缩和记忆检索。
长流程跑不完,就去改任务规划和工作流设计。
第二步,让一个研究智能体去论文里找答案。
它先看执行轨迹,找出反复出现的毛病。毛病常常是零散的。
再把具体的毛病,翻译成一句能力需求。
然后按模块职责拼检索词,去预印本平台上捞论文。
这里有个容易踩的坑。
最相关的几篇论文,方法往往长得很像。
预算全砸在它们身上,搜索就困在一条技术路线上。
所以它多了一步归类。
用主题建模把候选论文按技术机制分组,尽量覆盖不同的方向。
同样是想改善上下文管理。
有人压缩上下文。把长度降下来。
有人检索关键片段。把证据留下来。
问题一样,机制不同。
这样有限的实验预算。才买得到更多解法。
第三步,把论文里的方法写成代码。
研究智能体读正文,也读代码仓库和附录里的提示词细节。
读完给出实现方案。
再交给一个 AI编程 智能体,去改对应的模块。
论文里的方法常依赖作者自己的工程细节,照抄往往跑不起来。
它只挑能落地的部分。
每个候选实现都要在验证任务上跑分。
但一个模块单独好看。拼起来未必好用。
所以它还会试不同的组合。评完整框架的表现。
只留下验证过,且确实比当前版本强的设计。
整个过程像一次自动化的科研。
从最新文献里提方法,落成代码,再用实验决定要不要。
评测在这一步比生成更重。
生成十个方案。最后可能只留一个。
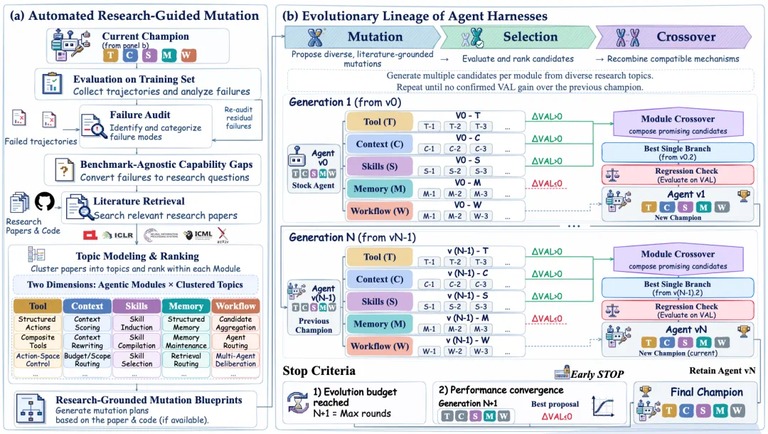
左图是自动研究与变异,右图是各代框架的演化谱系,底下写着 Generate multiple candidates。
只动框架,分数能涨多少,团队做了对照。
用了两个有代表性的智能体基准。
一个要求智能体通过接口操作不同应用,把多步任务真正做完。
另一个考工具调用和与用户来回确认的能力。
两个底座模型都试了。
一个是千问3.5的27B版本,一个是闭源小模型。
对照组是原始框架,和早前那套自动改框架的方法。
前一个赛道是常规版,任务和应用都在训练分布里。
这一场 27B 模型从 69.0% 到 81.4%。
更硬的一场是挑战赛。
考试里的应用,训练和验证阶段都没见过,亚马逊和 Gmail 都在里面。
同一套模型,这一场从 49.6% 到 63.6%。
同样的设置下,早前那套方法只到 54.6%。
另一个小模型的提升也很整齐。
挑战赛从 46.1% 到 55.6%。
在通信场景的基准上,单次任务成功率从 72.7% 到 81.9%。
同一个底座。换一套框架,差距能到十几个点。
这说明围着模型的那层软件,本身还藏着不少余量。
不额外训练模型。只优化外面这层,效果已经很可观。
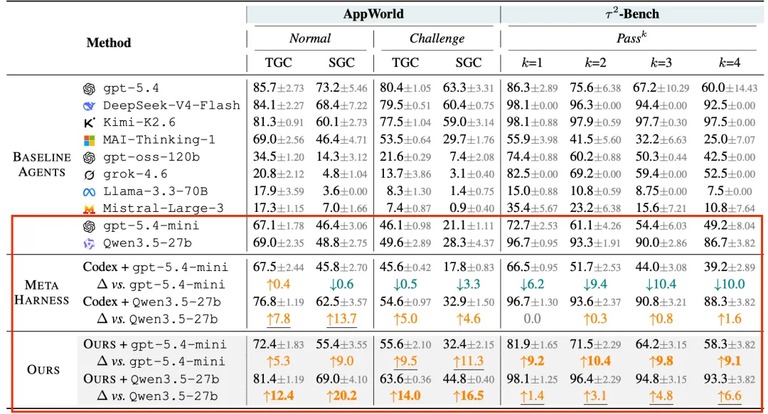
柱状图按 AppWorld 和 τ²-Bench 两条赛道分开,浅色是常规版,深色是挑战版。
拆开看,每个设计都有用。
去掉文献指导,分数往下走。
去掉按模块分头搜索,再往下走。
主题建模拿掉,还要再降一档。
说明涨分不只来自改代码。也来自怎么找方法。怎么把方法拼起来。
另一个发现更值得记。
单独表现最好的那个模块,拼进整体未必最好。
模块之间有相互影响,只能放到完整框架里评。
到这里它还只是把一次优化做完了。
团队真正想做的是让它一直学下去。
旧的框架优化跑几轮就收敛。最后交出一个固定版本。
可研究本身在往前走。
新的记忆架构,新的推理策略,几个月后才出现。
所以它按论文发表时间切了三个窗口。
去年 12 月,今年 1 到 4 月,今年 5 到 8 月。
底座模型不动,只让新论文陆续进来。
每进一个新窗口,就重新检索一次最新文献。
旧版本里验证过的改进会被保留下来。
即便没遇到新的失败,它也会主动去试新方向。
同一个 27B 模型,常规赛道上的完成率一路走到 73.4%,79.8%,最后 81.5%。
这一步的意义不在分数,而在它不再需要一个固定的终点。
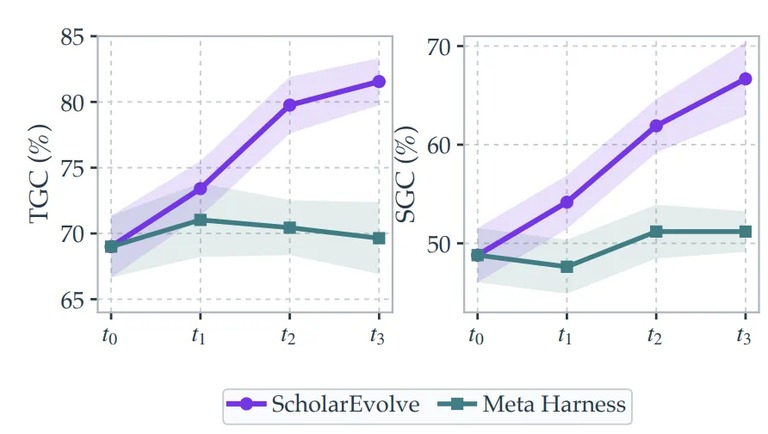
三条曲线对应三个研究窗口,纵轴是 TGC,横线是 MetaHarness 的水平。
这套东西离全自动还远。
论文里也写了几处没做好的地方。
复杂任务的约束跟踪,信息检索的完整性。都还有空间。
从论文里提的方法也不总有效。
有些候选实现跑下来。分数反而更低。
所以人工评测和筛选这一步。暂时省不掉。
但方向值得看。
过去一篇智能体论文发出来,要有人读,有人复现,再手动接进系统。
知识才算真的落地。
现在这条链路被连起来了一段。
智能体自己读研究,自己写机制,再用实验判断有没有用。
更现实的变化在工程侧。
同一个底座模型,换框架就能差出十几个点。
这件事对做产品的人最有价值。
它说明还有一层可以调。而且不必重新训练。
往后走。智能体可能不只完成你交给它的活。
它还会从新知识里。自己长本事。
