

在游戏里走到一扇门前。
不确定能不能进去。
常规做法是转身往回退两步。
再跳两下,看能不能翻过旁边的墙。
这些都是游戏里再普通不过的操作。
可如果画面是 AI 当场画的。
模型就得跟上每一次临时起意。
突然停下,突然转身,突然跑跳。
每一帧都要稳。
VAST 刚开源的实时世界模型 EdenLive 就在做这件事。
它是 Project Eden 系列里的实时渲染器。
规则和状态仍由上游交互系统管。
白模可以当参考。2D 场景也行。真实录像同样可以。
你往前走,或者把镜头转到身后。
系统把新状态转成灰盒画面和场景描述。
送进模型,实时渲染成你看得见的画面。
它还能跟着玩家的操作持续生成。
也能保留一段视频的运动和镜头。
把人物与环境换成另一种风格。
到了具身场景,第一人称的人手视频还能改写成机械臂视角。
有人把它当成一件AI工具来试。
同一段参考,换一张首帧,换一句提示词。
外观就能变成写实。也能变成线稿。
卡通或者像素都可以。油画同样成立。
画面顶部挂着 NEONCLASH 和 RAZE,倒计时走完跳出 FIGHT!
做法是分工。
参考画面决定结构、运动和镜头。
生成模型只负责重写这些内容看起来是什么。
三类输入各管一段。
参考视频管布局和镜头。也管物体轨迹和事件时间。
目标首帧管主体和材质。还管配色和画风。
提示词补风格和细节。
交互中还能追加一句描述。
这些描述随时能改。
玩家多做一步,提示词就跟着变。
参考没换,世界就没换。
换成具身场景,参考就是一段第一人称录像。
换掉首帧,机械臂视角也能生成。
同一套权重,换参考就换用途。
它不记住上一局。
想省事就直接拿别人的参考。
风格却会跟着人家走。

输入框里一句 Describe the game you want to build 就能开局
长时生成是这类模型的老大难。
它在这上面有进展。
团队拿 Gemini-3.8-Flash 做裁判。
45 个案例两两盲评。
参考遵循这项,14B 拿 1704 分。
比 AgentGarten 高约 200 分。
五个维度上,14B 和 5B 占了第一和第二。
另两项是首帧一致性和物理合理性。
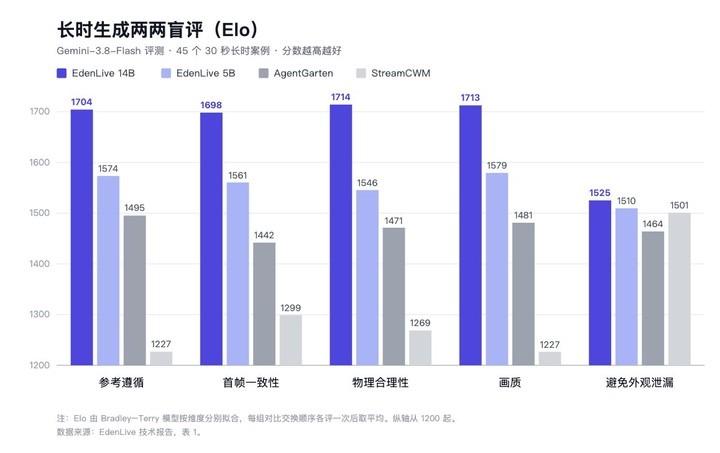
45 个 30 秒案例两两盲评,EdenLive 14B 与 5B 排在前两名
更强的是实时跟随。
离线视频模型要先拿完整输入再整段生成。
接不进实时交互。
它能追着不断变化的参考往前走。
5B 版本在单张 RTX 5090 上跑到 24 FPS 以上。
720P 画面,还能连续生成几分钟。
这对游戏制作有意义。
玩家按下攻击键,最先工作的不是模型。
武器有没有打中,血量该扣多少,角色走到哪。
都先由上游交互系统判定。
判定完再更新游戏状态。
模型只画这一刻该有的画面。
读数 14.4 和 26%,角落还有一个 +6
场景和动画预览里,参考可以是白模。
也可以是美术做的粗动画。
或者精细模型渲出的法线图视频。
参考不动,只换首帧和提示词。
同一个场景,同一段动画。
就能比较不同的材质、光照和配色。
这条线原本属于AI视频生成的地盘。
现在被拆成状态和画面两件事。

同一段动画只换首帧,材质和光照跟着变
这里还有一层约束。
进入升降装置后,围栏和网格不能走形。
外面的环境却要缓缓变化。
面向游戏开发,VAST 还开源了 EdenGolem。
版本是 v0.1。
一个给AI编程智能体用的技能。
只要输入一段玩法描述。
智能体便分四个阶段往下走。
玩法设计,场景搭建,交互逻辑,界面完善。
最后生成一个能独立运行的 3D 灰盒游戏。
解谜和射击都支持。
驾驶,冒险,竞技场,格斗也在里面。
除了按素材生成,它也能理解现实素材。
闪身步是真人教学。
保留构图和运镜,人物与笔触全部动画化。
模型沿原视频的动作重新生成每一帧。
不照搬原视频的质感。
真人闪身步被重画成动画笔触,构图和运镜没动
头戴相机拍下的擦桌子片段,视角是第一人称
还有一个容易被忽略的用途。
具身数据增强。
机器人训练不缺人怎么擦桌子。
缺的是从机器人眼里看出去的素材。
机械手怎么靠近,怎么抓住,怎么松开。
这种视角倒不难拍。
找个人戴头戴相机。
擦桌子,开抽屉,倒水。
一天能拍很多段。
可真人录像里是人的手臂和五指。
机器人看到的却是机械臂和夹爪。
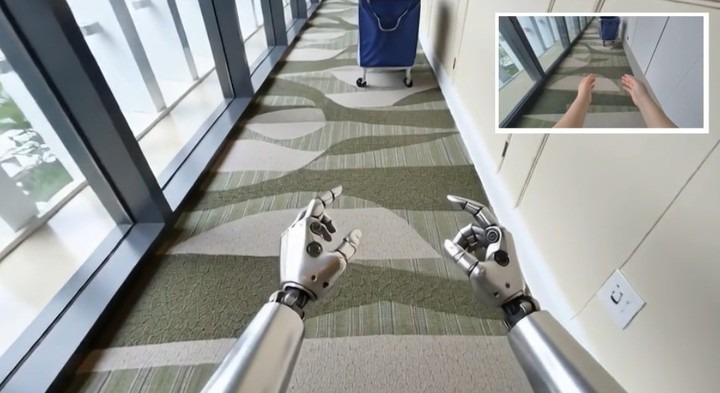
水壶和桌面的位置没变,执行者换成了机械手
外形不同,运动范围不同,遮挡也不同。
模型主要用真人视频训练。
到了机器人摄像头里,就会撞上视觉分布差异。
它能把真人的手换成机械手。
拿水壶的动作保留。
水壶和桌面的相对位置保留。
第一人称镜头的移动也保留。
只把执行者改成机械手。
素材就更接近机器人会看到的画面。
不同参考素材,效果和限制不一样。
现成录像只能提供镜头和动作。
重渲染之后仍然是一段视频。
可玩性来自上游代码。
但背后有一套分工和规则。
生成结果能随操作继续变。
宁可多拍几段真人录像。
也别让模型自己去猜手在哪。
世界模型要把状态和渲染拆开
看演示很容易误会。
以为玩家在直接操纵一个视频模型。
其实它不判断游戏里发生了什么。
也不负责让世界运转。
今年 5 月的 Project Eden 把研究分成三层。
第一层是持续演化的世界状态。
记物体位置和属性,记交互规则和动作后果。
第二层是状态到画面的接口。
把状态转成某个视角下的布局和几何。
第三层才是生成式渲染器。
它做后两层,不限定第一层。
血条上 PLAYER1 剩 714,对手掉到 530
视频模型擅长画出看起来合理的画面。
却维护不住血量。也维护不住碰撞。
所以确定性状态留给交互系统。
视觉呈现交给生成模型。
交互系统把每次变化渲成新的灰盒画面。
一个视觉编码器从中提取布局和镜头。
只要把空间布局和运动轨迹交代清楚。
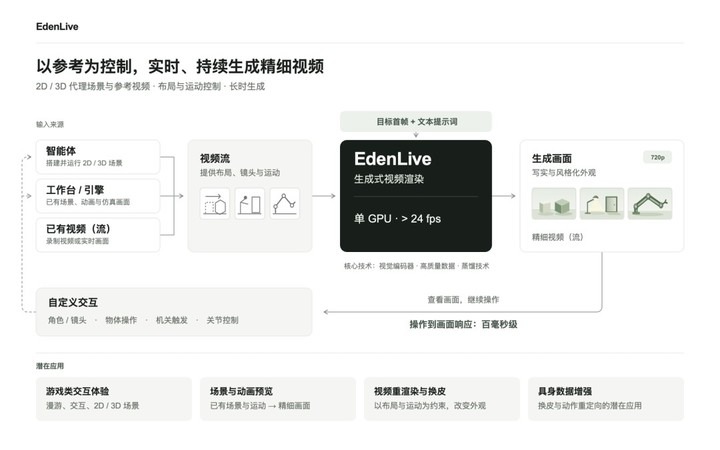
以参考为控制,输入来源写着 2D/3D 代理场景与参考视频
规则归交互系统,画面归模型。
这套分工解决了视频模型存不住规则的问题。
也让视觉元素稳得住。
当然,它还要过更长时间、更复杂交互的检验。
世界模型不缺演示
2026 年 1 月,牛津学者的综述把视觉混淆列成挑战。
画面逼真,不代表模型懂了因果和物理。
他们主张世界模型换一条路。
从生成画面的视觉引擎,转向能表示动态与约束的模拟器。
这条路线当时还不是主流。
今年 5 月,VAST 的 Project Eden 已经这样分工。
几个月后,EdenLive 把渲染推到实时和连续。
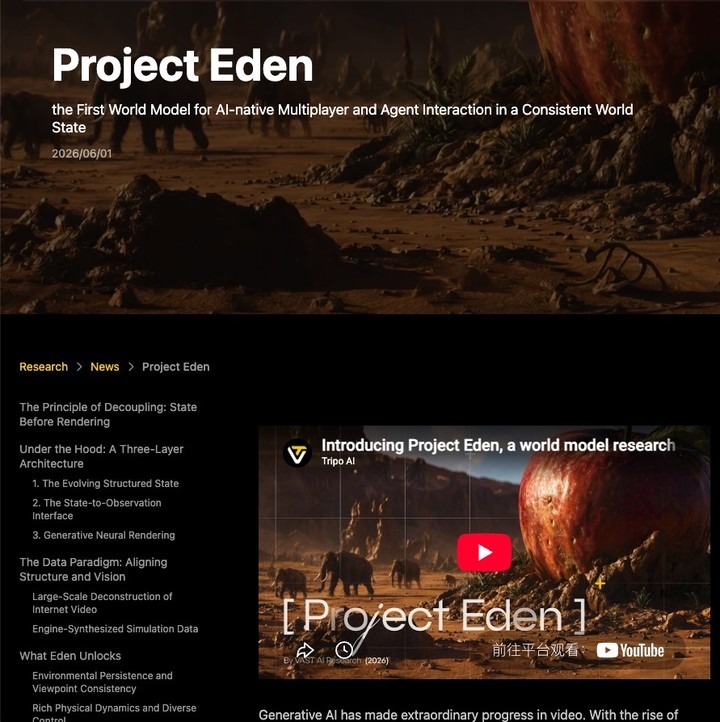
Project Eden 的页面上写着 the First World Model
市场上,类似方案到八月九月才开始密集出现。
这次开源的东西不少。
5B 和 14B 的权重,各含双向生成和流式两个版本。
实时流式推理代码。
还有前端工作台和技术报告。
开发者可以接自己的参考来源。
测延迟和稳定性。
同一时间还发了 V·STAR 人才计划。
面向全球青年算法和研究人才。
方向覆盖 3D 生成模型,3D 理解与智能体,世界模型。
薪资比头部大厂更有竞争力,特别优秀的往上不封顶。
还有长期期权。
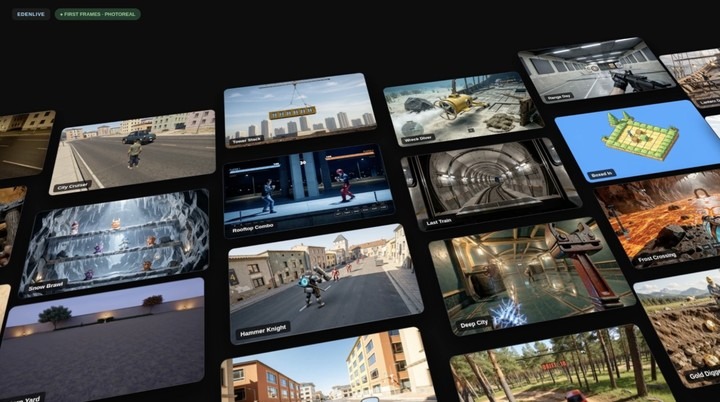
EDENLIVE 的演示页标着 FIRST FRAMES-PHOTOREAL
过去的世界模型演示,靠一段视频证明能想象一个世界。
EdenLive 往前多走了一步。
等更多人把自己的代码和场景接进来。
这套东西才会长成真正能用的创作流程。
它还缺一样东西。
缺的是有人真的拿它做完一个作品。
这条路线的门槛不在参数量。
在状态怎么表示。
状态表示得越细,画面越稳。
状态表示错了,画面再漂亮也没用。
对做游戏的人来说,先要想清楚规则。
对做数据的人来说,先要挑对参考。
工具已经放出来了。
剩下的问题在用法上。
它把实时生成从演示推到了能接的一步。
能不能用,还得看接进去之后。
延迟够不够低。
长时间跑会不会崩。
这些都不是开源那一刻能回答的。
得有人真的做完一个项目才知道。
Gemini会员中转站 微信:douhanq
