

10 月 16 日,深圳有一场软件研发峰会。台上是商汤大装置的 CTO 宣善明。
题目叫《智能体时代 AI 基础设施的实践与趋势》。他没先讲卡,先给了一个数字。
平台一天要出六万亿 Token。
这个数字今年还要再翻。
台下坐的多是做研发的同行。
宣善明演讲,投着数智和智管。
AI 应用这两年在变。
以前是一问一答的对话。
现在是一串智能体互相接力。长任务跑起来,没人守着也要跑完。调用次数多了,推理轮次也多了。
上下文一次比一次长。
Token 需求就这么翻了上千倍。
供给那头跟不上。
高端芯片的供给受限。
存量算力又和任务需求对不上。行业里有个数,2026 年推理支出占 AI 云支出的 55%。
明年会升到 59%。
不同场景要的东西还不一样。基础问答只看单位成本和并发。办公客服更在意响应延迟和生成速度。
AI工具 卡一下,人就走了。
这事糊弄不得。
AI对话 慢半秒,体验掉一档。
忍不了就走。
AI编程 的补全更吃延迟,等两秒就想自己写。科学探索和金融量化要的是准确,能审计,能追溯。
首 Token 延迟,生成速度,长上下文缓存,并发能力,调用成功率。这几个数凑在一起,就是所谓服务质量。
另一把尺子是成本。
同样的钱,能产出多少有效 Token。宣善明说,不能再靠一套硬件配置包打天下。
得按场景分层组织算力,精准调度。从规模扩张转向效率优化。
从换硬件转向异构协同。
卡不够多,就只能把每张卡用到该用的地方。他把这套想法落成了两件事。
一件是把推理拆开。
一件是把不同算力混着用。大模型推理本来就分两段。前一段叫预填充,把输入的 Token 读进去算一遍。
这一段吃的是算力。
后一段叫生成,一个字一个字往外吐。这一段要不停读缓存,吃的是显存带宽。拆开的做法,是让两者各找各的硬件。
国产算力集中做预填充。
高带宽的高阶卡专门做生成。中间用缓存传输把两段接上。这不是把几种芯片摆一起就完事。
得围绕计算特征和显存带宽重新组织。国产算力也因此往上走了一层。从只管基础推理,到参与更高层级的服务。
他们在临港的智算中心把这套跑了起来。
集群规模到了万卡级。
卡是分批进来的,代际不一样,通信协议也不一样。
难题在互联。
不同代际的卡要在一个集群里说话。同一条集群里混着 800G 和 200G 的网。
就为了让预填充节点和生成节点之间的缓存传得快。走通了,国产卡才算进了主链路。
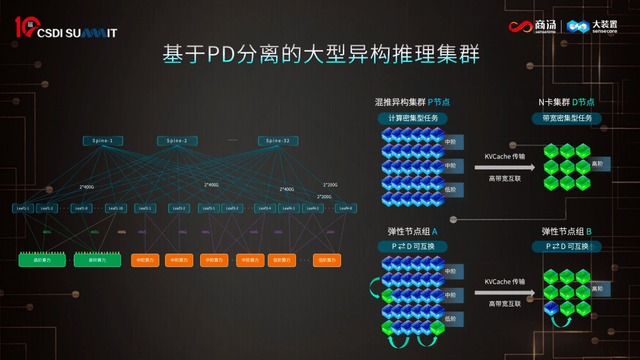
基于 PD 分离的大型异构推理集群示意,P 节点和 D 节点可以互换。
集群一大,麻烦跟着来。
一部分异构配置里,三十到五十个中低阶预填充节点。
才配得上一个生成节点。
生成节点一旦出故障。
那一大片预填充资源就跟着闲着。
他们想了两个办法。
一个是在池子里留一点高端卡。生成节点出事,就调过去补位。
另一个是让节点换角色。
负载轻的时候做预填充,压力上来就转去生成。
算力就这样流动起来。
代价是调度变复杂了,谁在什么时候当什么角色,都得算。
再往上,是六层架构。
能源设施,资源互联,缓存数据面,推理运行时,服务调度,交付。
一层压一层。
把异构硬件收进同一个调度体系。这一层看不见,出问题的时候最先被怀疑的却是它。
同一个测试配置下,卡的数量不变。异构协同之后,整体吞吐到了原来的五倍。
五倍是在特定配置下测的,换一种卡组合,结果不会一样。但它说明一件事,堆卡和用卡是两码事。
三十比一这种比例,说明生成那一段才是瓶颈。哪一段紧,资源就该往哪一段挪。这套逻辑放到别的集群上也成立。
这套账有意思的地方在后面。单看一张卡,异构组合未必比旗舰卡快。
看整个集群,同样的旗舰卡能出五倍的 Token。省下来的不是硬件钱,是闲置率。
闲置率平时不显眼,集群一大就全露出来了。
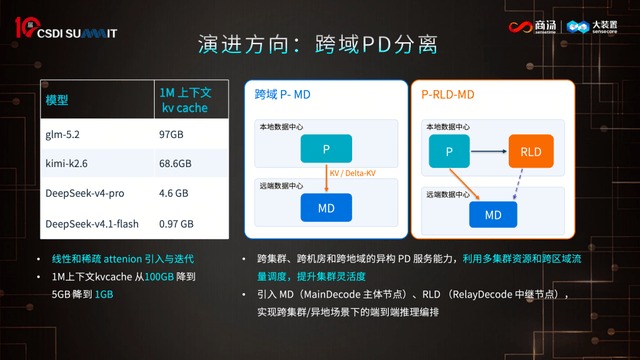
演进方向是跨域 PD 分离,KV 缓存跨机房传输只剩 4.6GB。下一步是把分离拉到机房外面。
本地中低阶算力做预填充。缓存传到外地的高阶集群去做生成。他们和政府合作,把不同地区的算力接起来。
能不能走通,得看模型架构。一兆上下文的缓存,从前要近 100GB。现在部分模型压到了 1GB 左右。
跨域传输的压力一下就小了。他们还设了主体节点和中继节点。区域里凑不齐高阶算力,也能拼出一次推理。
再往后是注意力层和计算层分离。生成这一段里,注意力层要的是显存容量和带宽。
另一半全是矩阵乘法,要的是算力。绑在一套卡上,两边抢资源。拆开之后,各自去找合适的硬件。
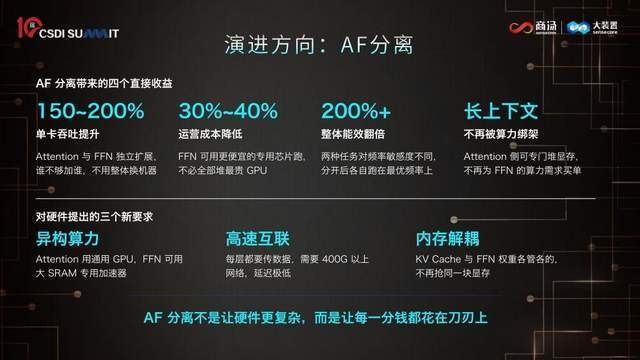
演进方向是 AF 分离,四个直接收益写在图上。按他们的估算,单卡吞吐能提 150% 到 200%。
运营成本降三成到四成。
整体能效翻一倍以上。
这些数还取决于模型架构和硬件配置。别把这些数当成承诺,它是思路跑通之后的天花板。
思路是一致的那条,哪一段慢就拆哪一段。宣善明最后把话题收回到两个指标。一个是端到端的服务质量。
一个是成本,单位投入能换多少有效 Token。两个指标一起看,才知道一套集群是真能干,还是纸面参数好看。
国产算力,先进算力和各种模型,都得持续适配。模型和应用又变得快,优化越来越难做。
今天是这版模型,下周换一版,缓存大小和算子分布全变。靠人盯着调,根本跟不上。
所以他把这事叫做 Token 工厂。工厂讲产出,集群讲有多少设备。两个词差着一次思路转换。
日均六万亿。
2026 年全年要做到 25 倍增长。
第四季度日均十万亿。
从六万亿到十万亿,剩下的四万亿得靠效率抠出来。卡不可能按这个速度到货。他说,稀缺的从来不是芯片。
是稳定产出 Token 的那套系统能力。
这句话听着像总结。
落到工程上,就是每一层都别掉链子。交付层要能验收,服务调度要能兜底。这套体系最后要交到客户手里。
