

机器人抓不稳东西,问题常常不在脑子。
它想得没错,手伸偏了。
国内一家做人形机器人底层的公司,今天放出一个新模型。
叫 ACE-Brain-0.6,参数只有九B。
上一版 0.5 已经在搭感知和行动的闭环。
这一版只盯一件事,把位置找准。
八项空间评测里,六项压过 GPT-6 Astra。
七项公开基准的平均分是 74.53。
对面那套通用模型是 73.68。
自家搭的真实机器人评测里,它拿到 94.13 分。
对面是 91.10 分。
九B 放在通用模型里,算小个子。
能在一个专项上追平,才有讨论价值。
分差不算悬殊。
可这件事的分量,不在分数上。
一 看懂世界,还得找得到那只手
通用大模型这两年进步很快。
能规划步骤,能读懂指令,能解释画面。
可让它指一个具体位置,就容易含糊。
这和 AI编程 里的补全不是一回事。
补全靠上下文足够长,位置靠像素足够准。
文章里举了两个动作。
放水果篮,得先认出篮筐边缘,再算往哪推。
折 T 恤,得先抠出衣物轮廓,再估折叠距离。
这两步都不难描述。
难在落到像素上。
差几十个像素,人看着没区别。
机械臂伸过去,就抓空了。
文字问答里的一点偏差,可以糊过去。
机器人不行。
这道坎不解决,再聪明的规划也落不了地。
通用模型在 AI对话 上很强,是因为文字本身带上下文。
到了物理世界,这层上下文得自己量出来。
这套模型要补的,就是这一段。
它把五件事并成一个能力。
认出目标,找到多个同类实例,判断相互关系。
再看哪里是功能区,最后预测手该落在哪。
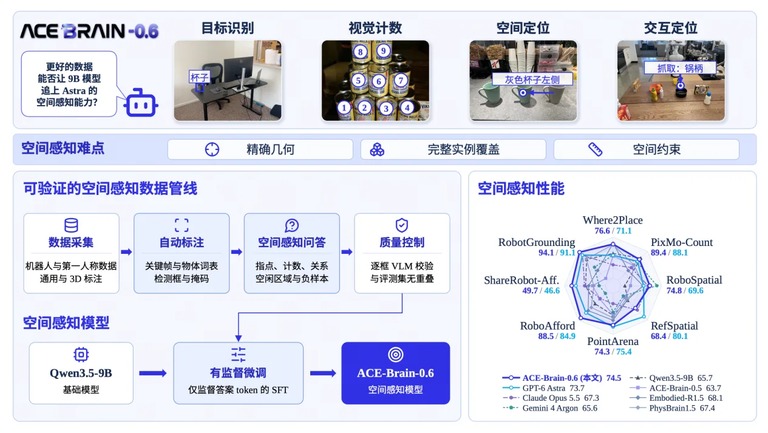
技术概览图。左边三栏是目标识别,视觉计数和空间定位,右边是模型给出的检测框与掩码。
二 九B的模型,赢了六项空间评测
评测一共八项。
七项是公开基准,一项是团队自建。
覆盖指代,计数,定位,功能理解,还有交互区域。
六项赢,两项没赢。
数字摆在这里。
放置位置预测 76.55 对 71.10。
计数 89.41 对 88.10。
空间关系 74.82 对 69.55。
可供性判断 88.51 对 84.94。
另一个公开集 49.70 对 46.60。
最后是自建的真实场景评测。
2591 道题,14 类任务。
目标定位,小物体识别,多实例计数,跨相机视角对应。
还有一类容易被忽略。
目标根本不在画面里。
模型得说出没有,不能编一个像样的位置。
这一项它拿了 94.13。
比对面高 3.03 分。
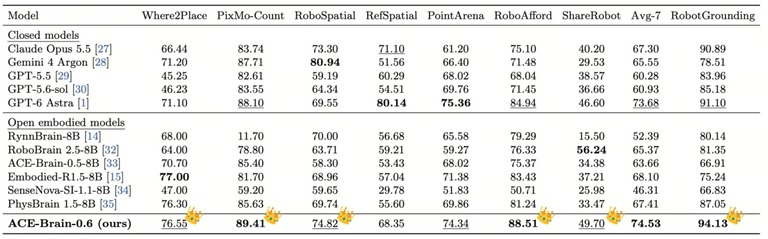
八项评测的对比图。图里按基准横排,几个参评模型的得分并排显示。
这些分数背后是一件更朴素的事。
模型不是只认得出”这是杯子”。
它还得回答”哪里能放””抓哪个部位”。
这两问听着简单,落到图上就是坐标。
三 一百万条样本,怎么攒出来
分数背后是数据。
这一点比分数更值得看。
机器人公司手里不缺录像。
缺的是标注。
一段操作视频里,有画面,有轨迹,有指令。
可没有”这个东西在哪””该抓哪个部位”。
模型看一万遍,也学不到这层。
团队的做法是把录像拆开。
先按夹爪状态和动作幅度挑关键帧。
再自动生成场景里的物体词表。
然后用开源检测模型和分割工具定位。
最后做语义校正。
一条条问答就这么长出来。
问目标指代,问数量,问空间关系。
问交互位置,也问”有没有”。
每条答案都得有画面依据。
标注不完整,就不出计数题。
目标不存在,得先确认它真没出现。
这套流程最后产出约一百万条样本。
94 万张图像,270 万组问答。
基座用的是千问 3.5 的九B版本。
视觉编码器冻住,只调语言模型。
接口统一,坐标和区域一次输出。
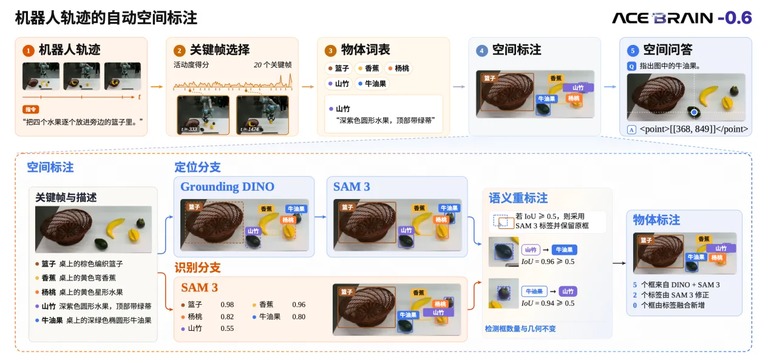
机器人轨迹的自动标注流程图。从关键帧选择到物体词表,再到定位与问答生成。
四 数据翻倍,分数涨两点四
还有一个实验,做得很实在。
架构不动,训练方法也不动。
只把数据从 26 万条加到一百万条。
七项公开评测的平均分从 69.3 涨到 74.5。
每翻一倍,涨约 2.4 分。
看着像一条对数曲线。
这条线往上走,说明还没到天花板。
对九B这个量级,空间能力还有余量。
但第二个结论更关键。
只往已有的类型里加样本,涨不到 1 分。
真正拉动分数的是新场景。
新空间关系,新的监督形式。
堆量没用。
铺面才有用。
这条路听着笨,但可复现。
数据这块,一直是具身行业的苦活。
录一小时视频,标注要花好几个小时。
把标注自动化,等于把成本压下来一截。
这套流程能复用,价值可能比一次评测更高。
行业里数据荒喊了很久。
缺的从来不是采集能力。
是把采集变成可训练的信号。
空间锚定只是第一步。
它回答”在哪”。
下一步要回答”为什么这里能下手”。
同一个位置,能放空杯,不一定能放满杯。
桌沿能摆东西,不一定能承重。
这些约束,眼下的评测还没覆盖。
评测分数是对着基准打的。
真实场景里的光照,遮挡和滑动,比测试集脏得多。
团队自己也承认,这只是一段能力。
这句话比宣传口径诚实。
规划,长程任务,多机协同,都还没碰。
九B的模型在单项上赢了通用大模型。
不代表它在别的维度也赢。
这个边界得说清楚。
不然容易读成国产模型全面超越。
那是另一回事。
对行业来说,这条路的价值在别处。
过去做具身模型,习惯先堆参数。
好像模型够大,物理常识就会自己长出来。
这个实验给了另一个答案。
在决定动作精度的感知环节,数据覆盖面比参数规模更管用。
对做 AI工具 的团队来说,这话有直接用处。
想清楚要什么能力,再去找那种数据。
先堆一个通用模型,再指望它自己学会定位,代价高得多。
零售分拣,物流搬运,服务机器人,都吃这一套。
抓得准,才谈得上稳。
找得到,才谈得上自己干。
