

今年做视频的团队,都盯上了同一个方向。
让画面听懂人的操作,一直往下接。
阿里的 HappyOyster,蚂蚁的 LingBot。
名字不同,赌的是同一件事。
生成一个能自由走动的虚拟世界。
平时我们用的AI对话,是你说一句,它回一句。
这里要的是你动一下,世界跟着变。
我原本对这类东西期待不高。
要过的坎太多,落地更慢。
最近交互视频评测 WBench 的榜首,换了个新名字。
Murea-Pro,81.1 分。
拉开差距最多的是交互能力,还有物理合理性。
两项分别是 82.6 和 74.4。
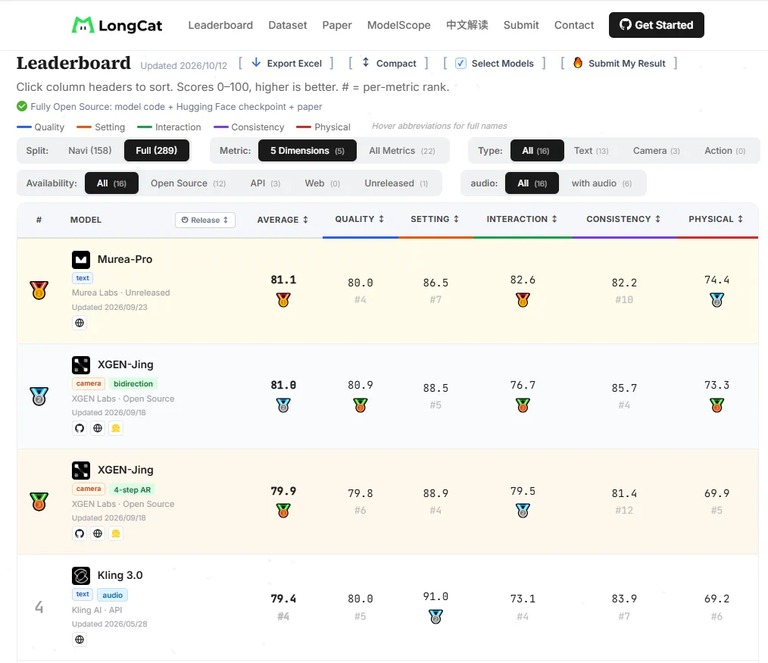
WBench 榜单页,第一行是那个新名字
速度也够看。
RTX PRO 6000 上,5 秒的视频 3.6 秒出。
实时因子 RTF 小于 1。
意思是它出片比播放还快。
官网还挂了个轻量版,Murea-Fast。
参数少,开源。
在多参考生视频评测 OpenS2V-Eval 里,它拿了 64.98 分。
参评的开源模型里排第一。
参考还原能力单算 51.66 分,同样第一。
一个团队同时放两个模型,一个闭源一个开源,这做法不多见。
我把技术报告读了一遍。
又上手试了一轮。
结论有点意外。
这伙人想做的不是下一个世界模型。
是能玩起来的实时互动内容。
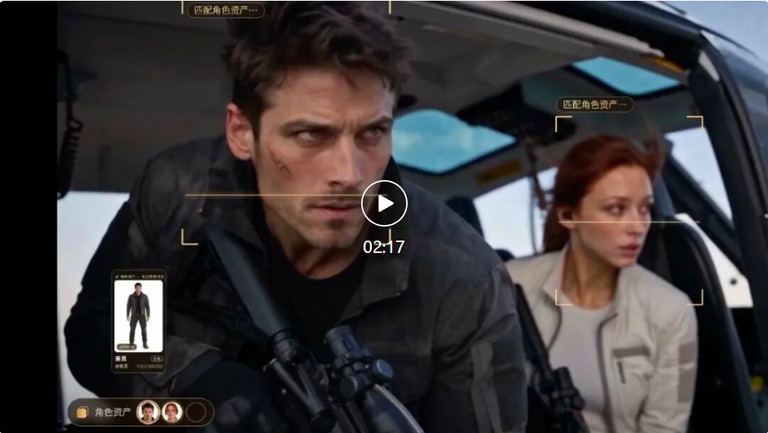
参考图与生成片段,一张张对着看
这样看视频就变成了另一件事。
像走进一个会变的世界里玩。
整套系统叫 Murea-InWorld。
两层结构,先想再拍
上层是 Murea-Mind,负责想。
它读世界状态,读用户指令。
也读上一段视频的最后一帧。
然后决定下一步发生什么。
下层两个模型负责拍。
画面和声音都由它们出。
生成完,结果交回上层核对。
变化确认了,再写回状态。
一轮接一轮,闭环就成了。
这套流程能压成八个字。
状态,行动,生成,观测。
这和做AI编程时调接口不太一样。
这边每一轮都要接着上一轮的账。
技术报告首页,标题写着 InWorld
一本会一直更新的账
撑住这一切的,是那本会持续更新的账。
系统在视频模型之外单独维护它。
参考图,声音,固定描述,都存成资产。
人物在哪,穿什么,什么情绪,随时改。
天气和光线也在里面。
身份和状态分开管。
角色长相不容易被剧情带走。
这一点在长片里很要命。
账乱了,人就会换脸,道具会凭空消失。
所以它把记忆做成可查可改的表。
哪一轮发生了什么,翻回去能看见。
撤销一步,就回到生成前的快照。
换一个选择,另开一条分支。
原来的视频和剧情都留着。
多人进来时,每人的输入先变成结构化动作。
再由系统统一排进同一幅画面。
宁可多记一层,也别让角色在第五轮换了张脸。

世界记忆分两层,身份和状态各管一摊
世界状态定下来,才开始生成。
核心机制叫全参考生成。
人物和动物,物品和场景,四类参考分别编码。
每一类拿到一个干净的条件向量。
也各有一个独立编号。
参考素材不参加加噪,也不参加去噪。
它只负责把长相钉住。
编号让模型知道,哪个参考对应谁。
台词归谁,动作归谁,也一起标清。
它不是一个等着被调用的AI工具。
更像一副有记忆的画布。
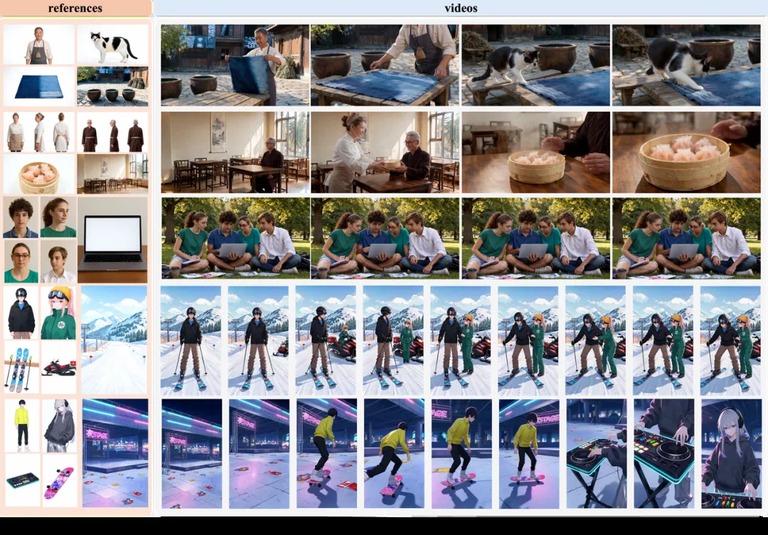
左侧是输入参考,右侧是连续采样帧
声音和画面不是分开做的。
它们在同一个生成主干里一起出。
受控注意力先让参考管各自那一路。
再用视频与音频的标记把两边连上。
训练数据写得很细。
哪个参考对应哪个人。
哪句台词由谁说。
动作和镜头在第几秒发生。
这些都标在描述里。
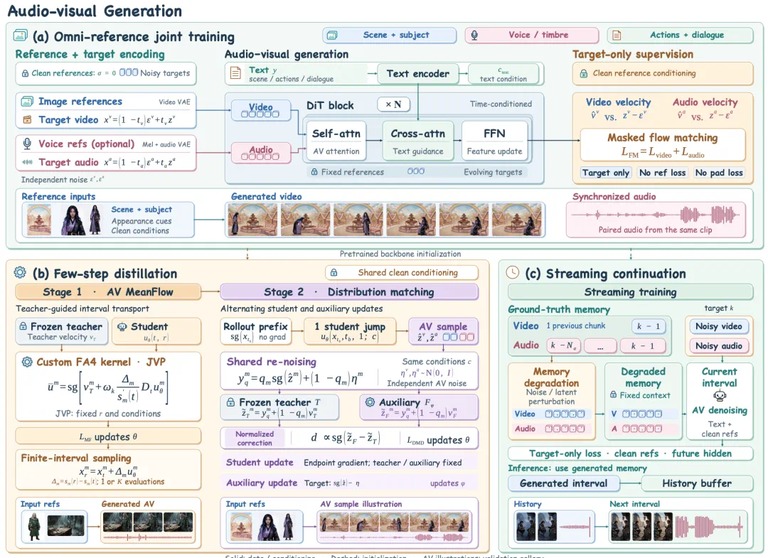
参考编码和噪声目标,分两路走
连续生成靠的是有限历史窗口。
视频这边只留前一个片段。
音频留得更长。
为了接住没说完的半句,还有语气。
训练时会给历史内容加噪声。
让模型提前适应前一段的瑕疵。
延迟靠少步蒸馏压下来。
50 步压到 4 步。
8 张 H20 上,5 秒有声视频从 231.6 秒降到 6.96 秒。
端到端快了 33.3 倍。
换到 RTX PRO 6000,同一条管线只要 3.6 秒。
实时因子算下来 0.71。
低于 1,就是生成比播放快。
在这个硬件和测试条件下,它摸到了实时那道门槛。
算力堆上去容易,把延迟压下来难。
它选了蒸馏,而不是把模型再缩一轮。
宁可多花一点显存,也别让画面在续写时卡住。
这套账不是白记的,每一步都换来了时间。
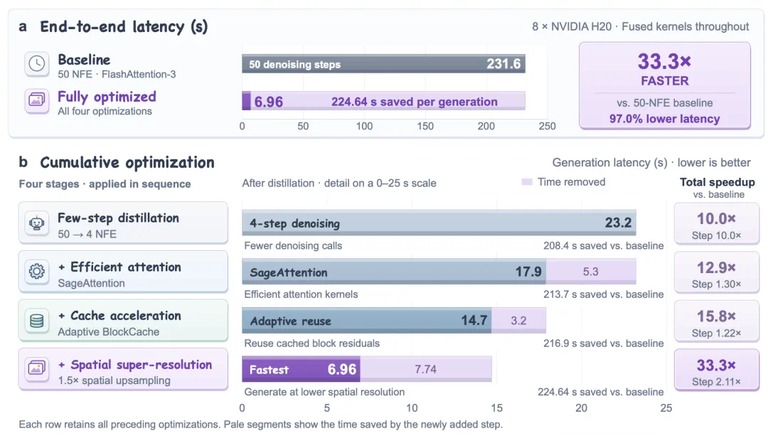
横轴是优化档位,纵轴是端到端延迟
评测结果把两个模型的分工说清了。
WBench Full-289 里,Murea-Pro 拿了 81.13。
交互 82.60,物理合理性 74.42。
比第二名高 9.52 分和 5.23 分。
这个榜测的是多轮交互,不是单条视频打分。
分数拉得开,说明差距不在画质上。
而在下一轮能不能接得住。

四项能力拉成一张雷达图
分项看,事件编辑 90.92。
角色动作 87.04。
导航 71.79,是四类任务里最弱的一项。
画面质量 79.97,中上。
导航这块,它还没补齐。
差在哪里,报告里没细说。
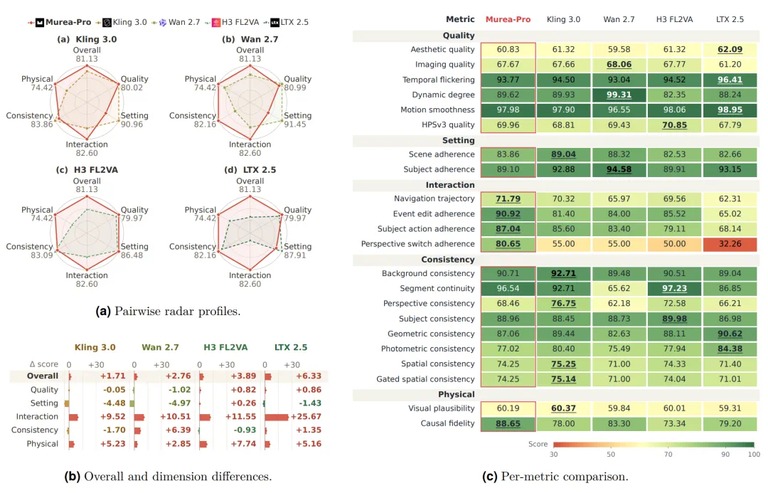
逐项对比表,三款模型并排
轻量版的本事在另一头。
OpenS2V-Eval 上 64.98 分,开源模型第一。
NexusScore 51.66,全场最高。
OS2V-Pro 里,逐参考保真度 46.0,第一。
片内身份一致性 89.0,并列第一。
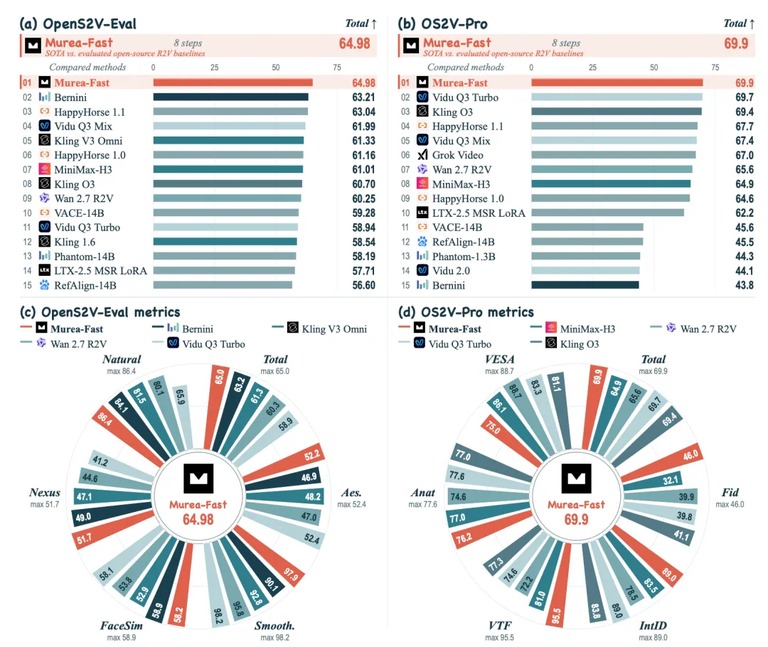
开源参考生视频榜,它坐第一
成绩和技术原理看完了。
我更想知道另一件事。
现在说的互动,多半还是预先写好的分支。
真让人进去玩,能做到什么程度。
我先试了一把。
系统随机给了一个科幻世界。
人物,场景,故事主线,都是它自己定的。
故事不复杂,细节值得看。
先给这个新世界起个名字
第一件要看的是连续性。
主角手里有块平板。
第一段视频之后,它就被记进了面板。
后面十几轮,一直是主角拿着。
也一直是那块平板。
普通视频续写靠上一帧的画面撑着。
角色拿过什么,东西现在归谁,没有记录。
镜头一切,这些信息就散了。
它连续生成了十几段。
人物长相,随身道具,背景,都没飘。
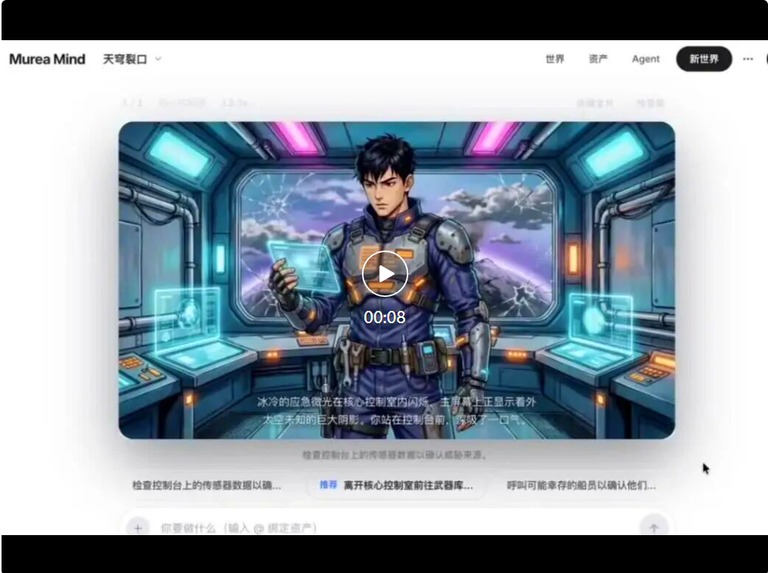
控制室界面,右侧滚着推荐行动
第二件是随时能插手。
每轮结束,它会推荐几个后续动作。
选一个,剧情和镜头自己往前走。
不用再逐段写提示词。
我直接敲了一句,画面突然出现一只小猫。
系统给这只猫单独立了资产。
下一段里,一只三花猫出现在控制室。
镜头再切,它的样子没变。
台词也接得上。
空间站里该说什么,它按当下场景给。

全频段呼叫键,台词跟着场景走
再让它绕着主角转一圈。
主体和目标它没认错。
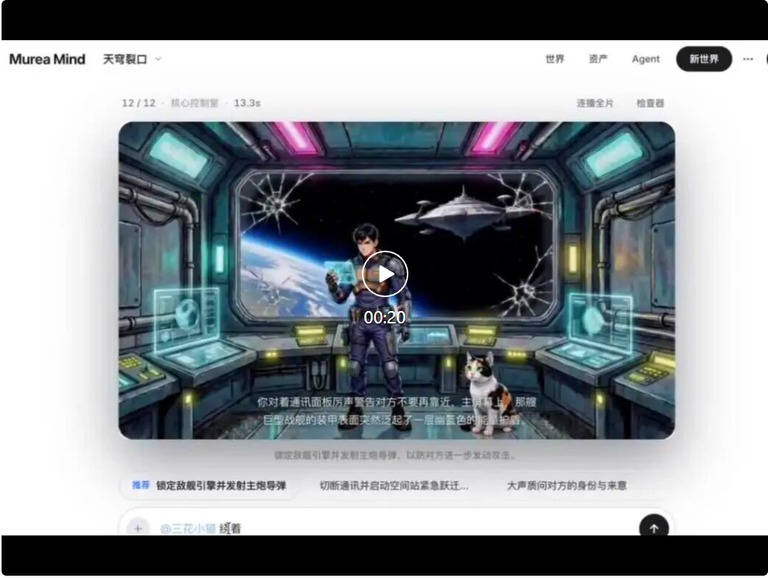
每一轮都写进右侧的世界资产栏
这 15 轮下来,最直观的感受是。
故事没随着片段变多而失忆。
道具不会无故消失。
临时加进来的角色能留到后面。
人也能随时改走向。
生成式互动世界最直接的价值,是把内容生产挪进用户参与的过程里。
过去的互动内容,情节要先设计,素材要先做完。
分支越多,成本越高。
它换了条路,用语言实时改世界。
一千个玩家,能玩出一千个哈姆雷特。
这个方向能落到游戏,互动叙事,虚拟角色,还有在线娱乐。
多家机构估算,相关市场合计已到百亿美元量级。
加上 AI 陪伴这类相邻赛道,2030 年前后有望摸到 500 亿美元。
如果高质量互动内容的渗透率能到全球内容娱乐市场的一成,长期规模会破千亿美元。
数字好看,最后还得靠体验说话。
这套东西要跑起来,算力不便宜。
一个玩家每一轮都要一次生成,人多就是一笔账。
这也是它先做演示,再谈落地的原因。
现在的演示还是单机,联网多人只在小范围跑过。
真要进游戏,帧率稳不稳定比峰值分数更要紧。
它现在能接住的,是短场景里的连续互动。
长剧本,多角色,复杂物理,还差得远。
从模型能力到系统完成度看,Murea Labs 这一步走得扎实。
接下来要看规模化落地。
游戏,影视,互动娱乐,哪一块先跑通。
生成式世界的门,已经开了一条缝。
