

就在今天深夜,Meta 甩出了新一代大模型。
一个主打速度,叫快速版。
一个能力更全,叫完整版。
小扎说,这是超级智能实验室成立一年多后的第一个系列。
比上一代更大,也更先进。
两个版本分工很清楚。
快速版走前沿性能。
完整版是这套模型的全量形态。

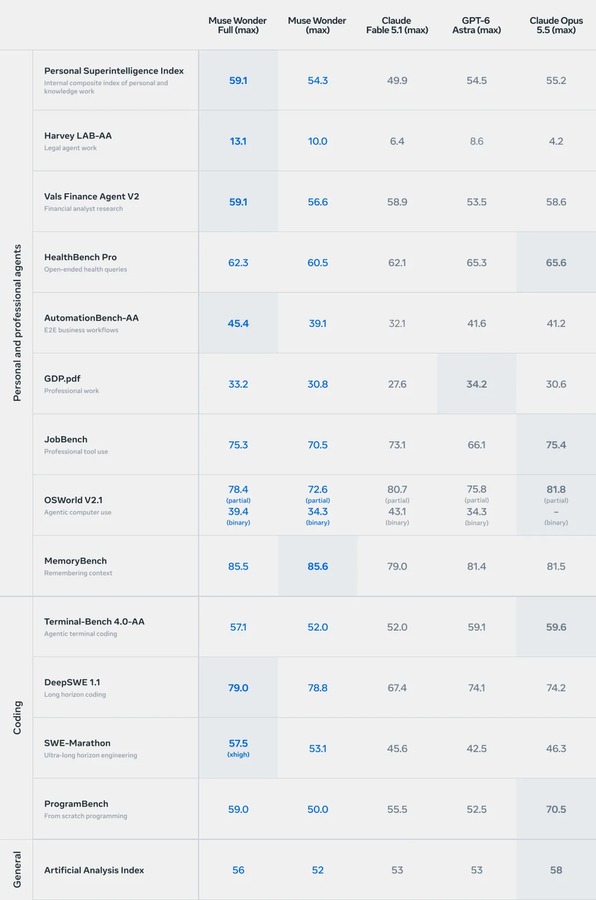
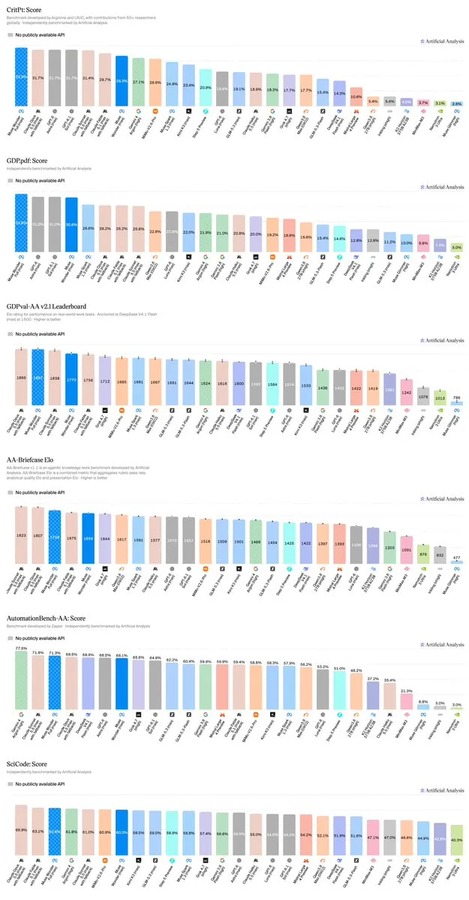
最先炸开锅的,是那张跑分图。
在好几个榜单里,它越过了两家最强对手。
甚至压过了一向被看作天花板的那一款。
跑分一出,评论区一片惊呼。
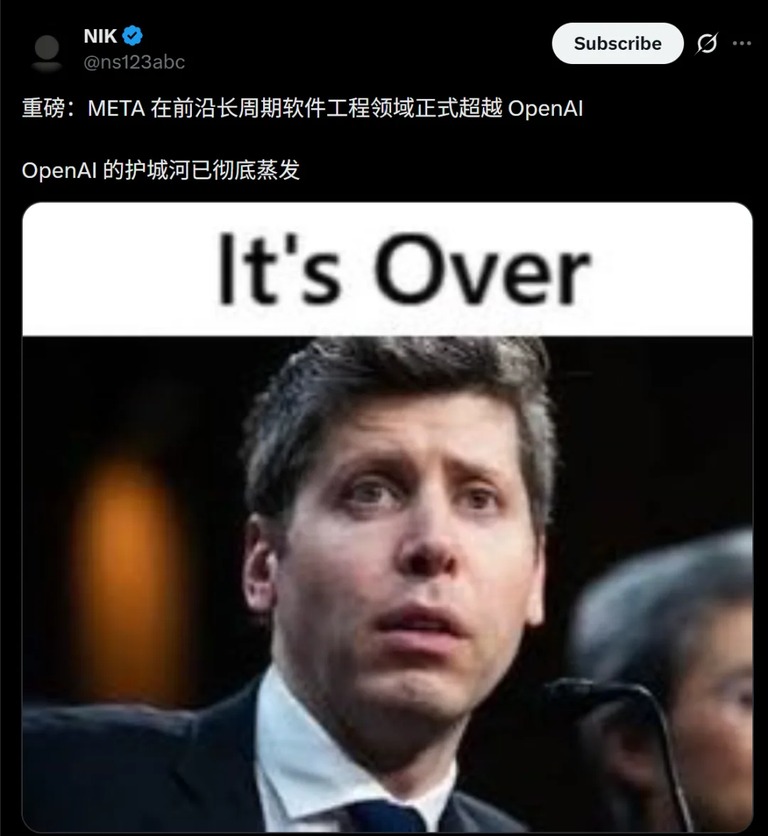
有人说,Meta 这次放出了一个顶级模型。
长周期软件工程这一项,Meta 第一次把 OpenAI 拉下马。
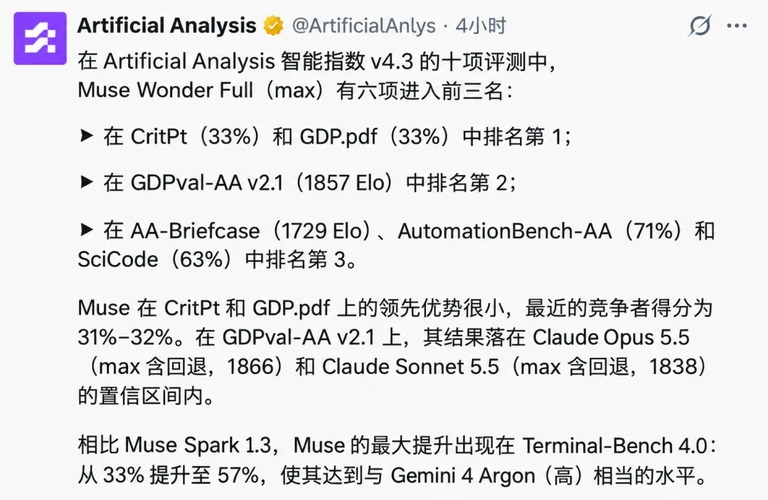
第三方评测机构的统计,也站在它这边。
十项评测里,完整版有六项挤进前三。
其中一项,比上一代从 33% 提到了 57%。
更让人咋舌的是投入。
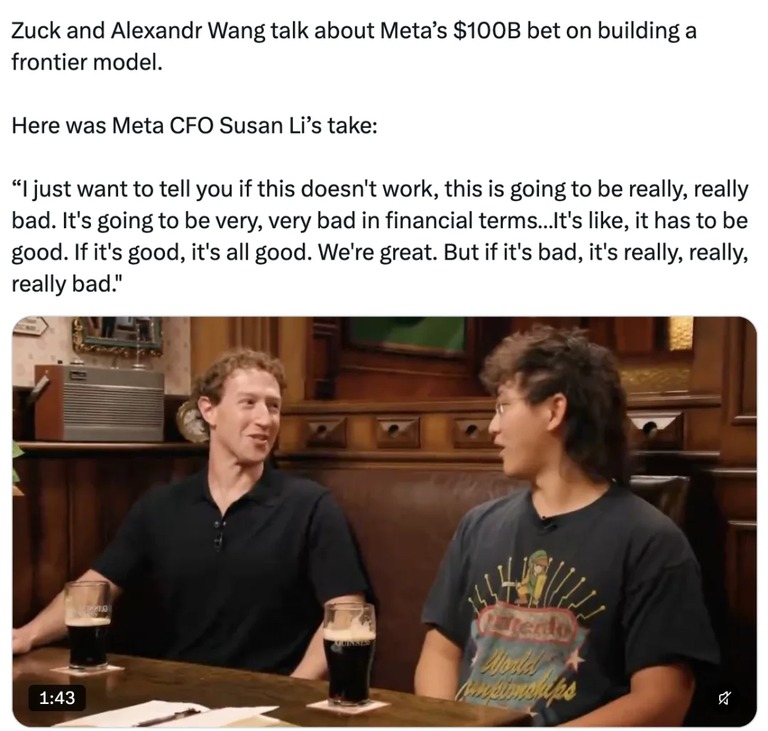
小扎和首席智能官在播客里说,为了这个模型,公司砸进去一千多亿美元。
这笔钱堆出了吉瓦级的数据中心。
实测翻车,连 3D 游戏都搞不定
在开发者眼里,一个 AI工具 好不好用,从来不只看榜单。
模型刚开放调用,就涌进一大批开发者。
晒出来的实测,一个比一个离谱。
有人直接说,这东西就是一坨,刷分刷到了极致。
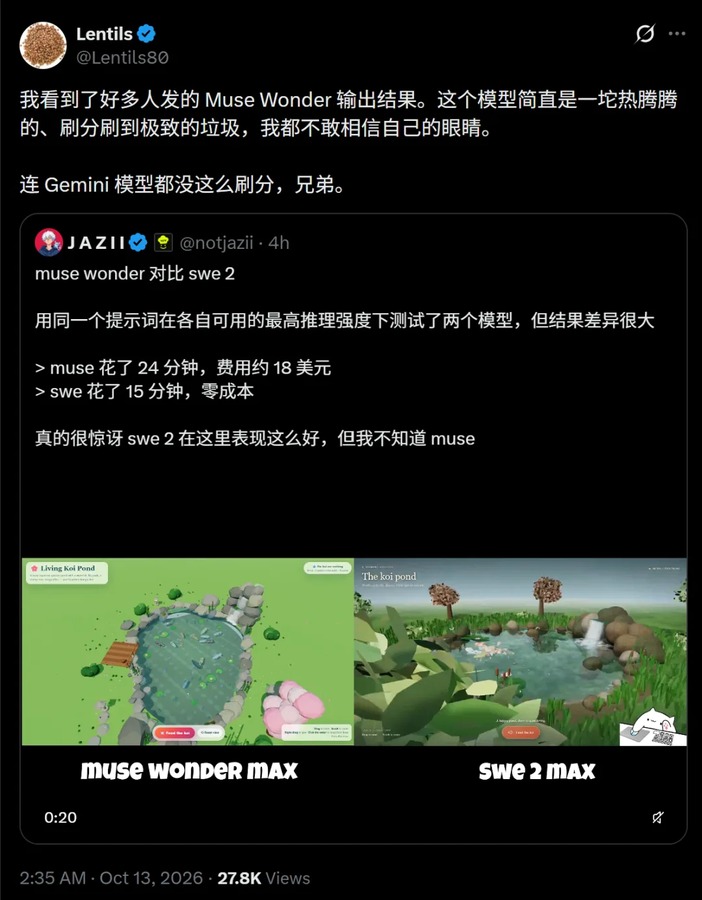
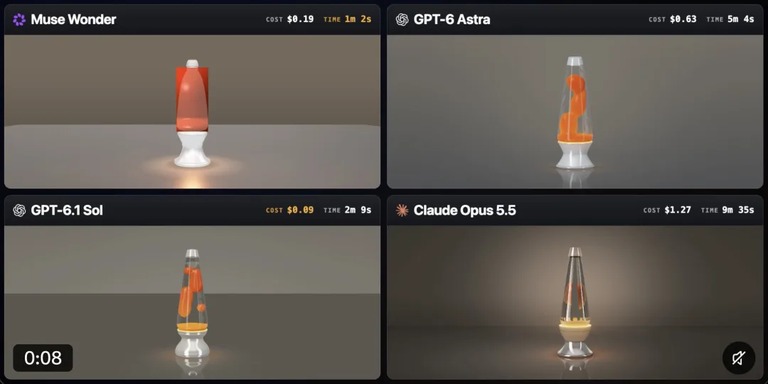
同一个提示词,在最高推理档位下,它和别的模型差得很远。
评分上它高过两家对手,实测里却差得多。
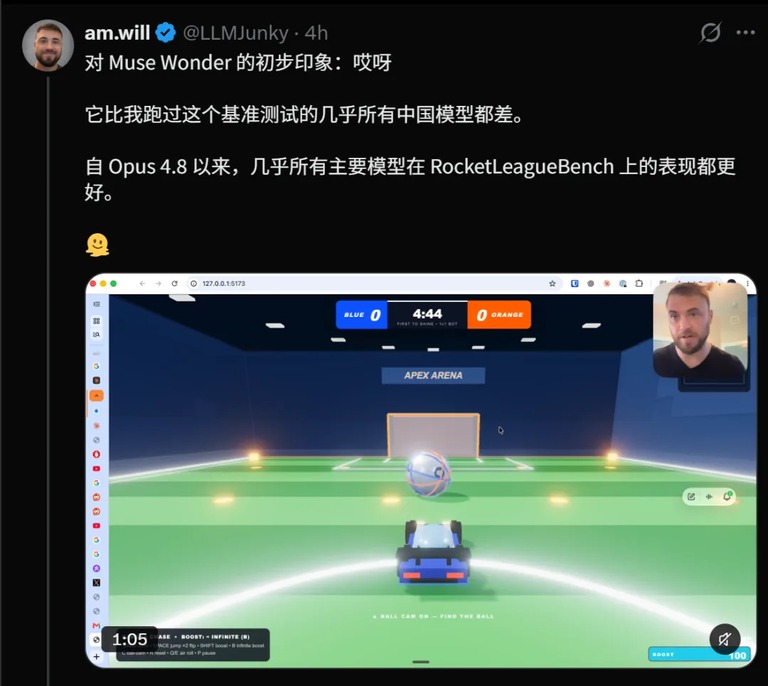
在一个专测游戏操作的榜单上,它的成绩惨不忍睹。
一位开发者说,第一印象极差。
自上一代旗舰以来,几乎所有主要模型在这个榜单上都比它好。
面对质疑,Meta 的首席智能官回应了。
他说整个团队现在都觉得自己挺蠢。
但这是事实,他们确实没在 3D 演示游戏上专门训练过模型。
他不后悔,请大家去真实的编码工作里试试。

那真相真的只是没练过游戏这么简单。
有人替 Meta 说话,说游戏演示很酷,但代表不了真实的写代码。
也有人反驳,说这恰恰说明模型的泛化能力很糟。
毕竟那些游戏演示,本身也是代码写出来的。
官方博客万字长文,正面硬刚两家对手
这次小扎确实有备而来。
官方博客里,Meta 把枪口对准了两座大山。
一家是 OpenAI 的旗舰。
一家是另一家公司的旗舰。
Meta 说,自己花了十四个月,从底层技术栈彻底重构。
这个模型的诞生,标志着它正式踏进了前沿。
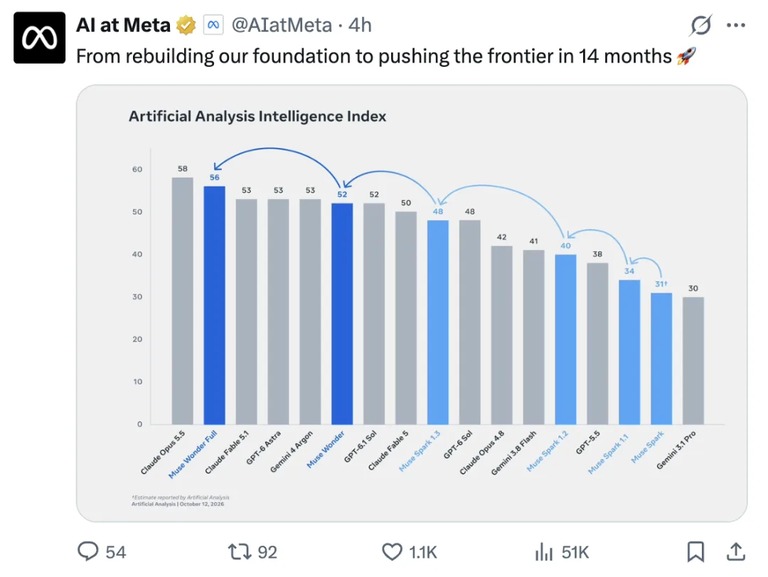
在好几个核心领域,它不只是追平,还超了过去。
先看智能体能力。
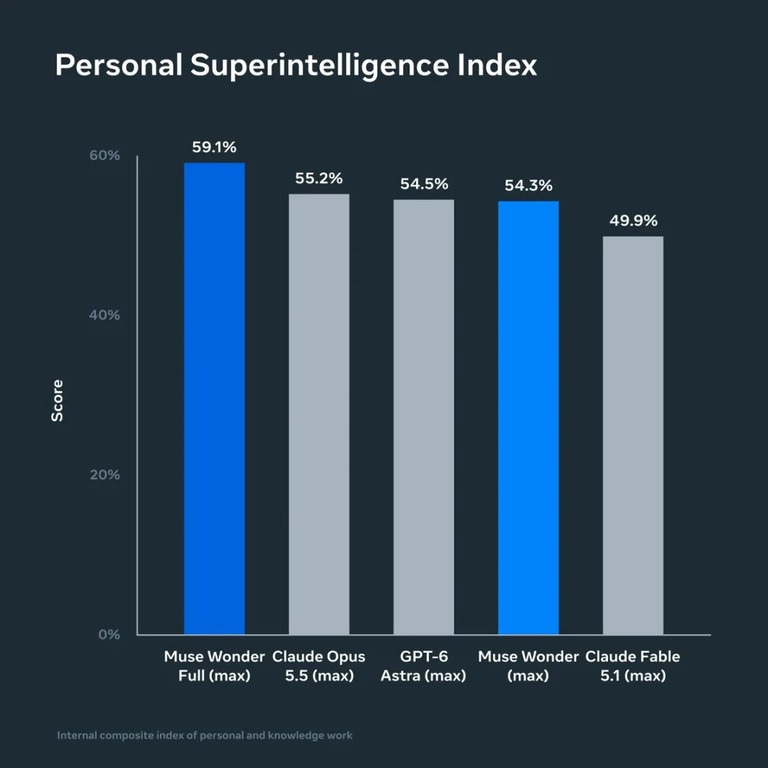
在自建的个人超级智能指数里,完整版拿了 59.1 分。
两家对手分别是 55.2 分和 54.5 分。
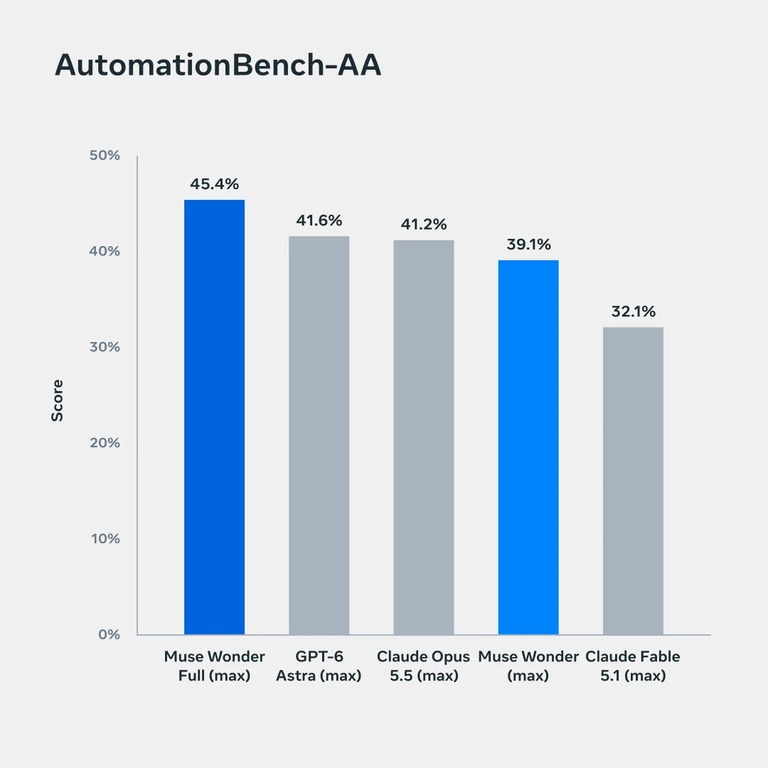
在跑完整业务流程的测试里,完整版拿了 45.4 分。
对手最高只有 41.6 分。
还有个卖点是主动记忆。
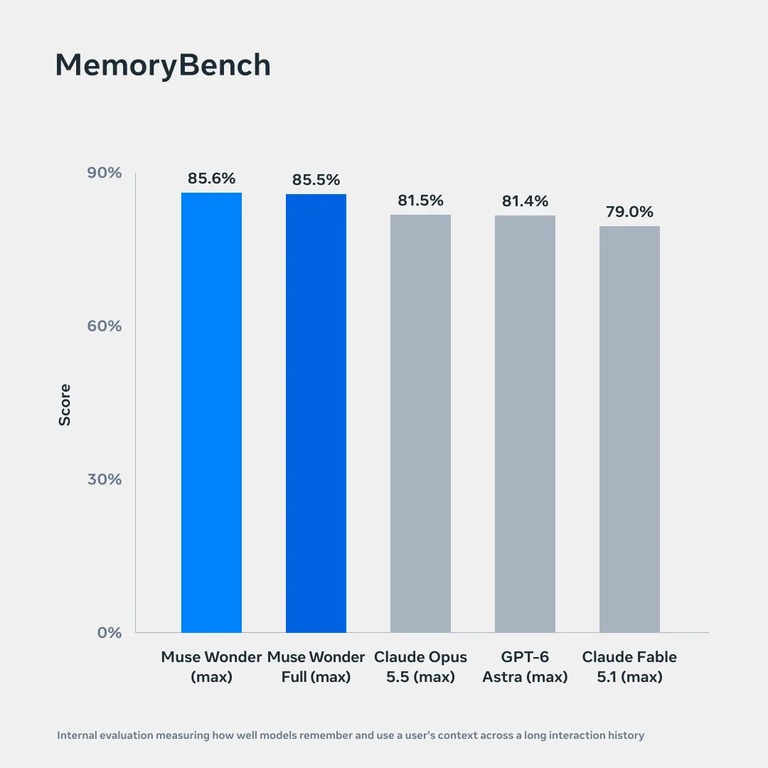
现有模型聊久了容易失忆。
有了它,模型能在很长的对话里记住你的偏好。
在掺了干扰信息的记忆测试里,完整版是 85.5 分,对手是 81.5 分。
另一个卖点叫主动专注。
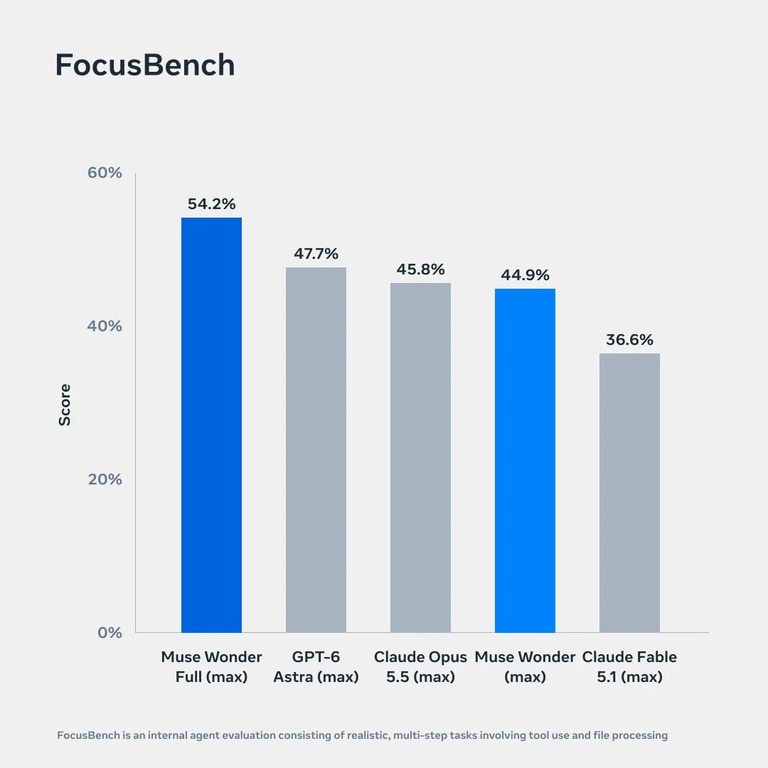
意思是一条路走不通,它自己换一条。
在一项多轮交互、要克服现实障碍的测试里,它很能扛。
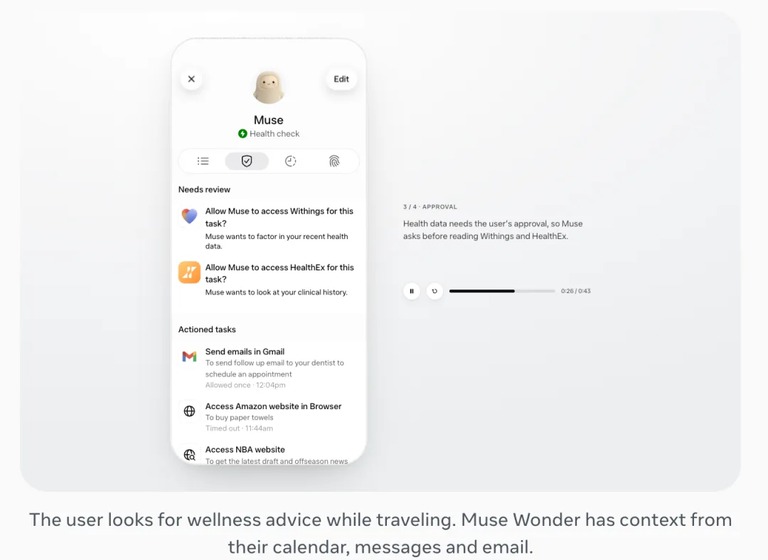
官方演示里,它能在浏览器和多个应用之间自己操作。
还能结合你的日程,排出一份周末跑步计划。
接着是长周期代码。
说到 AI编程,很多人第一反应是那几家老牌强手。
但 Meta 说,写几行脚本和构建大型软件是两码事。
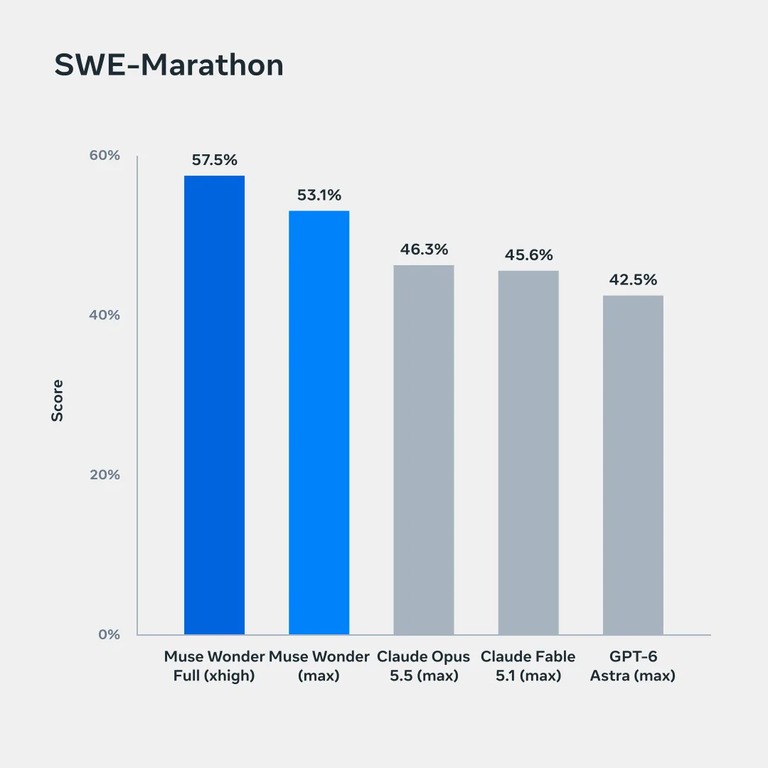
在一项测长时间软件项目的评测里,完整版拿了 57.5 分,对手最高 46.3 分。
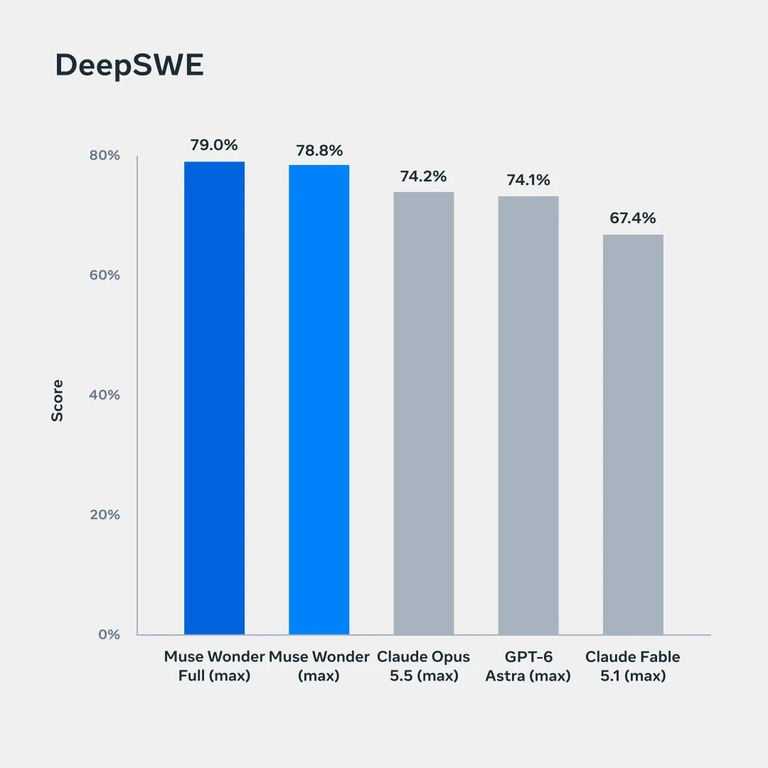
在另一项代码基准里,它同样以 79.0 分对 74.2 分领先。
如果你想让它花几天,去维护一个庞大又枯燥的代码仓库,它现在最能扛。
法律这种垂直领域,它也没掉链子。
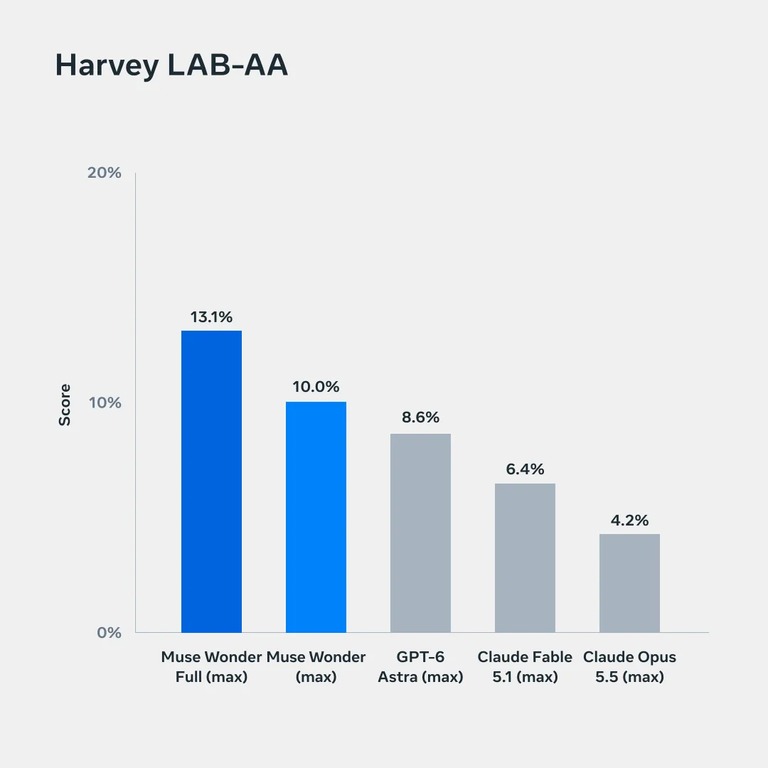
在一项法律智能体测试里,别的模型都叫苦。
它还是以 13.1 分,领先对手最高的 8.6 分。
官方也回应了刷分质疑。
针对网友说的只针对跑分优化,博客甩出一张测试时算力扩展图。
数据说,随着测试时算力增加,它在陌生任务上的表现一路往上走。
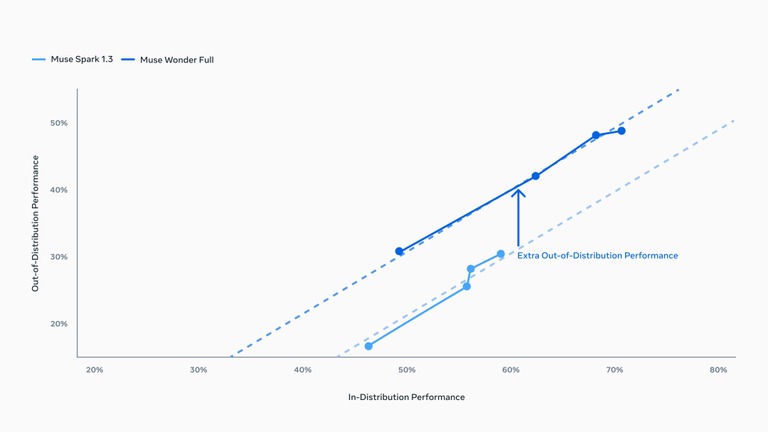
官方解释,这靠的是底下底座模型够强。
它不是应试机器,是真的变聪明了。
光鲜背后,它真的没有短板吗
尽管博客战绩辉煌,Meta 也诚实放出了自己输掉的项目。
仔细看,短板还不少。
第一,部分极客任务和知识储备,还是被两家对手压着。
终端编程这一项,它 57.1 输给了对手的 59.6。
从零写一个完整程序,59.0 又输给了 70.5。
操作电脑这一项,78.4 对 81.8。
专业文档任务上,33.2 输给了 34.2。
第二,最强的版本藏在付费墙后面。
博客里拳打对手的那个,是完整版。
可完整版只开放给付费订阅用户。
开发者现在能调用的,只是主打速度的快速版。
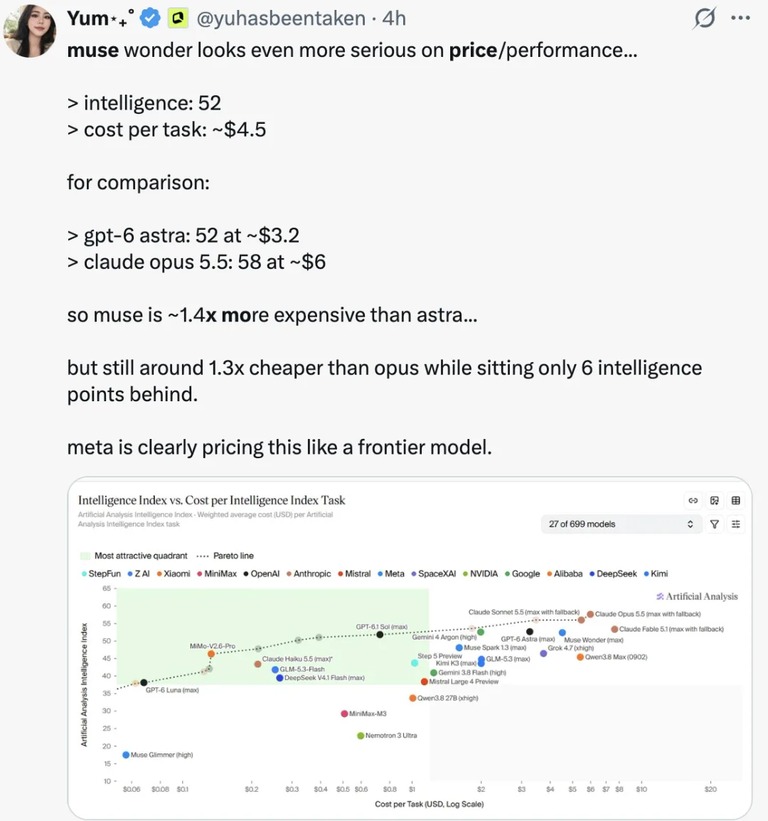
第三方评测显示,快速版综合分只有 52 分,其实还略低于两家对手。
第三,接口价格贵得让人肉疼。
它的上下文窗口有 100 万个词元。
可快速版定价是每百万输入 4 美元、输出 20 美元。
第三方估算,它完成一项测试任务要花 4.52 美元,比对手的 3.26 美元贵得多。
最让人心塞的是,普通人还得等,而且不再开源。
普通用户在 AI对话 里能用的那个助手,还要等官方逐步接入。
当年把开源模型送给全世界的那个小扎,这回在模型卡里只写了保护权重。
对开源一个字都没提。
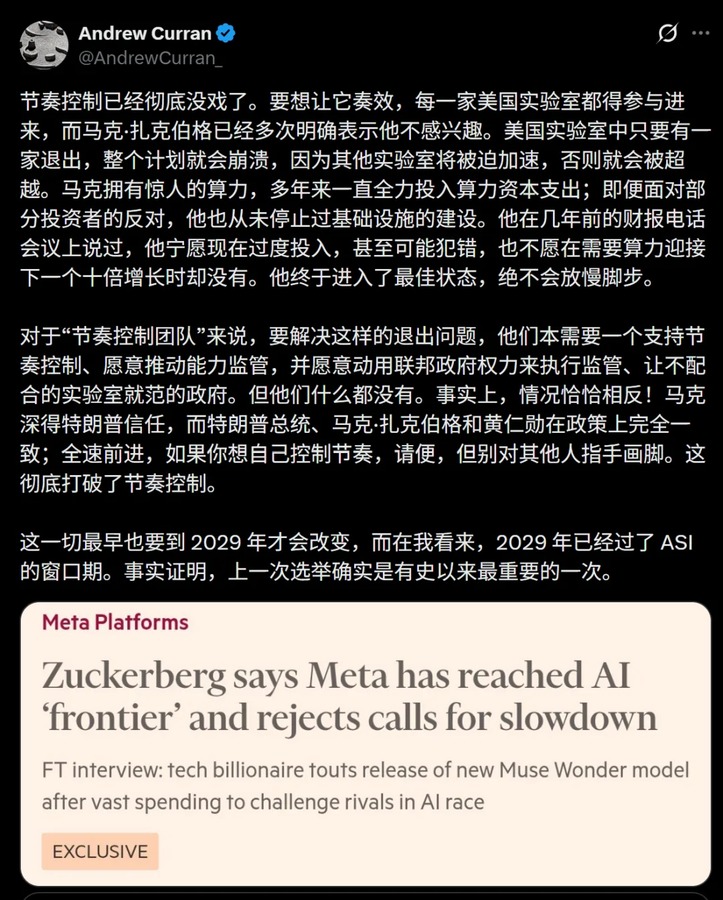
一位长期跟踪行业的大 V 说,节奏控制已经彻底没戏。
所有大厂都在加速。
而 Meta 手握惊人算力,从没停过基建。
播客自曝千亿豪赌,野心藏不住
显然,小扎对这个模型寄予厚望。
在一档知名播客里,他和首席智能官聊了很久。
对谈里,他抛出几个挺颠覆的观点。
第一个,豪赌千亿。
他说前沿模型完全是反直觉的。
你必须在知道模型到底能不能用之前,就先砸下千亿到两千亿美元。
这种赌徒心态,撑起了它背后吉瓦级的数据中心。
第二个,交互界面会消失。
过去的软件靠好看界面吸引人。
但他说,未来的界面会越来越薄。
真正区分产品的,是模型的行为、个性,还有可靠性和记忆力。
模型本身,就是产品。
第三个,智能体之间直接谈生意。
以后你买东西,不再是你自己去刷电商网站。
你的个人智能体会直接去找商家的智能体谈判下单。
他说自己以前一年用两次买菜软件,现在一周用两次。
因为智能体让购买变得毫不费力。
这甚至凭空造出了新需求。
带着这样的愿景,这个模型诞生了。
跑分上超越两个对手,听起来确实惊艳。
但接下来,还要等更多人的实测,才知道它到底几斤几两。
