

过去几年,AI工具 能干的事挺集中。写文字,画图,回答问题。
AI对话 让人和机器能聊上几句。
AI编程 让机器学着自己写代码。
可它们碰的多半是屏幕里的东西。
现在,有人把目标转向了分子。
设计一种蛋白质,过去是件麻烦事。你想让它带某种特性,就得为这种特性单独换一套输入表示。
想改目标,输入也得跟着换。
换一次,等于重来一遍。
很费事。
这条路,一直不算宽。
现在有人想让它简单一点。
只说一句自然语言就够了。
讲清楚你要的形状,要的功能。模型就照着这句话把结构造出来。
说一句话,造一种蛋白质。
这套办法来自华盛顿大学的大卫·贝克团队。他们和新加坡国立大学等一起做的。
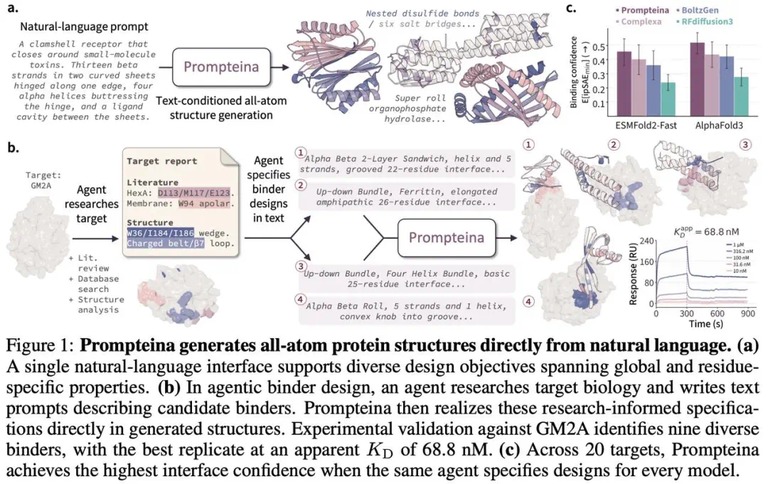
模型的名字叫 Prompteina。
它读进去的是文字,吐出来的是全原子结构。
蛋白设计这件事,开始有点像文生图。一个语言接口,就能同时指定结构和功能。
语言接口,要管到不同尺度
一个好的语言接口,得能指定不同尺度的特性。大到整个蛋白质的折叠类别和整体形状。
小到某个残基上的二硫键,或者催化位点。再小到它和靶标接触的那几个点。
这些都得说清楚。
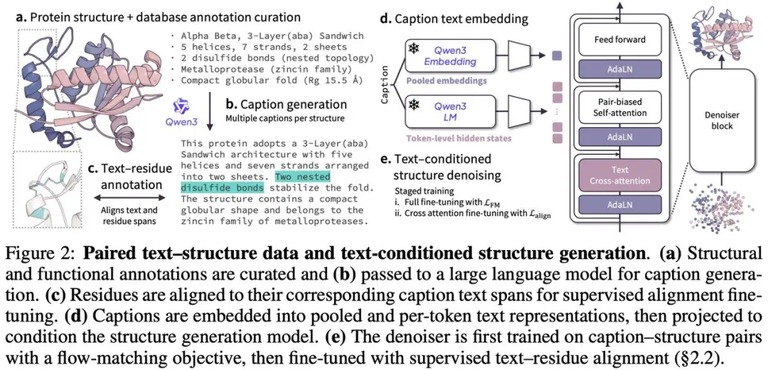
为了训练,团队先攒了一份数据集。
名字叫 Prompteina-Data。
它把结构和跨尺度的文字描述配在一起。结构一部分来自公开的实验库,也用了预测结构和一批合成二聚体。
一共 180 万个结构。
配的说明文字超过 5000 万条。
有的讲整体,有的只讲某个残基。
模型本身,建在一个已有模型上。
他们加了两条读文字的通路,又加了一个对齐目标。
让它一边学结构,一边学文字落在哪。
文字怎么落到残基上
这个已有模型的去噪器,先算出主链坐标和每个残基的侧链潜变量。
再交给一个固定的解码器,把这两样还原成全原子结构和氨基酸序列。
为了让每个残基,都能收到同一份整体信号。
他们把一段冻结的文本嵌入广播出去。
每个残基拿到的,是同一句话的分量。
预训练的时候,他们用的是流匹配损失。但哪段文字对应哪几个残基,并没有直接管。
数据集里标注了不少残基位置。
这些位置,被拿来做成文字和残基的对齐。
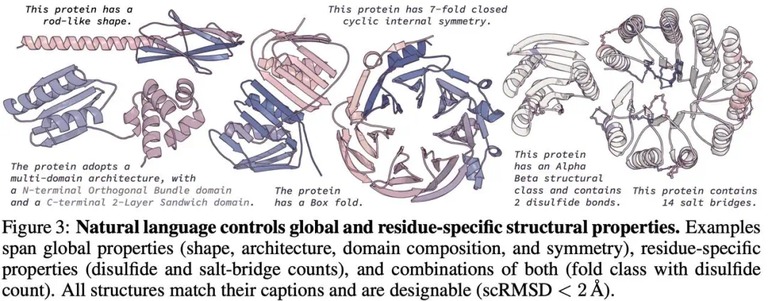
有了这套接口,能指定的东西不少。整个蛋白质,或者每个结构域的折叠类型。
螺旋、链和片层的数量,二硫键和盐桥的数量。
它管大小和紧凑性。
也管对称性和柔性。
表面的平面性,和疏水倾向。界面的残基数量和埋藏面积。
还能点某一类功能,比如某种酶。
一个接口,把这些都装了进去。
它现在支持单体设计,也支持蛋白质结合体的设计。
还能在设计活动里,和智能体接上。
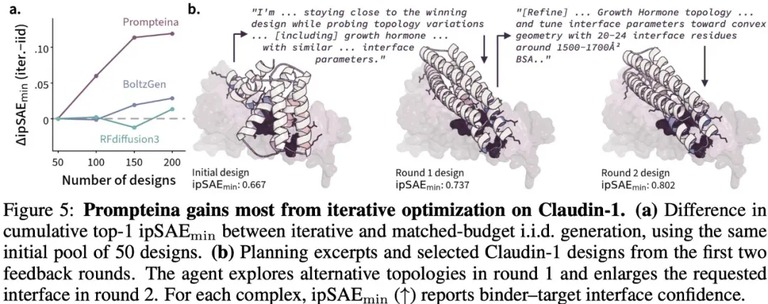
智能体把研究结论直接写成提示,用同一套接口拿到更高的界面置信度。
拿基准说话
在结构特性的基准测试里,它考了 18 项,其中 15 项跑到基线前面。
能支持的特性,比任何单个基线都多。
造出来的蛋白质,也更贴合那句描述。
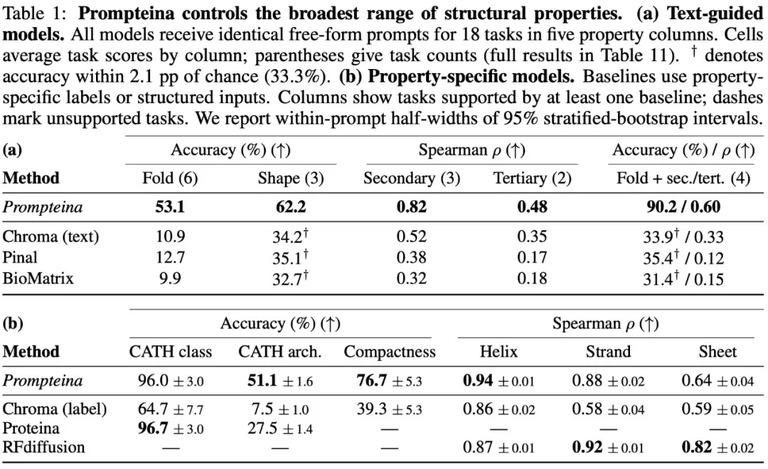
尺子放得更细,结论也稳。
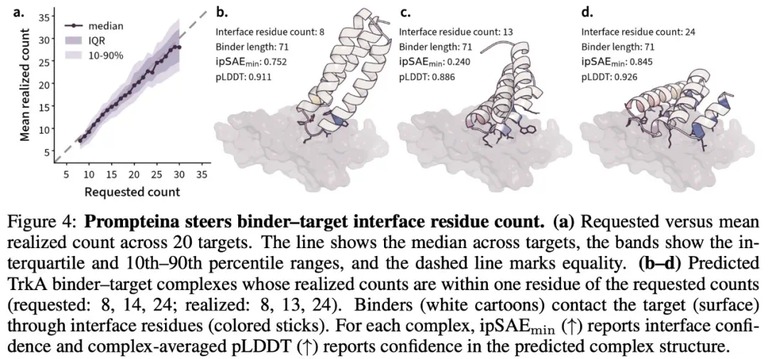
在 20 个靶标上,它调控界面残基的数量。
很准。
两者的相关性,超过 0.99。
除了调单个界面特性,他们还测了智能体主导的设计过程。同一个语言模型,按各家接口支持的特性写规格。
20 个靶标里,它至少在 13 个上赢过所有基线。
界面的置信度,比最强基线高了 14%。
他们还做了一次真刀真枪的验证。
靶点是 GM2A。
它和一种神经节苷脂沉积症有关。此前没有人报道过从头设计的结合体。
90 个测试设计里,它做出了 9 个。

这些结果指向一件事。自然语言,可以当一种有效的条件化接口。
跨尺度的结构和功能,都能由它来控制。
语言里的推理,也能接进蛋白质设计。
从一句话,到一种能用的分子。
