

同一个问题。问 DeepSeek 两遍。只多敲了几个空格。答案一个像天才,一个像智障。
不是段子。
九月底,字节团队一篇论文把它写了下来。
论文题目是 Periodic Weak Spots。
矛头对着 DeepSeek V4 系列。
说它身上有一种神鬼二象性。
平时用 AI对话,你大概率碰不到。
但真拿它处理长文本,迟早会撞上。
问题埋在算法底层。也就是分块 KV Cache 压缩。它把长上下文切成固定长度的小段。
每一段压成一个小摘要。
显存压力立马就轻了。
代价是位置开始决定命运。
核心词要是落在切段的交界处。
那块地方又叫盲区。
模型只能胡言乱语。
这是 DeepSeek 用来省显存的杀手锏。
如今成了它的盲点。
想象一份几十页的合同。
关键条款刚好卡在盲区里。
模型直接无视它。
给出一个相反的结论。
你多半还找不到问题出在哪。
这种短板不止 DeepSeek 一家有。
只要用了分块压缩。
或者稀疏化。
多少都沾一点。
开源的 Llama 3 系列也一样。
字节是怎么抓住这条小辫子的
线索来自一次代码补全。
要补完一个量化函数的最后一个词元。
按代码逻辑,正确答案是 8。
研究人员在代码最前面加了一串等号。
纯装饰用的。
模型输出了 32。
更怪的在后面。
出错概率和等号数量直接挂钩。
等号数量除以 4,看余数。
余数是 0 或者 1,大概率答错。错误率高到 71.3%。余数是 2 或者 3,又答对了。正确率 91.5%。
字节顺着这条线往下挖。
挖出了分块压缩留下的先天短板。
它把连续的词元按固定长度切开。
每一段里,词元靠一个门控层压缩。
显存省下来了。
新麻烦跟着来。
标准注意力只看词元之间的相对距离。
一句话放哪都一样,只要词序不变。
分块压缩之后,绝对位置也变重要了。
这个位置叫相位。
门控层给不同位置分配不同权重。
那个权重叫槽位增益。
排到强势槽位的词元,模型答得准。
排到盲点槽位的,几乎被忽略。
模型就答错。
这种对排位敏感的现象。
叫相位敏感性。
再往里看,注意力头还形成了分工。
有的只管段内靠前的位置。
有的只管靠后。
这种分工。
让某些排位成了薄弱环节。
为了证明不是巧合。
团队又做了一轮大海捞针。
上下文拉长到 128K 词元。
里面塞了差不多 1.6 万个键值对。
每个键对应一个值。
键值关系不变,问题不变,长度也不变。
只把其中一个键值对挪个位置。
模型还能答对吗。
结果差距大得吓人。
同一个模型。
不同位置之间的准确率,最大差了 40.2%。
换成更大的版本,差距 34.8%。
后训练优化过一轮,依然有 19.1% 和 14.8%。

面对这种周期性盲区。
DeepSeek 试过一招。
把压缩步长直接砍半。
步长是 4 的时候,每一轮分 4 个槽位。
不同槽位的权重差得很远。
处在边缘的词元。
很容易被连续两轮丢掉。
步长降到 2,压缩变细。
一个周期里。
词元只剩两种相对位置。
关键信息就算落在偏弱的奇数位。
相邻只差一个词元,不容易被完全丢掉。
准确率差距确实降到了 6.1%。
问题并没有消失。
字节干脆用一个小架构从头训了一批模型。
配置全一样,只改压缩机制。
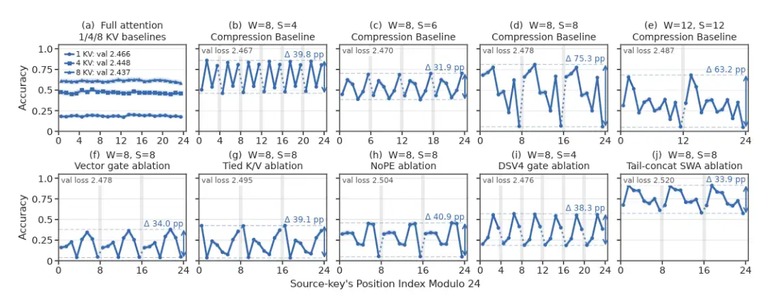
结论很干净。凡是采用分块压缩的,都出现周期性波动。没有压缩的全注意力基线,一点没有。
波动周期,严格等于压缩步长。
把位置编码去掉,波动还在。
把门控权重换成平均分配,照样波动。
这说明一件事。
这是方案本身的结构缺陷。
调参,换位置编码,再后训练。
都除不了根。
有网友给出另一条思路。
让切块本身活起来。
按内容的重要程度,动态决定边界。
词元没有固定相位。
相位差也就无从谈起。
这个方向,学界叫动态分块。
做 AI工具 的人,最近常听到这个词。
动态分块是解药吗
它的核心,是扔掉一刀切。按语义和重要性,灵活调整切块。这条路要动的东西很多。
从算法数学到显存管理,再到硬件。
整整三层。
第一层,重构注意力的数学基础。
切多大,跟着内容走。
信息密度低的废话,直接大块合并。
遇到关键转折,就切得足够细。
不管关键信息藏在哪,模型都能捞到。
这等于在数学上,挽回了平移不变性。
再进一步,模型还能先扫一眼密度。
再决定切多大。
该快读的地方快读。
该细品的地方慢下来。
架构底层,长出了一点快慢思考的本能。
第二层,倒逼显存管理往前走。
以前为了算得快。
缓存都按固定大小的块来管。
简单,规整,好操作。
代价是显存利用率上不去。
动态分块之后。
静态的连续矩阵撑不住了。
得往拓扑稀疏矩阵演进。
靠一层动态索引来寻址。
研究还发现,不同层的切块边界很像。
可以直接复用。
动态寻址的开销,一下就摊薄了。
第三层,是硬件对齐。
显卡天生偏爱规整的矩阵。
边长能被 8,16,32 整除,算起来最舒服。
这也是全行业的老习惯。
长期坚持固定分块,最现实的原因就在这里。
块大小要是参差不齐。
专为矩阵计算打造的加速单元。
就大量空转。
业界已经摸出了一些解法。
比如零填充算法。
物理上把长短不一的语义块紧密拼在一起。
逻辑上,还保住每一块的边界。
眼下,顶级实验室正从两个方向推进。
一个方向是语义连续性。
另一个方向是稀疏计算。
最出名的成果是 ChunkKV。
它由香港科技大学广州团队提出。
走的是语义连续性这条路。
以前主流的压缩法。
思路都是给单个词元打分。
留下重要的,丢掉不重要的。
一句话的主谓宾,很容易被拆得七零八落。
ChunkKV 换了单位。
以连续的语义块为基本压缩单位。
要么整块留,要么整块丢。
留下来的都是完整的短语和句子。
在大海捞针基准上,缓存压到 128 时。
它的准确率到 73.8%。
老方法只有 58.9%。
做 AI编程 的助手,长代码库里最吃这一套。
另一条路上,还有几个代表。
Jina 团队盯着检索场景。
提出了延迟分块。
不再先切文本再解析。
而是先让模型读完整篇。
吃透全局。
最后输出前,再按语义自然分界切。
微软亚洲研究院有个 MInference 框架。
专门用来治超长文本。
研究发现。
注意力矩阵存在可利用的稀疏规律。
框架给不同的注意力头。
配不同的稀疏算法。
检索准确率不降。
百万字上下文的预填充。
最高提速 10 倍。
长上下文的上半场。大家比的都是谁能处理得更长。压缩技术功不可没。
可长文本的本质,从来不是为了长而长。
真拿它处理真实任务时。
能用,好用,不丢信息,才是新的硬指标。
对做 AI工具 的人来说。
这一点比参数更实在。
