9 月 27 日,国际象棋奥林匹克团体赛在撒马尔罕收官。
乌兹别克斯坦 2.5 比 1.5 拿下乌克兰,第二次捧起公开组金牌。
中国女队第七次登上女子组最高处。
下一场重头戏在 11 月底。
两位 20 岁的棋手古克什与辛达罗夫,要在日内瓦争夺世界冠军。
这是史上最年轻的一次世界冠军对决。
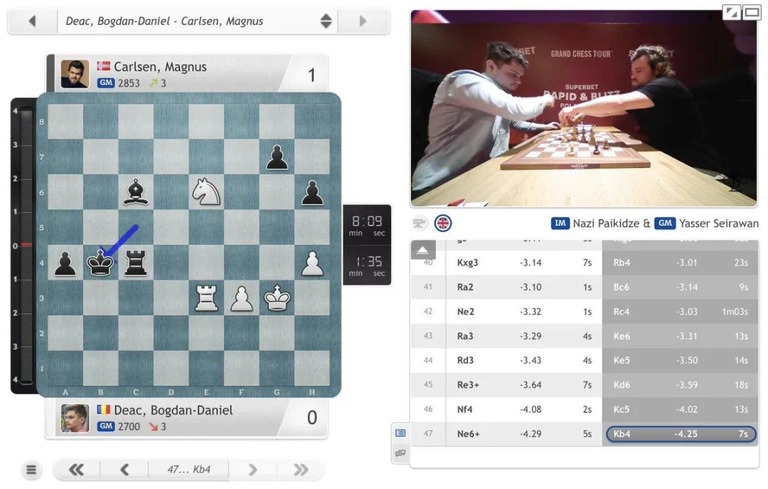
看过多年的顶级棋赛直播,画面一侧总有那根竖条。
它上下浮动。
此刻白方领先半个兵。
某一步能让胜率掉一大截。
可从不说为什么。
这其实是 AI 领域一个老问题。
最强的 AI工具 常常是沉默的。
最会说话的模型,进了专业领域又不够看。
国际象棋引擎早把人类甩在身后。
它却说不出一句人话。
前沿大模型讲得头头是道。
推荐的着法本身未必站得住,解释也就成了无本之木。
近日,普林斯顿大学陈丹琦团队在 arXiv 发布了一项成果。
他们想把这两头接上。
他们训出来的模型名叫 QUEEN,总参数量约 4B。
棋力接近一位典型特级大师。
同时,它还能开口讲棋。
讲清自己为什么这样走。
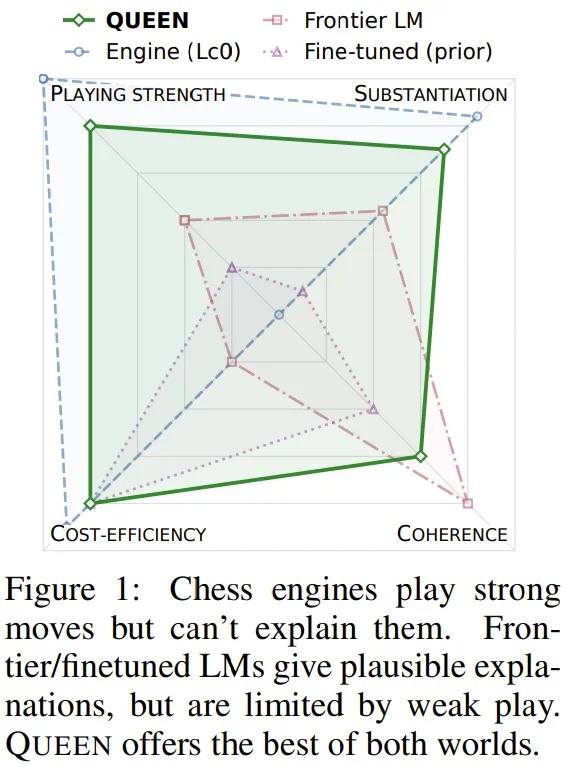
会下的不会说,会说的下不好
国际象棋和 AI 的缘分,要追到 1950 年。
那一年,克劳德·香农估算了国际象棋的计算复杂度。
他还设想了一台下棋机器的样子。
此后七十多年。
引擎一代比一代强。
从靠手工评估函数的深蓝,到靠自我对弈长大的 AlphaZero。
再到基于注意力架构的 Leela Chess Zero。
但它们交出来的,始终只是一个着法和一串胜率数字。
语言模型这边的问题正好相反。
论文梳理发现,早先专门调过的国际象棋语言模型,大多只在孤立的战术题上训练。
连这种题都选不好。
解释的质量自然有限。
如今的 AI对话 模型进步明显,能给出像样的解释。
代价却不小。
作者在附录里提到,用前沿模型的高推理档下一整盘棋,成本常常超过 15 美元。
这件事不只在棋盘上。
论文说,截至 10 月 2 日,全球共有 1899 位特级大师。
万分之一都不到。
绝大多数棋手一辈子都等不到一位特级大师坐下来,给自己讲棋。
一个既下得好,又讲得清,还跑得便宜的模型,填的正是这块空白。
一位沉默的大师,一位会说话的解说员
QUEEN 的思路,可以用一个场景来说。
让一位只会用手指棋盘的沉默大师,和一位口才很好但棋力平平的解说员搭伙。
大师负责看,解说员负责说。
关键在让解说员真正读懂大师的手势。
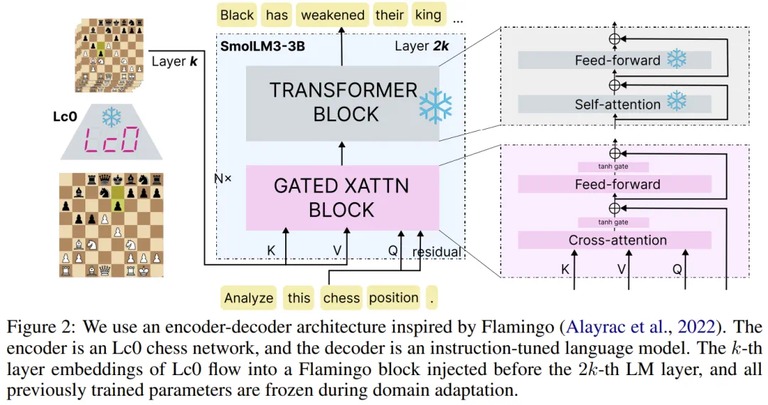
具体来说,那位沉默的大师是 Lc0 家族的 BT5 网络。
它有 240M 参数,15 层。
输入固定为 64 个 token,正好对上棋盘上的 64 个格子。
不做搜索也很强。
解说的是一个通用指令模型,HuggingFace 家的小模型。
它平时干的活是 AI编程 和写作这类杂事。
它没学过棋。
两者之间的桥梁,借鉴了视觉语言模型 Flamingo 的门控交叉注意力。
大师第 i 层的表征,接到语言模型第 2i 层之前。
中间一共插入 16 个桥接模块,约 470M 参数。
与原版只取编码器最后一层不同。
这种逐层对接,让语言模型能同时看到浅层和深层的想法。
门控的初始值设为零。
桥接一开始相当于不存在,再随训练慢慢打开,免得早期噪声捣乱。
接下来是教解说员读懂手势。
团队设计了一套四阶段问答课程,由浅入深。
先问某个格子上是什么子这类静态问题。
再问这匹马能走到哪、谁能将军这类动态问题。
然后给出 1 到 8 步走法,让模型推演出未来局面再作答。
答案全由程序生成并校验。
这一阶段,大师和语言模型本体都被冻住,只训练桥接层和新增的词表。
之所以要新增 64 个格子和 12 种棋子的专用 token,是因为原来的分词器对格子名拆得不一致。
而象、马这些词在日常语料里带着与棋盘无关的含义。
练完之后,模型在四类问题上的准确率都在九成以上。
最高的两类到了 99.97%,另外两类是 98.97% 和 96.07%。
用自然语言版的贝尔曼更新自我进化
学会读棋之后,模型还不会写分析。
团队先拿前沿模型的低推理档,为 15000 个局面生成示范解释。
这一步花了 652.35 美元。
滤掉含非法着法或失误的样本后,剩下 8602 条,用来做第一轮监督微调。
得到的模型等级分是 1782。
解释写得通顺,推荐的棋却常常不靠谱。
真正让它变强的,是新提出的迭代搜索蒸馏。
灵感来自 AlphaZero。
用搜索得到更好的判断,再把判断压回网络里,让网络下次不搜也能直接想到。
QUEEN 把这个过程搬到了自然语言上,当作贝尔曼价值更新的语言版本。
这很像一位棋手的复盘习惯。
面对一个局面,模型先写出三个候选着法。
然后分别走一步,把三个新局面各自重新分析一遍。
如果某个子局面的分析本身就错了,就顺着这个错误继续往下钻,直到找到模型刚好力所不及的位置。
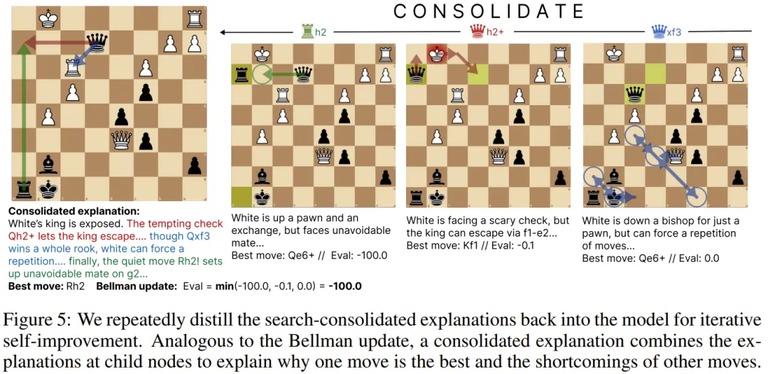
随后,由另一个通用模型把三份子分析合并成一份完整解释。
它要讲明为什么选这一步,另外两步差在哪。
它还被明确要求不得添加任何新内容。
只有当合并后的结论比模型原先的判断更好,这条数据才会被留下,用来训练下一轮。
论文给了一些例子。
白方面对三个候选。一步是安静的车挪,一步是诱人的将军,还有一步是吃子。
从对手视角看,三个子局面的评估分别是被将死、微差和均势。
取对对手最不利的那个,结论反而是那步安静的车挪才是杀着。
将军反而是坏棋。
每一轮大约从 40 万个根局面出发,最终产出 15 万到 28 万条训练数据。
七轮之后,第八代模型被正式命名为 QUEEN。
棋力方面,每个模型和 8 个强度不同的引擎各下 32 盘,再按 Lichess 的等级分体系换算。
QUEEN 最终拿到 2697 分。
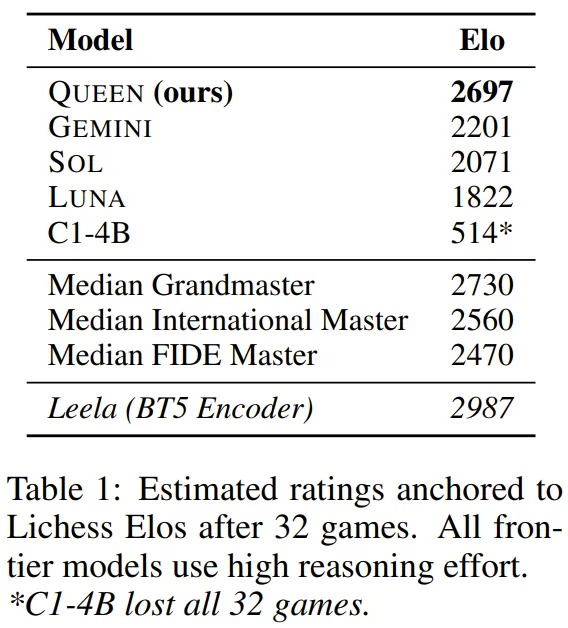
作为对照,另有前沿模型是 2201 分和 2071 分。
同为 4B 规模的前作则全负。
Lichess 上特级大师快棋等级分的中位数是 2730。
它摸到了那条线。
七轮迭代里,分数从 1782 一路涨到 2697,累计提升 915 分。
中间第五到第六轮曾短暂回落约 100 分。
论证能力方面,团队在 1000 道战术题和 1000 个实战局面上做检验。
他们看模型给出的主变是否出错。
战术题上,QUEEN 首步不失误率是 91.6%,比第二名高出 9 个百分点。
实战局面上是 97.1%。
不过论文也坦率写了短板。
在一份前沿模型担任评委的打分里,它的结构连贯性和对手持平。
概念连贯性只有 2.76,明显低于对方的 3.61。
语言流畅度也略逊。
它找的变化是对的。
可用牵制、前哨这类术语描述局面时,更容易张冠李戴。
作者分析,自我蒸馏能把搜索树慢慢压进权重,却教不会模型描述它没见过的棋型。
错误还会层层传递。
消融实验给出两点。
大师的编码器和那套四阶段课程缺一不可。
去掉任何一个,棋力都跌到 514 分。
另外,它并非复读大师。
在有 5 个以上合理着法的局面里,它有 53.8% 的情况选了与大师不同的棋。
团队还试了完全不依赖前沿模型的版本。
用另一款传统引擎手工评估特征,再加模板生成初始解释。
结果前四轮的棋力反而更高,第一轮就到了 2115 分。
结语
QUEEN 的价值不只在棋盘上。
它真正给出来的是一套配方。
在一个已经有沉默专家的领域,用交叉注意力把专家接到语言模型上。
先用课程教会语言模型读懂专家的表征,再用搜索加蒸馏,让解释越写越好。
作者认为,这套方法可以搬到游戏、机器人和计算机操作这些地方。
它们恰好都不缺强大但不爱说话的专用模型。
一个多月后,日内瓦会办世界冠军赛。
直播里那根评估条,还是只给数字。
而能把数字讲成道理的 AI,或许已经不远了。