

一个男人对着镜头拧魔方。
屏幕里的女孩盯着他手上的动作。
他卡住了。低头琢磨,她没有插话,只是安静地等着。
等他重新动手,她才接上一句。
如果没人说破,这就是一次再普通不过的视频通话。
可屏幕里那个女孩并不存在。
她的脸,她的声音,她每一次点头和停顿,全部由 AI 实时生成。
10 月 1 日,美国一家做 AI视频 的公司发布了一个新模型。
它给自己贴的标签很特别,全球第一个「人类交互模型」。
名字本身就够新。
官方给了一组数据。
数字很硬。
在一分钟的视频通话测试里,54 名参与者中有 26 人事后以为自己在跟真人聊天,比例接近 48%。
作为对照,这家公司上一代系统在同样的测试里,41 个人只骗过了 1 个,2.4%。
从 2.4% 到 48%,这不是一次常规的版本迭代。
是质变。
过去几年,数字人这条赛道拼的是脸像不像。
现在它想证明的是另一件事,AI 开始学会像人一样聊天。
重点换了。
一、一个不出戏的数字人
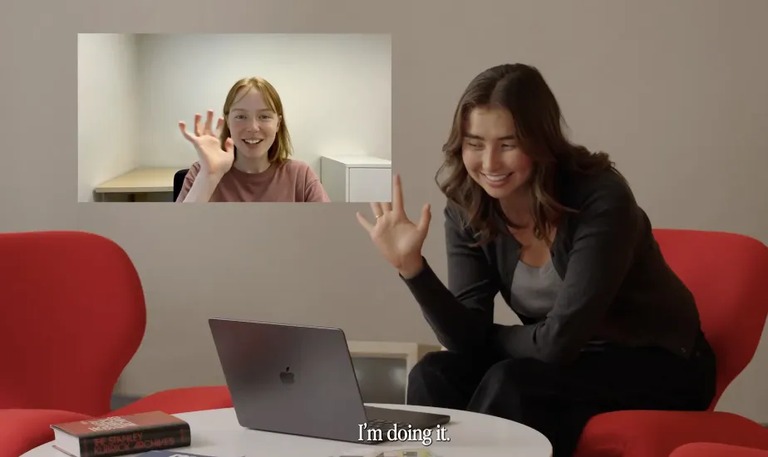
这家公司给新模型准备的发布视频,本身就是一次 AI视频 通话。
画面里,公司的负责人深夜坐在办公室,打开笔记本。
屏幕那头是一个戴眼镜的年轻女孩,名叫凡妮莎。
她先开口,说这么晚了你还没走。
像老朋友。
两个人聊起一件正事,新模型该怎么向外界介绍。
负责人有点犹豫,说解释来解释去,不如直接给大家看。
女孩接过话头,提议干脆就放一段他俩聊天的录像。
于是你看到的那段视频,就是那段录像。
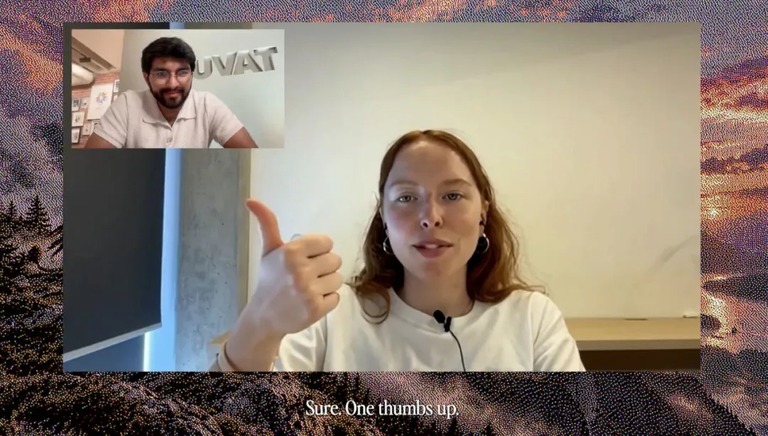
接下来一分多钟里,两个人像老同事一样互相打趣。
他让她比个大拇指,她立刻照做。
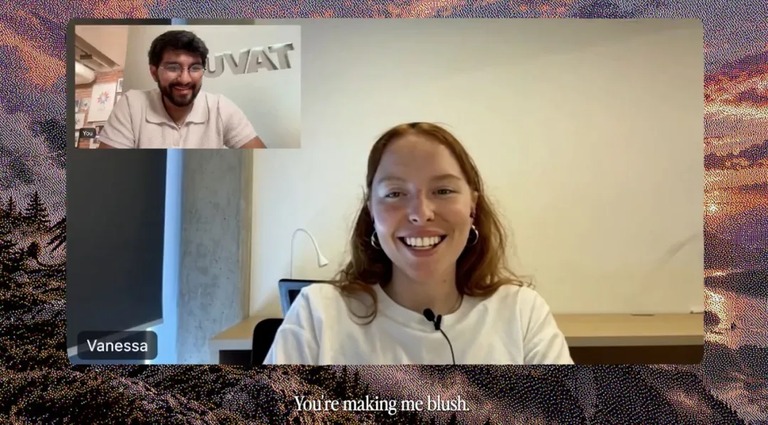
他夸她是最喜欢的同事,她笑着说你让我脸红了。
笑点接得上。
中途还有另一位同事凑进镜头,她很自然地跟两个人一起聊。
视频临近结尾,负责人感慨,跟机器说话和跟人说话之间那条线,正在变得非常非常薄。
整段视频最出戏的地方,恰恰是它没有出戏。
她的停顿停得自然。
没有那种数字人特有的机械感,等你说完,愣一秒,再开口。
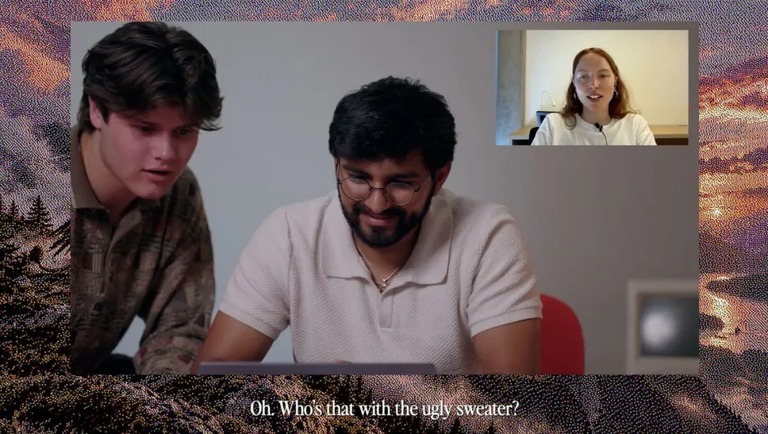
当然,这是一段精挑细选的宣传片。
更能说明问题的,是这家公司放出的几段技术测试片段。
他们找来从没用过这个模型的普通人,跟它做开放式对话。
全开放。
第一段是教魔方。
一个测试者边转边听它指导,它盯着他手里的魔方,持续给出确认。
当他停下来思考,它会一直等到他准备好再开口。
懂节奏。
第二段更进一步。
一位工程师在焊主板,它在一旁指导,会记录时间和他在任务里的进度。
该做下一步的时候,它主动开口,而不是一见他沉默就插话。
这件事对人来说稀松平常。
对 AI 却很难,它得理解沉默本身也是一种信息。
第三段是经典的「西蒙说」,只有对方说出那句口令,它才模仿动作,没说就当场拆穿。
画面里的每一个动作都是现场生成的,身体和背景也算在内。
不是贴图。
还有几段专门展示抢话。
这才是难点。
有人告诉它自己升职了。
它在对方话还没说完时就做出反应,两人短暂地同时开口,却没有乱了线索。
这些片段都指向同一件事。
过去的数字人是个会动的播音员。
只会念稿。
而它,开始像一个会接话的人。
二、从声音到画面
要理解它为什么做到这一步,得先看过去的数字人怎么工作。
市面上绝大多数实时数字人,用的都是一种级联架构,像一场接力赛。
先由语音识别模型把你说的话转成文字。
再交给大语言模型生成回复。
然后由语音合成模型把文字念出来。
最后让一张脸跟着声音动起来。
四步走完。
这套流程的问题很明显。
延迟躲不掉。
每多一次交棒,就多一份延迟,也多丢一份信息。
你说话时的语气,皱眉的表情,手里拿着的东西。
它们在文字转写那一步就被扔掉了。
更要命的是,它必须等你把话说完才能开始处理,于是就有了那种标志性的尴尬。
这家公司自己就是这条路线上的头部玩家。
它也踩过坑。
它上一代方案由三个模型组成,一个渲染人脸,一个判断什么时候该说话,一个感知用户的情绪。
这套组合已经被 15 万开发者和企业使用,可真人在测试里的通过率只有 2.4%。
新模型的思路,是把这场接力赛,变成一个大脑同时处理所有事情。
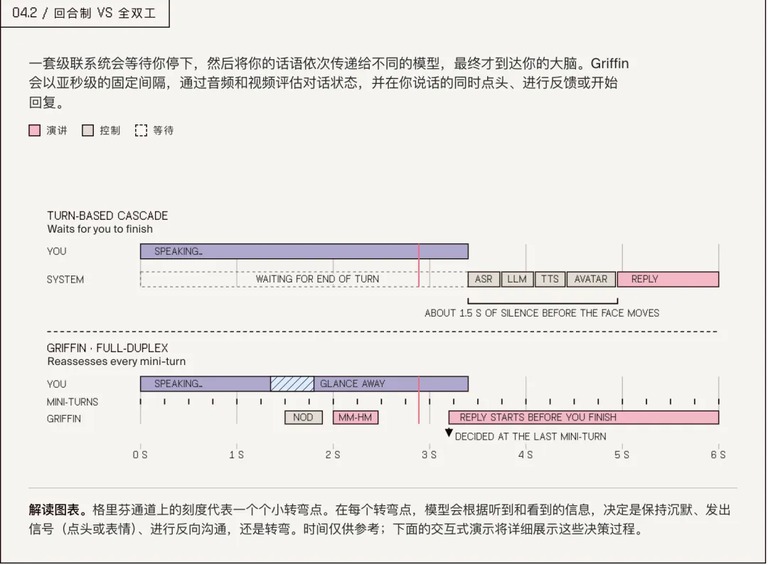
它被定义为一个全双工、视频到视频的模型。
词有点绕。
全双工的意思是像打电话那样能同时听和说,而不是像对讲机那样你一句我一句。
它由两大部分构成。
一个想,一个演。
第一部分叫连续对话建模。
它一直在听。
它不再按轮次等待,而是每隔不到一秒就重新评估一次对话状态。
综合你说了什么,怎么说的,脸上什么表情,镜头里有什么。
再决定此刻该说话,该点头,该嗯一声,还是继续安静地听。
它输出的不只是要说的字。
还有一整套控制信号,涵盖情绪,姿态,表情和手势。
正因为判断依据是语义,而不是声音停了没有,它才能分辨出你是说完了,还是在停下来想事情。
第二部分是音视频生成引擎,负责把这些控制信号变成声音和画面。
最难在画面。
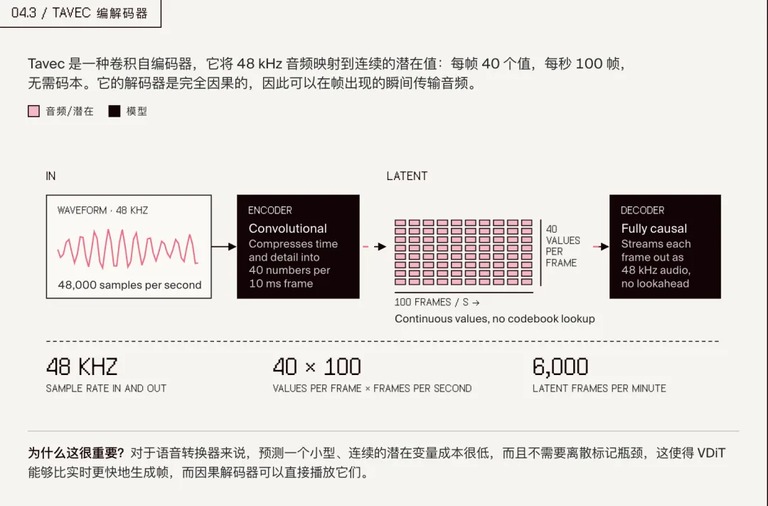
语音这一侧,团队自研了一个音频编解码器。
它把 48kHz 的音频压成每秒 100 帧、每帧只有 40 个数值的连续表示。
在这个紧凑空间里,一个自回归扩散模型边接收指令边生成语音,最小以 10 毫秒为单位往外输出。
一句话还没生成完,前半句已经在播放了。
边算边播。
它还能用大约 10 秒的录音克隆一个人的声音。
视频这一侧是最难的部分。
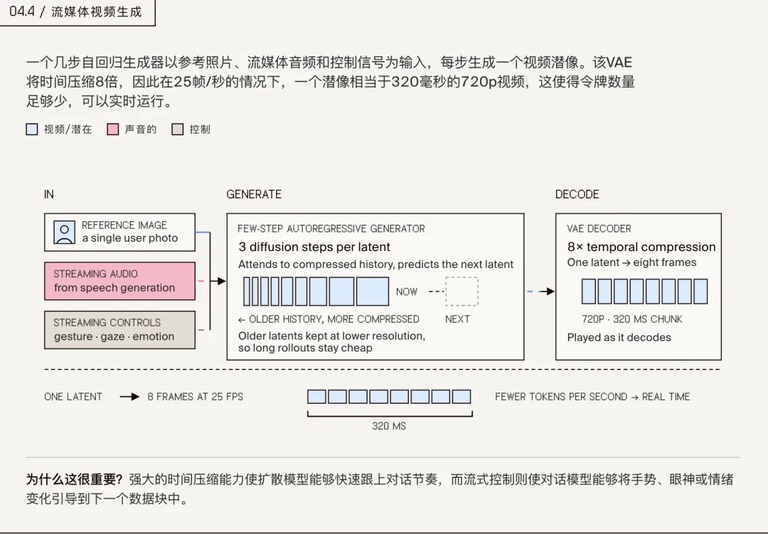
高质量的视频扩散模型通常要几十步迭代,而且一次生成一整段,根本不可能实时。
团队的做法是蒸馏,分三步把一个庞大缓慢的模型压成又快又稳的版本。
先用分布匹配蒸馏把几十步压到几步。
再改造成一帧接一帧生成的自回归结构。
最后用一种自强制的方法训练,让模型在自己生成的历史画面上继续生成。
这样做,是为了避免时间一长画面漂移,人脸走样。
再加上视频编码器在时间维度上做了 8 倍压缩,它最终能以 320 毫秒为一块,实时生成 720p 视频。
从听到声音到脸上做出反应,平均延迟 0.43 秒,团队称这只有次快方案的一半。
快了一倍。
还有一个容易被忽略的变化。
细节在底下。
前几代模型依赖大量三维人脸先验,很难做出大幅度的手势和身体动作,背景也只能是静态的。
新模型抛掉了这些先验,只用一张参考照片,就能实时生成画面里的每一个像素。
椅子的晃动,投在墙上的影子,手指的动作,还有人物身后的背景,都在模型的控制之内。
第三方评测也给了一些佐证。
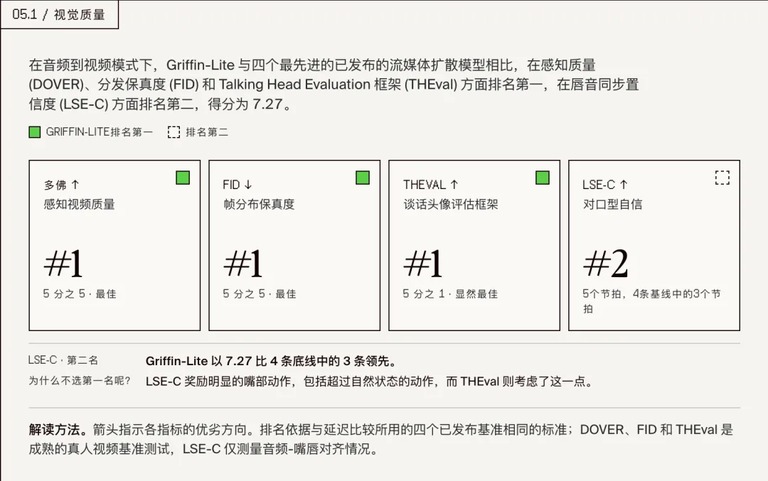
在一个全双工音视频对话基准上,轻量版在生成赛道拿到 3.83 分,满分 5 分。
它比排名第二的组合高出一分多,离人类参考值 3.92 只差 0.09。
在考察看懂对方的感知赛道,它也以 3.73 分排在第一。
两项第一。
如果把视野拉长,这条路其实并不陌生。
有先例。
2024 年,一款旗舰语音模型发布时,就是用端到端,取代了语音识别加语音合成的三段式流程。
它让 AI 语音第一次有了插话,语气和停顿。
而这个新模型做的,是把这场端到端革命,从声音推进到了画面。
三、下半场比的是什么
它真正的冲击,可能不在于有多像真人。
而在于它重新定义了这门生意该比拼什么。
比法变了。
过去几年,数字人行业的主线一直是做一张更像的脸。
一批公司主打预先生成的口播视频,你写好稿子,它生成一个数字人替你念。
国内大量的直播带货,政务客服数字人,本质上也是同一套逻辑。
套路一样。
形象逼真,口型对得上,就算及格。
这条路线解决的是播的问题,不是聊的问题。
一旦进入实时 AI对话,级联架构的天花板就暴露无遗。
脸做得再精细,那一两秒的迟滞和不合时宜的微笑,都会瞬间把人拉出来。
它把赛道的核心指标,从像不像,换成了懂不懂。
标准变了。
它真正的卖点不是某一帧画面有多高清。
而是什么时候点头,什么时候插话,什么时候闭嘴。
这是一个对话建模问题,不是图形渲染问题。
这对整个行业是一次不小的路线拷问。
谁也躲不开。
如果端到端的全双工模型被证明是对的,那些靠四五个模块拼起来的产品,护城河会迅速变浅。
不过,在为图灵测试被攻破欢呼之前,有必要给这个 48% 泼一点冷水。
先别急着庆祝。
它通过的算不上严格意义上的图灵测试。
经典测试里,裁判明知对面可能是机器,需要在人和机器之间做判断。
而这次实验里,参与者被告知自己会和另一位参与者视频通话。
直到问卷最后,他们才被问到是否想过对方可能不是真人。
先告诉一个人对面是人,他最自然的答案当然是人。
换个角度看,在这样的心理暗示下,仍有 52% 的人判断出对面是 AI,这个数字本身就耐人寻味。
反过来才吓人。
另外,这次测试样本量很小。
小到不够看。
54 个人,按 48% 粗略估算,统计误差范围大约在正负 13 个百分点,真实比例可能低到三成多。
测试只有一分钟,话题是今年有什么期待这类轻松寒暄,并没有涉及需要深度理解或持续追问的场景。
用这样一个小样本,得出首个通过视频图灵测试的结论,难免有以偏概全的嫌疑。
社区里也已经有人标注,这一结果未经独立验证,也没有遵循标准测试协议。
数据里还藏着一个细节。
超过一半的参与者表示,通话中压根没想过对方可能是 AI。
而那些起了疑心的人,大多在前 20 秒内就察觉了。
它能骗过没有防备的人,面对有警觉的人,露馅得很快。
即便在那个第三方基准上,差距也依然存在。
生成上已经逼近人类,感知上跟人类参考值仍差了 0.47 分。
看懂对方这件事,远比演得像更难。
普通用户目前还用不上它。
有记者尝试体验,结果并不理想,后来才发现轻量版根本没对客户开放,只提供给少数测试者。
暂时摸不到。
但所有这些疑虑,都无法抹掉一个事实。
从 2.4% 到 48%,不管实验设计有多少瑕疵,同一家公司在同一套测试方法下做出 20 倍的提升,这本身就说明端到端带来的是一次质变。
至于安全,这家公司自己也承认,让模型成为强大交互界面的那些特性,同样可以被用来让人误以为对面不是 AI。
这也是它迟迟不公开发布的原因。
公司表示正在开发主动披露身份的功能,还跟 AI 安全组织合作。
考虑到今年年初就有黑客利用深度伪造视频,在视频会议里冒充熟人实施诈骗,这份谨慎并非多余。
回到那段发布视频的结尾。
负责人说,跟机器说话和跟人说话之间那条线,正在变得越来越薄。
当那条线薄到肉眼看不见,我们要重新学会的,或许不是如何分辨 AI。
而是如何在一个分辨不出的世界里,决定该信任谁。
对我们这些天天离不开 AI工具 的人,这个问题来得比想象中快。
