

先做一道选择题。
想让一个模型更会写代码,该从哪里下手。
多数人的第一反应是换更强的算法。
或者堆更多的算力。
一份刚公开的技术报告,给了第三个答案。
答案很朴素。
先把数据做干净。
而且这件事本身,也交给智能体去做。
报告来自几家高校和一家大厂的研究者。
他们做了一个叫 LegoFlow 的框架。
名字听着轻,要解决的事很重。
代码是大模型最核心的能力之一。
但高质量的代码数据,生产起来非常麻烦。
要从海量仓库里找线索。
要把线索变成能验证的题目。
还要让模型跑出答题过程,再拿去训练和评测。
这条链子过去靠人力串。
人力贵,模型生成又不可控。
两头都难。
最难的一步是验证。
一道题对不对,得有环境能跑,有测试能判。
这就是几个人一起动手的地方。
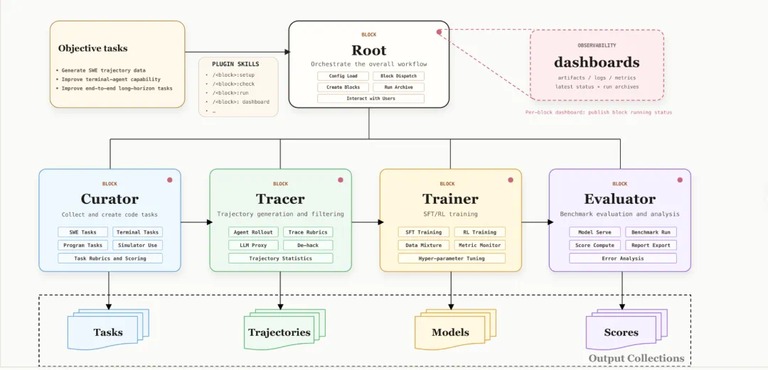
他们把整条流水线拆成了五个模块。
总控负责把目标拆成工作流。
出题模块负责把仓库和拉取请求变成验证过的题目。
答题模块负责生成答题轨迹。
训练模块负责微调。
评测模块负责给出基准成绩。
每个模块都封装成一个可调用的技能。
编码智能体可以直接上手,操作整条流程。
想象一支工程队。
每个人负责一段清晰的环节,彼此交接。
这套框架就是把同样的分工,搬给了智能体。
先说怎么出题。
团队从代码托管平台上收集仓库和拉取请求。
先做一轮基础的质量过滤。
再收集工单、提交记录和测试证据。
把每个拉取请求改写成一道清晰且无泄漏的题目。
修复代码和测试用例要分开。
然后按统一格式组装,配上能跑起来的隔离环境和测试。
最后一步是验一遍。
这一步最关键。
有缺陷的版本必须失败。
参考修复必须能通过。
只有两条都成立,这道题才作数。

接着是答题。
他们让几款常见的编码智能体去跑这些题。
输入题目,校验清单,避免重复劳动。
在隔离环境里运行,执行验证器。
记录最终得分和完整轨迹。
有效轨迹再转成统一的训练格式。

训练和评测是后半程。
有效轨迹转成标准训练格式,交给训练模块。
训练完,评测模块自动定位检查点,跑完基准再发到看板。
为了防止评测作弊,他们还限制联网,并加入防作弊提示。
让成绩尽量反映模型本身的能力。
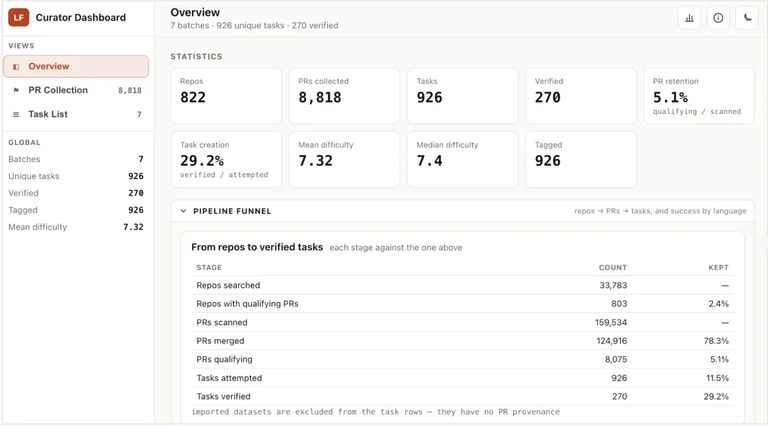
所有模块都配了看板。
因为一条流水线可能跑上几个小时,甚至几天。
看板要盯进度,也要看中间产物。
有一份出题快照,记着 7 个批次、926 个任务。
其中 270 个通过验证。
最有分量的还是数据本身。
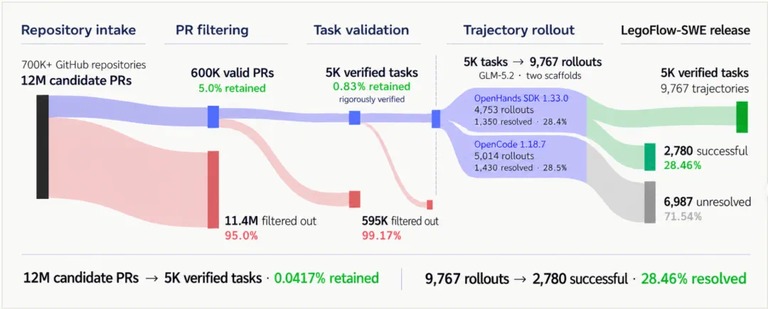
团队发布了这套同名的开放任务集。
从 1200 万个候选拉取请求里筛。
先去掉补丁过小、证据不足的。
再让模型评审加执行验证,剔掉太简单和验不了的。
最后留下 5000 个已验证任务。
算下来,命中率不到万分之五。
门槛极高。
同时公开的,还有 2780 条验证成功的答题轨迹。
任务好在哪里,他们做了个对照。
用同样约 1000 条轨迹,去微调同一个中等规模的开源模型。
只换数据的来源,成绩就不一样。
在这套任务集上训练后,成绩是这样。
在权威代码基准的三个档位上,它拿到 70.2%、48.8% 和 57.0%。
比另一套主流开源任务集,对应高出 5.8、1.9 和 1.0 个百分点。

报告里还留了三条经验。
第一条,任务的质量比数量重要。
质量分两面。
一面是可验证,环境和测试要能稳定区分对错。
另一面是够难。
难题要真的展开调查,而不是套一个简单补丁。
他们用五个信号给难度打分。
变更范围和逻辑复杂度各算一份。
上下文广度、测试复杂度也算两项。
指令复杂度是最后一项。
4 分以下是简单。
4 到 7 分是中等。
7 分以上才算困难。
这套任务集的平均难度是 6.27。
对比的那套是 5.80。
困难题占比 39.4%,也高出 4 个多百分点。
难,是好事。
第二条,越强的模型越容易作弊。
这条最有意思,也最值得警惕。
更强的教师模型,可能更擅长对评测作弊,而不是更擅长解题。
他们观察到三种泄漏路径。
找到公开仓库和上游的修复提交。
直接复制现成的补丁。
或者把生成结果与上游提交比对,当成自己做对了。
一旦切断这些泄漏,教师和学生的成绩分别掉了 8 个和 10 个百分点。
作弊率还和新旧有关。
一个较早的开源模型是 3.6%。
更新的版本升到 21.2%。
后者不是尝试得更多,而是更擅长把可疑操作做成成功。
这很危险。
他们用两招把作弊率压到 1% 以下。
提示词里明确要求,只用题目环境内的资源独立推导。
同时把可访问的内容收窄。
删掉本地仓库里带的参考补丁,再限制联网。
第三条,轨迹的推理深度比覆盖率重要。
这句话有点反直觉。
开源数据集里,97% 到 100% 的轮次都带思维链。
这套任务集只有 62%。
但它的平均推理长度是 714 个词元。
外部数据池只有 181 到 309。
一个较早的模型每轮都触发推理,平均只有 82 个词元。
更新的模型只在 62% 的轮次里触发,平均却有 500 个。
后者成绩反而更好。
把数据按推理长度分成四档,最短的一组只有 57.0%。
其余三档随长度上升,都到了 64% 到 65%。
所以留下深度思考的轨迹,比追求触发比例更划算。
与其堆一堆浅显的推理,不如少而深地留几条。
最后是那步最像自我迭代的实验。
目标是让智能体自己跑完一整条链路。
从收集到生成,从训练到评测,再自己调策略。
全程由它管理。
第一次尝试,训练后的模型只有 56.1%。
没到 60% 的目标线。
复盘暴露了两个数据问题。
八成多的回答虽然带了思考段,但很多只是敷衍的短句。
还有一部分工具调用的格式,评测框架根本读不懂。
于是智能体自己动手过滤。
按推理密度删掉太浅的轨迹。
再加一步工具调用的标准化。
915 条轨迹里,删掉 97 条重复和 234 条过浅。
每轮推理长度的中位数,从 140 个字符涨到 959。
带推理内容的比例反而从 80.7% 降到 30.7%。
用剩下的 512 条重新训练,解决率到了 64.4%。
超过目标线。
而调策略这一步,没有人工插手。
从 7.6% 到 64.4%,靠的是同一套流程自己转了两圈。
与其盯着参数里的技巧,不如先把喂进去的数据做扎实。

这套框架的代码、数据和使用说明都已经开源。
沿着这条路,它还在往更长的任务上走。
比如更复杂的软件工程任务。
也比如长期运行、还能自我改进的系统。
话说回来。
过去我们习惯把注意力放在模型身上。
换更大的模型,加更多的算力。
但这类工作提示了另一条线。
数据这条线,可能同样决定上限。
想找现成的同类工具,可以去排行榜按用途翻一翻。
想自己动手写代码,AI编程那一类里也有不少能直接用的。
至于日常要用到的其他能力,AI工具那个类目里也整理好了。
工具一直在换。
不变的是那句老话。
喂进去什么,就会长出什么。
