

停更七个半月之后,Gemini 的旗舰模型终于更新了。
多个官方账号同步放出了消息。
新一代模型叫 Gemini 4 Argon。
一、名字先变了
这个名字不太像它家以前的取名习惯。
官方没有解释来由。
只说沿用了测试期间的内部代号。
从字面看,它指的是第 18 号元素氩。
一种惰性气体。
刚好和浏览器那家公司的元素名形成一点对仗。
先别急着去应用里试用。
延续最近流行的安全叙事,这一版只对少量网络安全合作伙伴开放。
官方没有给出全面公开的日期。
只说届时先向付费接口用户和最高档订阅者开放。
普通订阅用户还得再等一段时间。
测试期间流出过疑似这一版的模型。
官方从未认领。
也没人知道里面有没有掺别家的影子。
那些对比结果其实不太可信。
所以这里只列官方自己放出的数据。
从官方跑分看,这一代强得有点夸张。

二、跑分很猛,编程偏科
列出来的 18 项测试里,有 13 项是领先的。
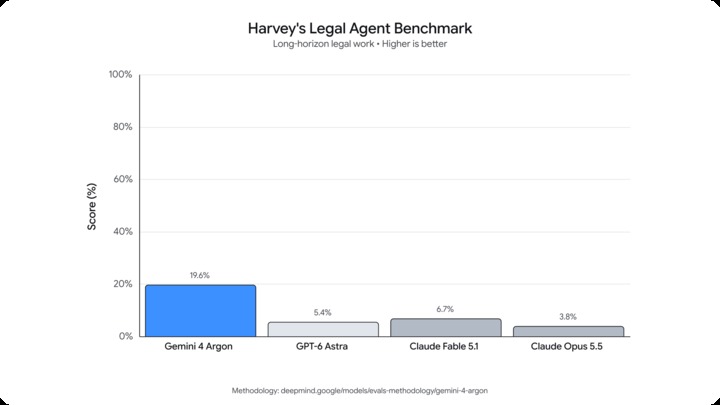
领先最大的地方在知识工作。
涉及真实金融分析和真实律师工作的两项测试,差距能拉到两档。
这一点倒不让人意外。
毕竟在最拉胯的时候,也没人怀疑过它的世界知识能力。
另一个传统优势是长上下文。
在考验 256k 到 1M 超长上下文的测试里,它同样领先其他旗舰模型超过一成。
有个新特性可以解释这种领先。
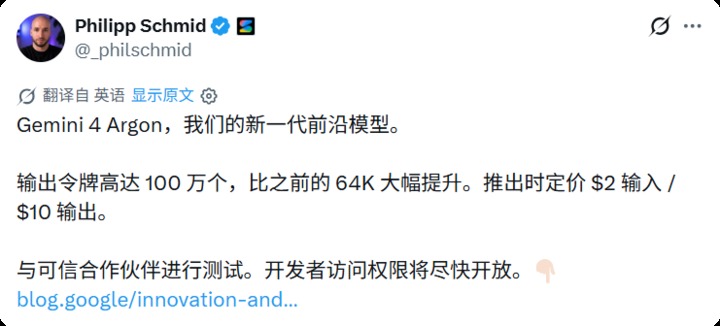
输出的上限从上一代的 6.4 万词元拉到了一百万词元。
只要钱包扛得住,它能一口气吐出几十万字。
对思维链构建来说,这话算不上夸张。
官方的说法是,模型有足够空间深入思考时,推理会获得新的深度。
相比之下,AI编程 这一块就有点起伏了。
在最常用的长周期软件构建测试上,它拿到 77.9%。
这个成绩领先 GPT-6 Astra 和 Claude Opus 5.5 接近四个百分点。
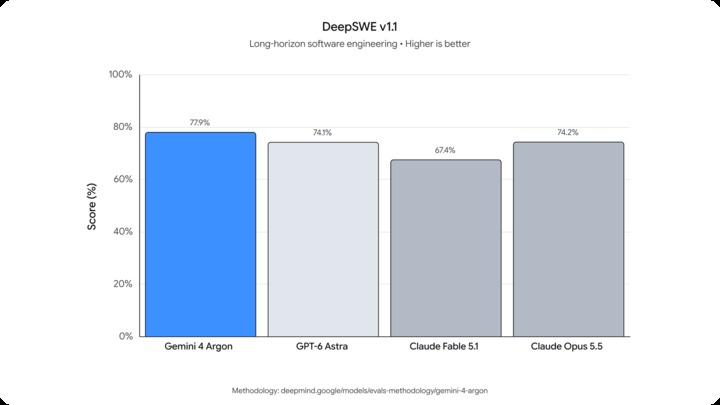
但在从零构建项目的测试和操作 Linux 终端的测试上,它是垫底的。
大体可以这样总结它的特性。
知识和写作强于编程。
编程强于终端。
第三方盲评也能佐证这种判断。
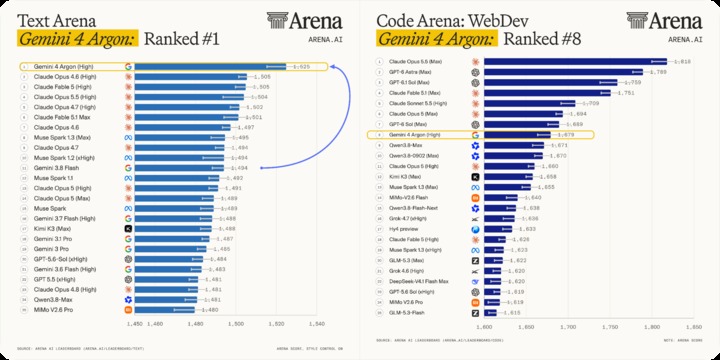
文本类 排行榜 里,它排到了第一。
换到更看工程能力的组别,它只到第 8。
一个编程能力落后的前沿模型,某种程度上算是时代之幸。
过度优化编程能力,让不少模型开始不说人话。
有的疯狂分行。
有的满口黑话。
这时候,一个因为编程一般而保留文字审美的模型,反而能解决很多写作上的问题。
与其说它在追跑分,不如说它把力气花在了写作上。
另一个变化是幻觉率降得厉害。
三、价格是它最狠的一刀
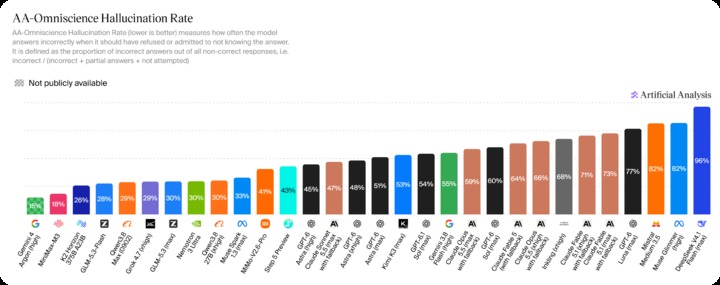
在独立评测机构的测试里,它的幻觉率只有 15%,是所有前沿模型里最低的。
面对不确定的问题,它更愿意说不知道。
而不是硬编一个答案。
宁可要一个会说不知道的模型,也不要一个满嘴肯定的模型。
对普通用户来说,最要紧的还是定价。
这家公司在这件事上一向大方。
官方接口的价格是每百万词元输入 2 美元,输出 10 美元。
命中缓存的价格是前者的 5%。
公告说首发优惠期结束后会翻倍。
但按经验,下一代出来之前优惠期大概率不会结束。
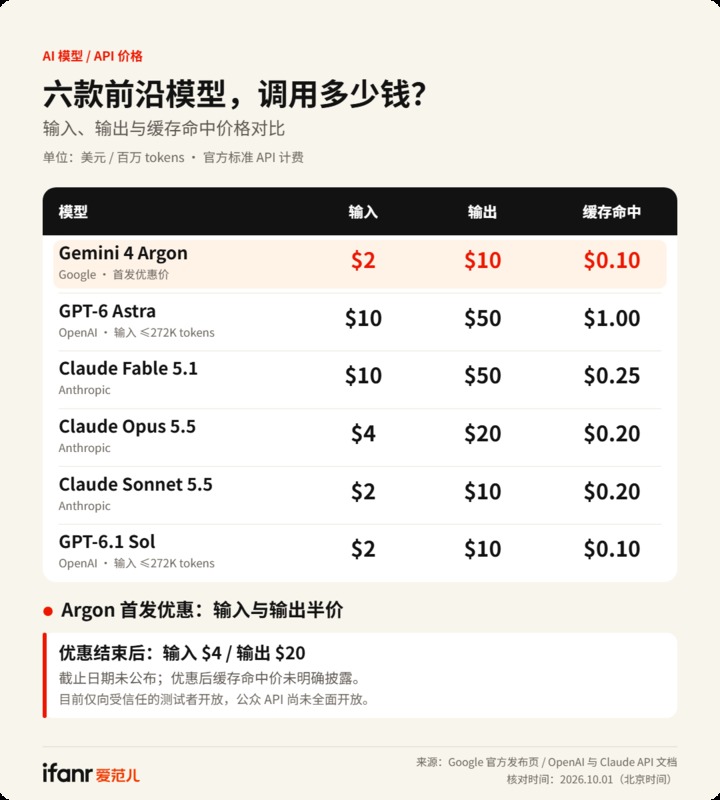
按优惠价算,它的价格只有同级旗舰的五分之一。
大致持平另外两家的中杯型号。
换句话说,只要能力没有虚标,它就是当下智价比最高的一款。
用中端的价格,能买到旗舰的智能。
这次发布也终结了一个尴尬的记录。
过去近半年,最高档订阅的权益描述是可以用上一代的旗舰模型。
可后来连轻量版都能暴打旗舰版。
这个套餐就显得相当幽默。
很多人买它,其实只是冲着那 5T 的网盘。
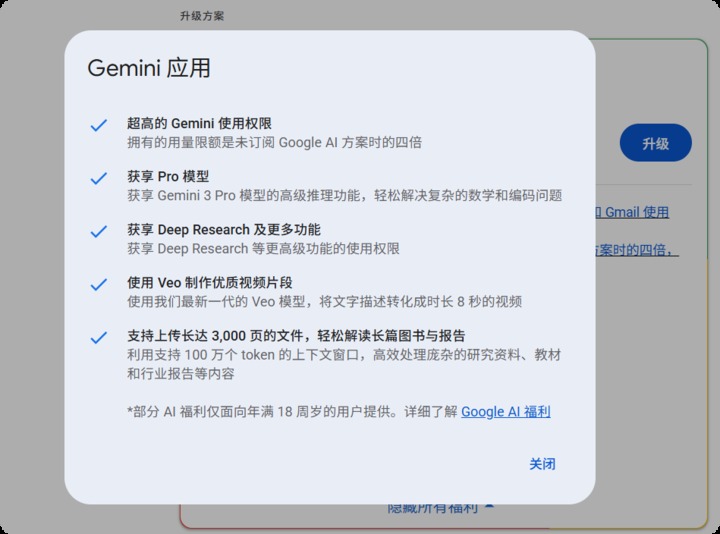
至少现在,这家公司终于可以光明正大地宣传自己的会员了。
四、题外话:白月光和现实
写到这里,我想说几句题外话。
每个人心里都有自己的白月光。
我在 AI 领域的白月光,是去年年初的那版高配模型。
它的文字能力当时确实惊为天人。
也是从那之后,我才正式把 AI工具 装进了自己的工作流。
后来看见下一代发布,我第一时间转发到朋友圈。
从这个意义上说,没人比我更希望这一代能支棱起来。
但还是得尊重客观规律。
很多人评论过,大模型归根结底是一种制造业。
就像手机和芯片那样的制造业。
一个长期没有更新的模型突然力压群雄,不太现实。
这跟一个停在 10nm 的芯片厂突然拿出 2nm 一样。
上一代轻量版的跑分和实测落差,也说明厂商可能做过刷榜的特殊优化。
同理,这一代在多数基准上达到顶尖水平也很可疑。
几乎就在它公布的同时,彭博社发了一篇报道。
报道称内部员工对实际性能持怀疑态度。
被引用的知情人士说,它在真实任务里难以处理某些编码任务。
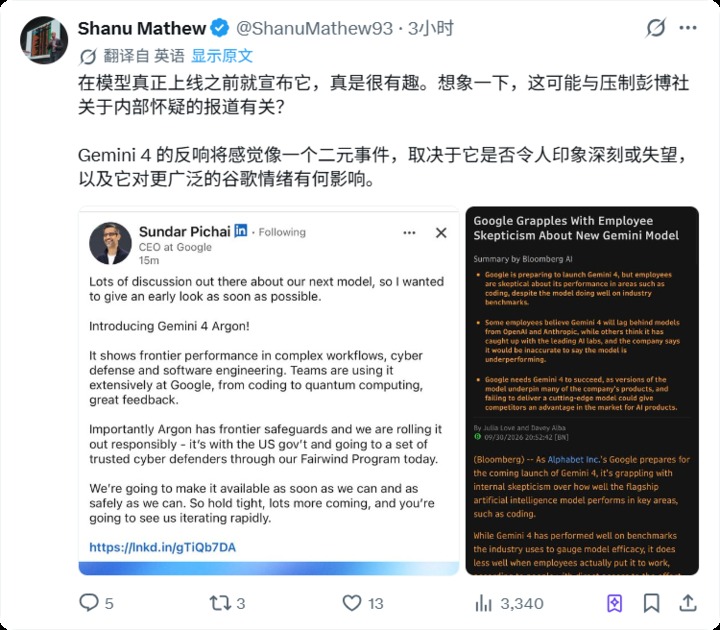
官方很快做了反驳。
也有员工表示它其实很不错。
但我们大概可以相信,真正到手的表现不会像跑分那么强。
何况等它实装的这段时间,对手又够迭代一个版本了。
往好的方面想,它的发布毕竟代表这家公司回到了赛场上。
上限未必很高,下限还是能保证。
接下来要做的事,就是用制造业的办法,一步一步地赶上来。
Gemini会员中转站 微信:douhanq
