

对手的年度开发者大会定在美西时间 9 月 29 日。就在开幕前一天夜里,一家美国公司把新一代中杯模型放了出来。
命名沿用上一代的规矩,叫 Claude Sonnet 5.5。官方给它的活是当主力打工人。要快,要省钱,日常那些活儿还得顶得住。
比起上一代,它跑得快了三成。做完同一件事的开销,最高也降三成。标价只有自家大杯的一半,性能却基本追平。
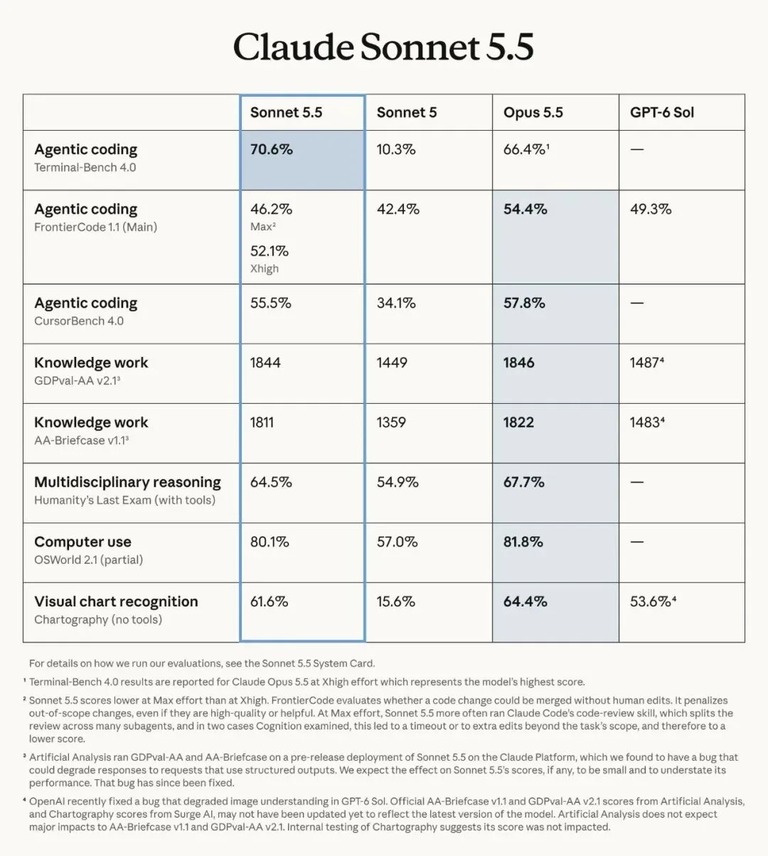
更反常的是智能体编程测试。上一代在这一科排末尾。这一代直接冲到自家第一。得分 70.6%,差不多是原来的七倍,比大杯的 66.4% 还高。
上线没多久,一家第三方评测机构把智能指数榜重排了一遍。前三名全被这家公司包圆。这款中杯排在第二,前头只有自家更大的一款。
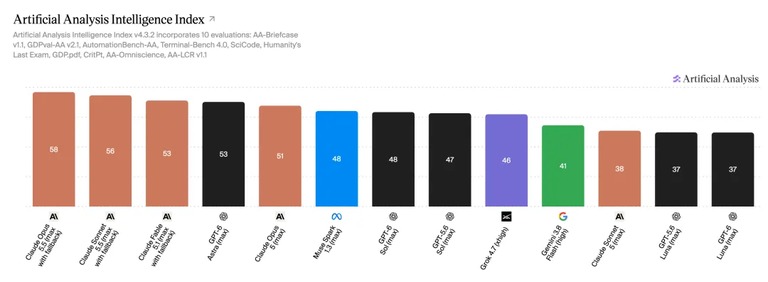
排第三的那款,四周前才刚发布。它的标价是这款中杯的五倍。一个月工夫,大杯级别的能力就按中杯的价卖了。
官方还给开发者留了个旋钮。档位调低,答得飞快,耗的词元极少。档位调高,模型会反复检查自己的活儿。日常任务和硬骨头,两套调法。
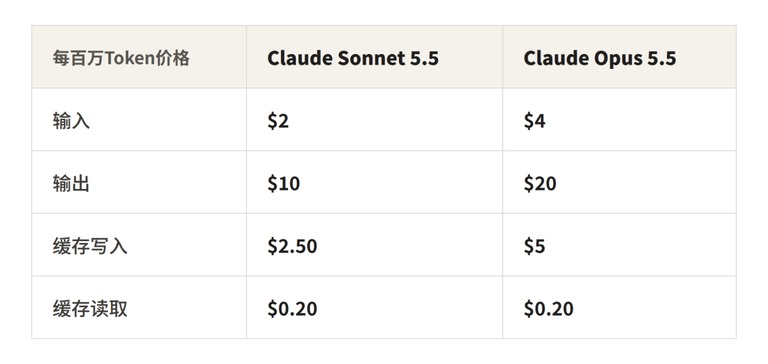
定价表面上没动。每一百万输入词元 2 美元,输出 10 美元,缓存读取 0.2 美元。
套路藏在效率里。
模型变聪明以后,同一件事要的词元大幅缩水。每个任务的实际开销最多降三成。用更少的词元办更大的事。
下面这两张,是同一个指令下两代模型的产出对比。
半价的中杯,把自家大杯反超了
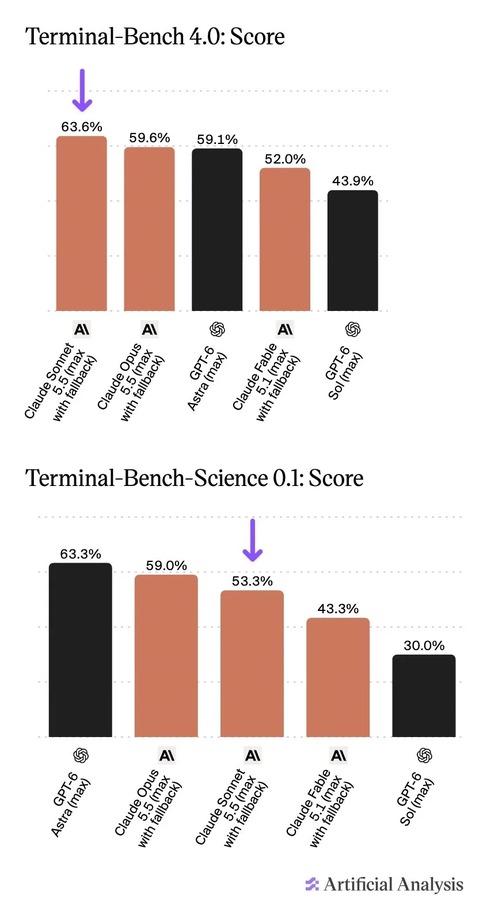
先看编码。第三方榜单上,这款中杯拿到 64%,高于自家大杯的 60%。对手家新模型的分数也是 60%。
在终端环境里的编程测试上,它拿 53%,排到第三。只输给对手的新模型和自家大杯。日常 AI编程 的活儿,多半就落在这一档。
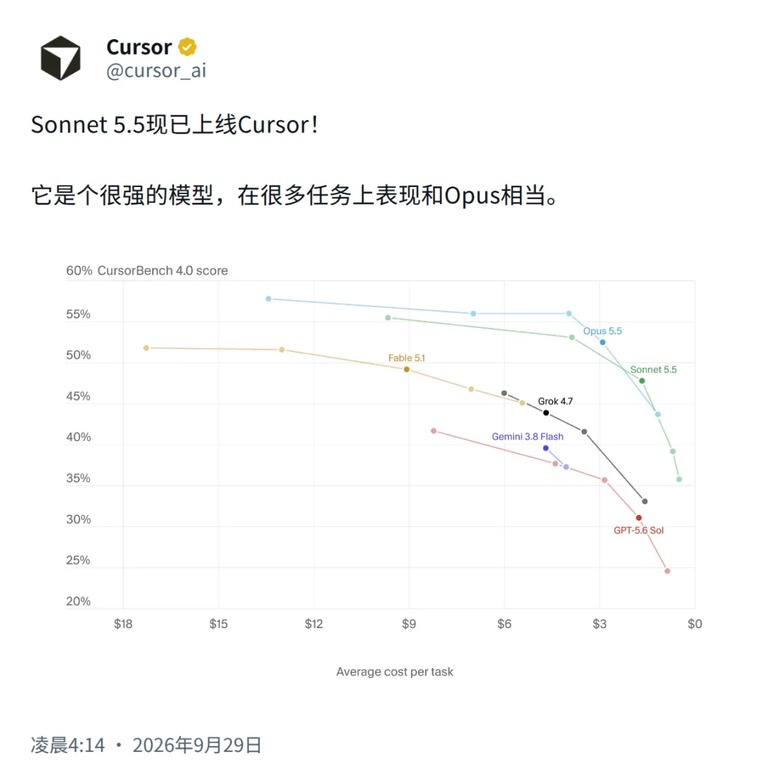
写代码的另外两项,它同样咬得很紧。一项最高拿到 52.1%,压过了对手的新模型。另一项模拟真实编程会话的测试,它拿到 55.5%,只比大杯低两个多点。上一代这项只有 34.1%。
有一家编辑器厂商当天就宣布接入。他们放出的测试分数是 55%。早期内测的人说得更直白。它读懂庞大代码库的速度快得吓人。
办公能力也追上了。一个测 44 种职业交付能力的榜上,它拿 1844 分。大杯是 1846 分,差两分。
考长程知识工作的另一项,它拿 1811 分。大杯是 1822 分,几乎打平。对手的新模型在这项低了三百多分。
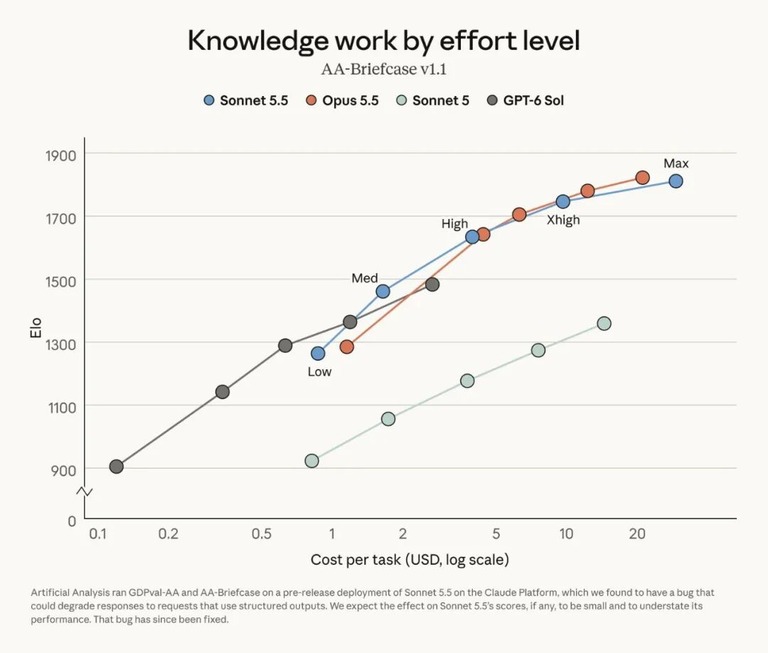
最让人意外的是审美。
这一代主动懂设计了。它能自己美化界面,也能照着幻灯片模板出稿。成品几乎不用人再改。
官方内部有个案例。测试人员把一家上市公司的季度财报、电话会议记录和一个模板一起丢进去,要求出一份十页的运营审查稿。初稿被两位人类专家判为可以直接发送。
在带工具的综合考试里,它拿 64.5%,比上一代高了将近十个百分点。另一个榜单上,它首次上榜就排到第二,只比自家大杯低 0.47 分。
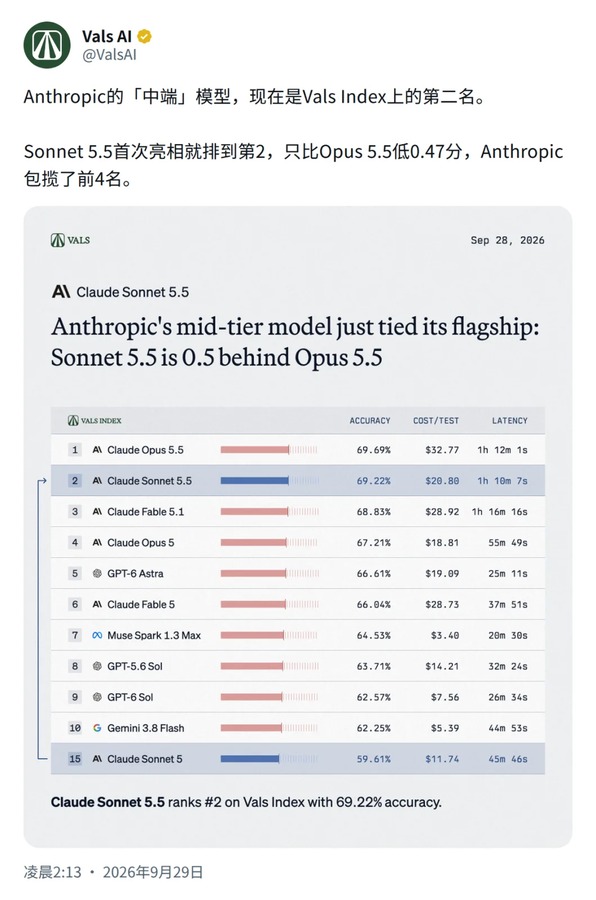
四周前那款大杯发布时,还是全球最强的编程与知识工作模型。现在,这款中杯在两三个科目上已经反超。
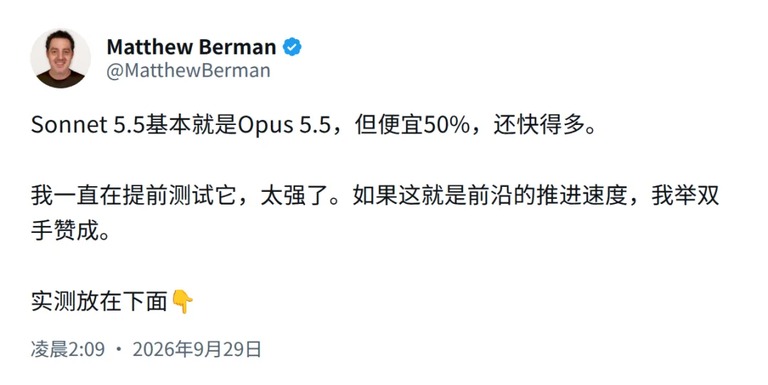
有位科技博主当天发了条动态。他说这家公司正在疯狂上菜。
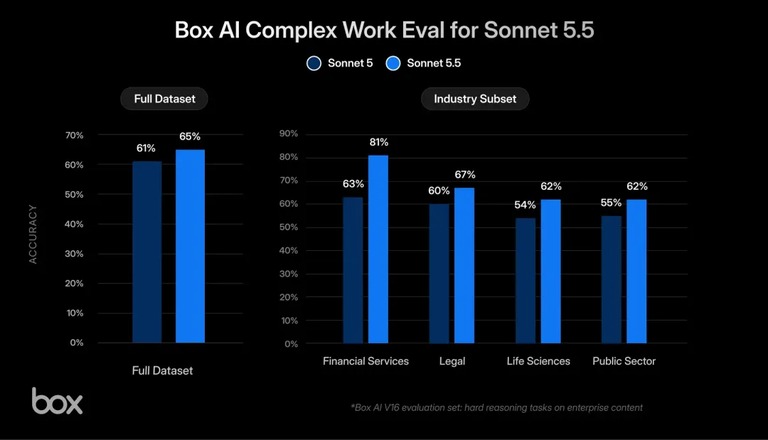
还有个办公复杂任务测试。它的整体准确率到了 65%,上一代是 61%。交付速度快了约 2.4 倍,词元消耗还降了一成二。
速度与准头在智能体任务里通常互相拉扯。能同时兼顾,算是实打实的进步。
它搭出的旧金山,着火会自己派消防车
测试里更直观的是这类活儿。
一位拿到提前测试资格的博主,发布当天放出一长串实测。他让模型在游戏引擎里现场搭了一座旧金山。街上车流不断,还有骑自行车的人穿过路口。
输入一句那座金字塔起火,系统立刻把火情评到 4.6 级,满分 10 级。随后它自主派出五辆消防车和三辆警车。远处大楼冒起黑烟,警车闪着灯赶到路口,当场拉起警戒线。
水下场景也顺手。帆船先在暴风雨里颠簸,天色从黄昏切到夜里。镜头往下一沉潜进水里,成群的鱼从头顶游过。
还有能直接上手玩的闯关游戏。六十个角色挤在同一张地图上。有一关踩过的地砖会立刻塌掉。还有一关要顶着滚下来的石头冲上山顶抢皇冠。
连星舰都被做成了可交互的爆炸图。整艘飞船一层层拆开,一直拆到底部的发动机。
他还让模型生成了一款在线积木游戏。
不过也有人不买账。
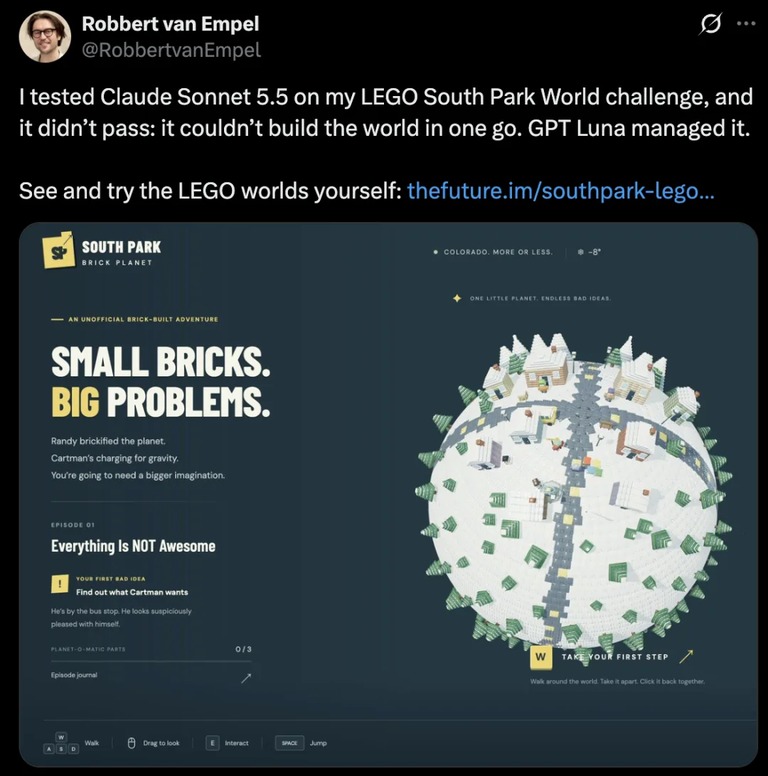
一位开发者维护着一个积木星球挑战。他要求做一个带剧情的可互动三维世界。结论是这款中杯没能一次搭出整个世界,对手家的另一款做到了。
另一位博主则感慨,三维模拟这块已经被拿下。
快也是它的卖点。
同一个题目,让两代模型并排写一段鸟群模拟代码。这一代写完代码时鸟群已经飞了九秒。上一代还在一行行往外蹦代码。
只看截图,就通关了困住前任一年多的游戏
游戏这一项,它破了一个放了很久的纪录。
它成了第一个只看游戏截图、就通关初代宝可梦的中杯模型。这家公司为了这一关,已经折腾一年半。
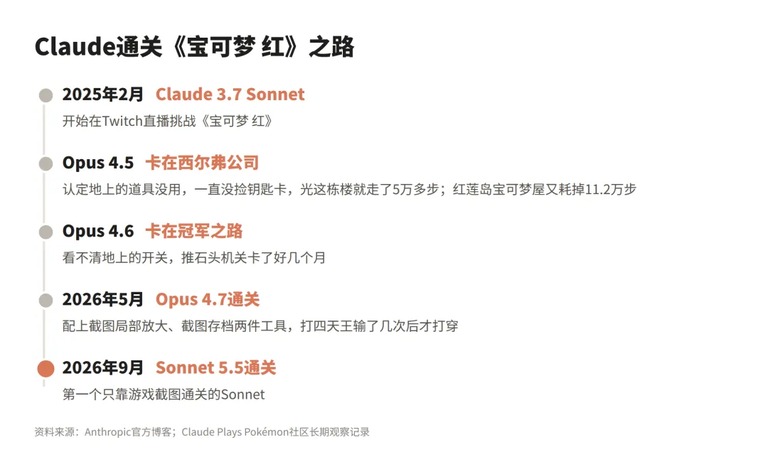
关键变化是它长出了眼睛。
在一项强读复杂图表的测试里,它从上一代的 15.6% 涨到 61.6%,翻了近四倍。在看着截图操作电脑的那项测试里,它涨到 80.1%。自家大杯是 81.8%,只差 1.7 个点。
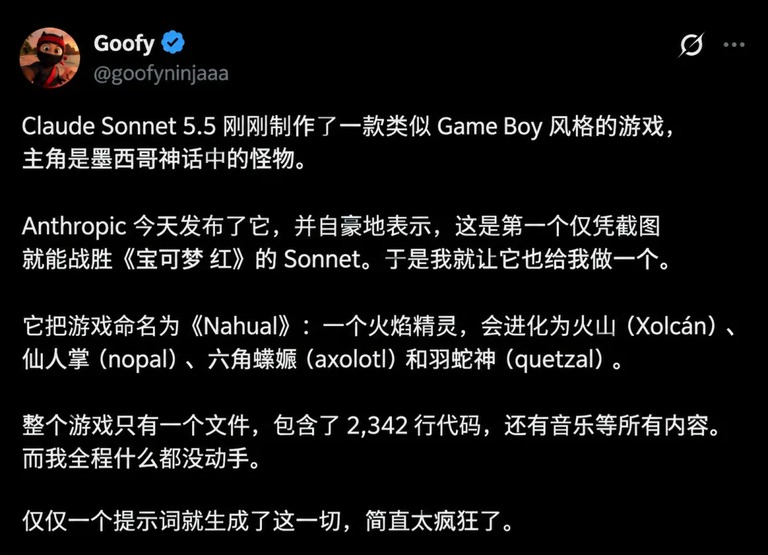
有位网友当场让它给自己做了一款游戏。
成品是一款墨西哥怪物风格的掌机游戏。剧本,角色,音乐,全都齐了。单文件 2342 行代码。一个提示词就长出了一个新游戏。
档位开到最高,反而更贵
便宜有个前提。你能省多少钱,全看把努力档开到哪一格。
低档和中档下,它常常能打赢上一代的满档。开销只有十分之一。
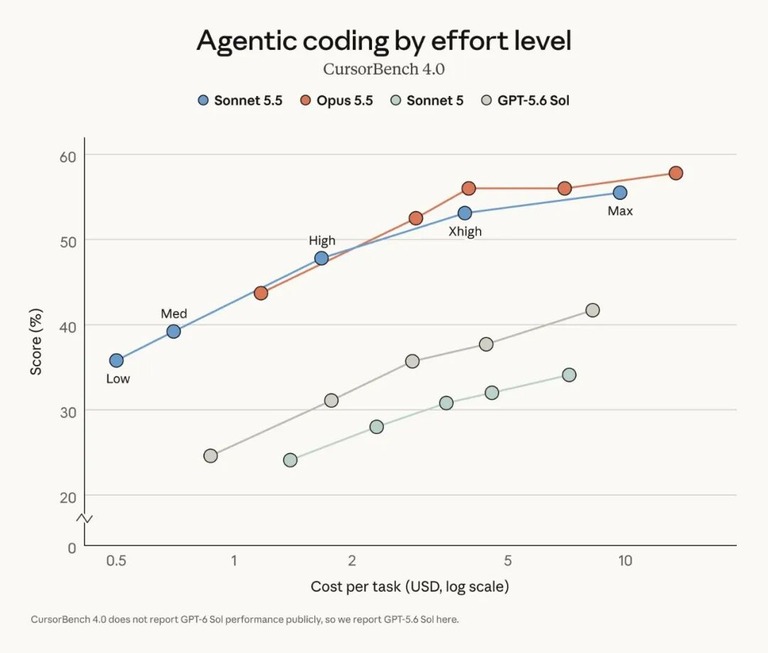
但把档位推到最高,情况就变了。
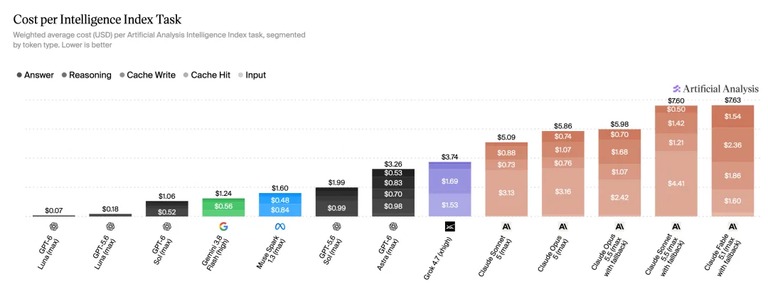
最高档下,它每做一道题平均要吐出 19.3 万个输出词元。这是那家评测机构测过的历史最高纪录。比自家大杯多吐六成,大约是附近几家的七倍。
所以哪怕单价减半,满档跑一个任务也要花 7.60 美元。这比上一代贵了五成,比自家大杯的 5.98 美元还贵,直接逼近更大一款的 7.63 美元。
满档甚至还会帮倒忙。
在一项代码合并测试里,它开最高档只拿到 46.2%,反而比低一档的 52.1% 更低。原因是满档状态下它太爱调用审查工具,把活儿包给一大群子智能体。结果要么跑超时,要么手伸到任务范围之外的代码上,直接被扣分。
所以真要省钱,修缺陷、写文档这种日常活,开中档或高档最划算。复杂的长任务,交给大杯的高档更稳妥。
宁可多花两分钟挑一挑档位,也别让账单悄悄翻倍。
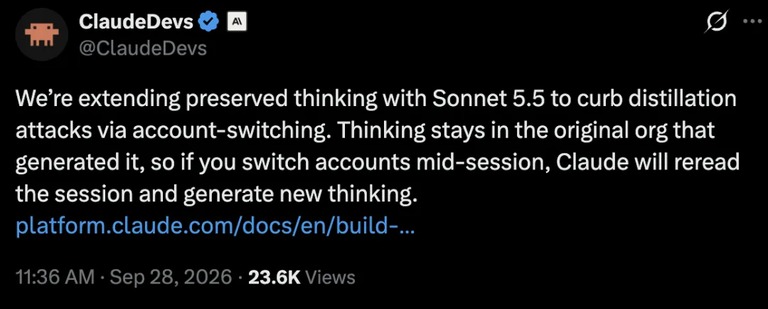
护城河也顺带升级了。这一代加了防蒸馏机制。
官方原话是,它是首款搭载安全分类器、以防推理被提取的型号。这意味着模型脑子里的思考过程无法与账户解绑,换个账号接着聊也不作数。
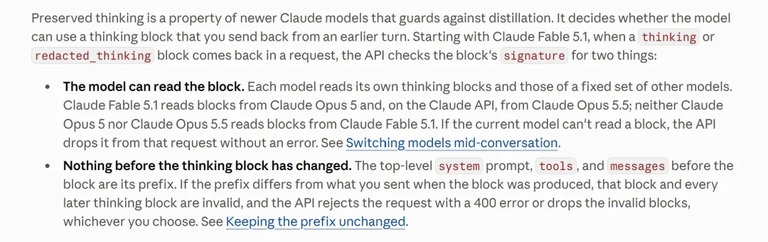
对正经开发者来说,日常使用感觉不到变化。想白拿核心能力的那条路,则被堵住了。
它的网安能力也一并升了级,成了第一款配齐同级别防护与回退机制的型号。碰到高风险网安任务,系统会自动退回上一代。在生物学领域,它同样会拦下高风险请求。
压力现在给到了对手那边。
9 月 22 日,这家公司发大杯,九十分钟后对手连发两款新模型,双方直接硬刚。六天后,中杯落地,标价与对手的一款完全相同,智能指数却压了一头。
对手的开发者大会就定在中杯发布的第二天。前沿能力的价格已经被拉到这份上,那边要拿什么接。
用 AI工具 的人未必追新,但价格的松动会一层层传下来。
这类 AI对话 场景的付费档位,也会跟着重排。
Claude Code会员中转站 微信:douhanq
