

一座算力中心的投产时间,有时要先看电网的时间表。
国际能源署在 2025 年的报告里警示过一件事。电网相关的风险如果不解决,约两成的规划项目可能面临延误。对已经花钱买好设备的公司来说,等接电就是等业务上线。
电接上了,麻烦还在机房里。高密度设备要更大的供电容量。计算任务带来的功率需求变化很快。产生的热量也必须及时排走。
三个环节里任何一个卡住,新买的硬件都发挥不了作用。
算力扩张就这样把一个老问题推到台前。怎么把能拿到的电,持续稳定地变成有效算力。
巨头们的动作已经开始了。英伟达、谷歌和一家能源公司在上个月共同成立了一个能源管理联盟,想让数据中心跟着电网的运行状态调整用电。
一天之后,华为在全联接大会同期的一场算力基础设施峰会上,介绍了自己那套源网荷储方案,以及供电、储能和液冷上的新进展。

这些动作覆盖了从电网到芯片的整条链路,回答的是同一个问题。能源和算力要怎么一起设计。
算力要扩张,先让电力跟得上
AI 对电的需求涨得很快。
国际能源署在 2026 年的报告里预计,全球数据中心的用电量会从 2025 年的 4850 亿千瓦时,涨到 2030 年的 9500 亿千瓦时。不到十年,接近翻倍。其中面向 AI 的那部分,同期预计增加到约三倍。
但对一个具体项目来说,比全球总量更急的是另一件事。当地什么时候能给足电,这些电又能以什么质量持续供应。
服务器要采购。机房要施工。电网要扩建。新增电源还得另算。这几件事的时间表各不相同。设备到了交付期,配套的电力设施可能还在等审批。
两边衔接不好,投资回收和业务上线都得往后推。
所以能源得比算力更早进入规划。在风光资源富集的地区,把新能源项目和算力园区放在一起布局,能多出一些选择。
政策也在把能源条件写成硬要求。
去年 8 月,西班牙公布了一份数据中心监管的皇家法令草案。它对功率不低于 1 兆瓦的新接网数据中心提了更严的可再生能源门槛。每运行一小时,至少八成用电要由新增的可再生能源在同一小时覆盖。每新增 1 兆瓦的电力需求,就得配套 1 兆瓦的新增可再生装机,而且要在数据中心投运前 18 个月建成。
这条门槛有个细节很要紧。买存量绿电的证书,满足不了新增装机的要求。
草案还写了不遵守的后果。附加费。费率上调。持续违规甚至可能失去电网接入资格。
真正值得琢磨的是逐小时匹配这个提法。年度总量达标已经不够了。数据中心还得盯着自己每一个时段的电源结构。
中国这边也在推。
2026 年 4 月,四个部门联合印发了一份关于人工智能与能源双向赋能的行动方案,部署了 29 项重点任务。文件里明确鼓励算力设施配置构网型储能,也支持有灵活调节能力的算力设施做绿电直连。此前有关政策还提过,国家枢纽节点新建的数据中心,绿电占比要超过八成。
欧盟那边的路数是另一条。它先基于一部授权条例建立了信息披露框架。9 月 21 日又通过了统一的可持续性评级方案,首批标签预计 2027 年推出。最低能效标准也已进入立法准备。
各地的规则和实施阶段不一样,方向是一致的。能源结构、用能效率和运行数据,正在变成规划和运营里更具体的考量。
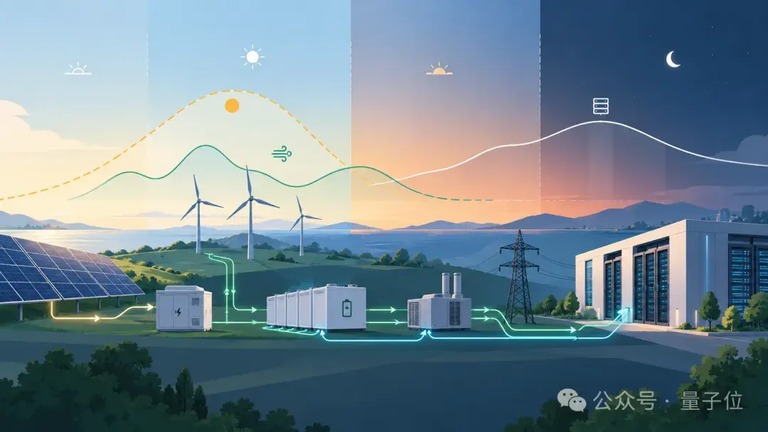
回到项目本身,就算新能源就在旁边,也得处理时间上的错配。光伏跟着日照走。风电出力有波动。计算任务却有自己固定的执行节奏。
一年买够了绿电,和每个小时都能拿到稳定的电,是两回事。
这中间要靠储能、支撑电源和电网一起配合。有的装置负责短时缓冲。有的承担更长时间的供需调节。
电要变成算力,先解决波动和密度
与此同时,算力中心自己的用电方式也在变。
大规模集群里,成千上万台设备会跟着任务推进,一起进入计算、通信或者等待阶段。功率同步起落时,供电系统挨的考验就不只是总容量够不够,还有扛不扛得住快速波动。
两座全年耗电量一样的数据中心,一座负载平稳,另一座频繁大幅起落,对供电控制和储能的要求完全不同。
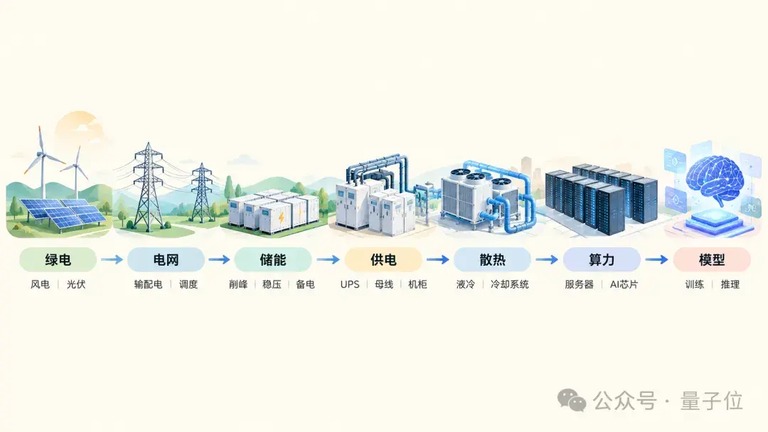
这正是源网荷储要放在一起考虑的原因。源是电源。网负责连接和输送。荷指服务器这类用电设备。储提供备电和调节能力。
四者协同,得同时算清三件事。上游能提供什么样的电。下游怎么用电。供需对不上时怎么缓冲。
算力负载本身也有可以挪动的空间。一次 AI视频 生成要跑多久,并不完全由用户说了算。
谷歌今年 3 月披露,它已经把合计 1 吉瓦的需求响应容量写进了和多家公用事业公司的长期合同,用限制或者转移部分机器学习任务的方式配合电网运行。
调节的前提是不影响业务。一部分计算任务可以跟着电力供应调整执行时间。
但能挪的有限。像一次 AI对话,响应时延上就有硬约束。训练任务有完成期限。能移多少负载,能维持多久,要拿设备利用率、电价和储能成本一起算。
机房内部还有另一重约束,密度。
同样的电压下,设备功率越高,电流越大。线缆、连接器和配电空间承受的压力也越大。提高供电电压是一条路。换成合适的直流架构,还能省掉部分电能转换环节。
800 伏直流就是这么被行业盯上的。
英伟达、谷歌和微软等厂商在一个开放计算项目里推这项标准,已经有 80 多家公司参与生态开发。
换句话说,这更像供电架构的一次分层演进。
不同代际的设备和机房会长期共存。供电系统必须给这段过渡留出余地。
让算电协同深入每一层设备
在这些厂商里,华为的布局算比较系统的。
今年 5 月,华为发布了源网荷储的算力基础设施战略,把重构方向概括成「3+1」。供电链路的瓦特。热管理的热。数字化运营的比特。再加一个建设模式。
到了 9 月的峰会,1.0 版本方案和一批产品进展,说明了这条路线怎么落到眼下的产业条件里。
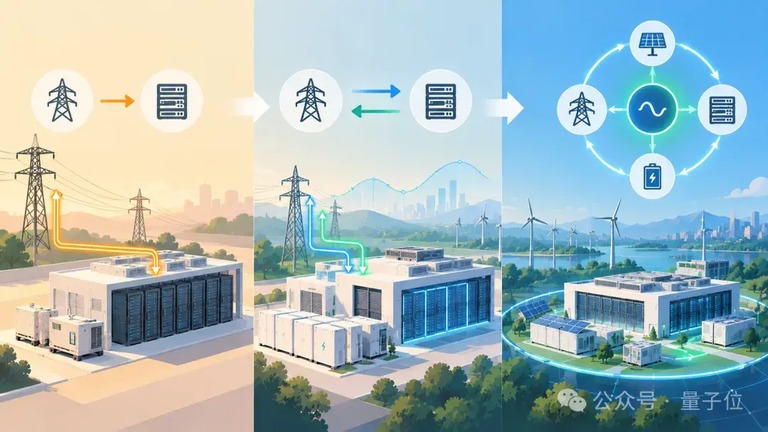
这套重构背后,是算力中心和电网的关系在变。
华为数字能源副总裁何波把它概括成三个阶段。先是适应电网。再是支撑电网。最后是主动构网。

第一阶段,算力中心主要是用电负荷。重点是配不间断电源、备用电源和电池系统,在电网异常时保住服务器。储能的价值主要体现在备电上。
第二阶段,储能从单一备电转向备电和调节并重。算力中心可以参与削峰填谷,也能做需量控制和短时波动平抑,还可以响应电网的需求。前面提到的那个 1 吉瓦需求响应,就是这个方向上的例子。
第三阶段,要靠构网型储能、能源路由器和微电网控制技术,增强电压和频率支撑能力,在配置和控制条件够的时候支持孤岛运行。
这不等于每座算力中心都要变成独立电站。但对高密度园区、绿电直供项目和电网偏弱的地区来说,这类能力有实际价值。
构网型和传统跟网型储能的差别就在这里。后者跟着电网走。前者能主动建立电压和频率的参考,为系统稳定提供支撑。
这种对电网角色的重新定义,先落在供电链路的重构上。华为管它叫瓦特重构。
面向眼下,1.0 方案的基础是电网友好型不间断电源、智能锂电和构网型储能三者协同。既保住供电连续性,也平滑 AI 负载的波动,同时增强对电网的支撑。
不同层级的设备干不同的活。不间断电源负责连续供电。智能锂电进一步参与负载平滑。园区层面的构网型储能面向电网支撑和多能源协同。
面向未来,华为提出了一个多输入多输出的供电目标架构。上游适应风电、光伏这些不同能源。下游兼容不同代际的计算设备。中间针对从微秒到小时级的变化做分级调节。
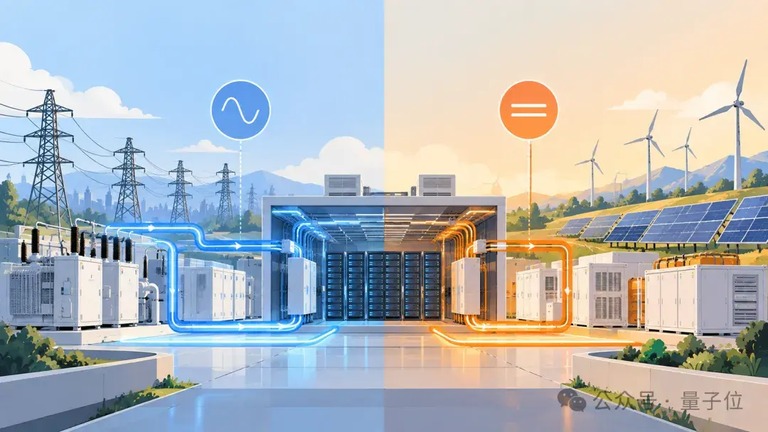
更远期的路线,是往以固态变压器为核心的融合构网型能源路由器演进。把电能变换、储能接入和构网控制进一步集成,减少供电链路里的转换环节。
这次公布的泰山不间断电源,单柜容量做到 1280 千伏安,双变换效率最高 98%。恒山直流电源则用一套硬件平台,支持 270 伏、400 伏和 800 伏等多种直流制式。
前者回应的是有限空间里的供电密度和效率。后者为不同计算架构的接入和后续升级留出选择。
多制式兼容这件事,工程价值不小。供电设施往往要用很多年,中间服务器会换好几代。既有机房、新建项目和不同代际的设备,条件各不相同。
华为在战略里写得很明确。交流和直流会在较长时间内共存。所以能适配多种制式本身就是价值。
储能产品也沿着这个方向走。华为介绍,新一代储能系统增强了储能密度、负载平滑和安全能力,并面向 800 伏高压直流架构演进。
再说热。华为把它叫热重构,管的是从芯片到户外的热管理,还有全生命周期的安全可靠。
这次介绍的 AI 液冷系统,以热管理单元作为控制核心。除了输送冷量,它还加了微小漏液检测、冷却介质健康预测和预测性维护这些能力。
这些变化对应的是液冷上规模之后的实际问题。系统要长期跑,就得持续掌握液体、管路和设备的状态,尽量在异常影响业务之前把风险找出来。散热效率和运行可靠性,得放进同一套系统里考虑。
据华为介绍,这个热管理单元还和自家的加速服务器做了原生适配,能通过冷电联动跟着计算负载响应。
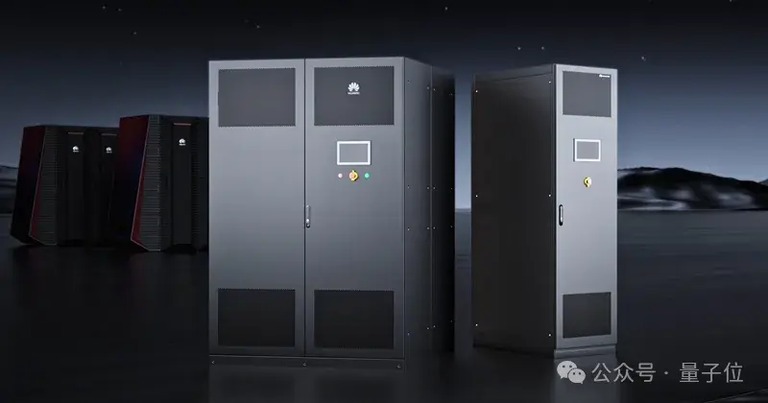
服务器要多大的功率,热量怎么变,这类信息可以更直接地进入冷却系统的控制过程。计算设备和热管理共享运行信息、协调响应,这就是联合设计。
硬件之外,数字化运营是提效的另一个抓手。华为叫它比特重构。
供电和热管理系统越复杂,运行信息能不能被持续观察,异常能不能被及时识别,就越影响运维效率。热管理单元的预测性维护是一种应用。华为想把这个思路延伸到整个设施生命周期,让 AI 反过来服务算力中心的运行。
最后是建设方式的重构。
设计性能能不能及时变成可用算力,取决于设备交付、现场施工和测试能不能接上。把更多集成和验证工作前移到工厂,能减少现场的串行施工和反复调试,让工厂生产和现场建设并行。
按华为公布的数据,新一代电力模块通过器件创新和产品化开发,占地减少 40%,交付时间从 7 天压到 3 天。5 月就亮过相的全链供电产品,单箱容量支持 3.2 兆瓦,一箱一路电,即插即用,可以放在室外。全链制冷产品用八箱一系统的方式,把制冷链路做成了标准化产品。
交付收益能从已有案例里看。
华为公开的商汤临港智算中心项目显示,面对 18 兆瓦的扩容需求,双方用电力模块和储能集装箱部署方案,靠工厂预制和室外部署,45 天完成了供配电系统交付。同类系统的传统交付周期约为 3 个月。
把设备放到楼顶,还释放了原本用来配电的楼内空间,给计算设备扩容腾出条件。
这类案例的意义在于,供配电系统的建设可以围绕业务投产时间来重新组织。
峰会现场还展示了一个三维数据中心。它借鉴芯片工厂把动力层和生产层分开的思路,把供冷和计算设备、供电和备电沿垂直方向分层安排,重新协调动力设施和计算设备的位置关系。
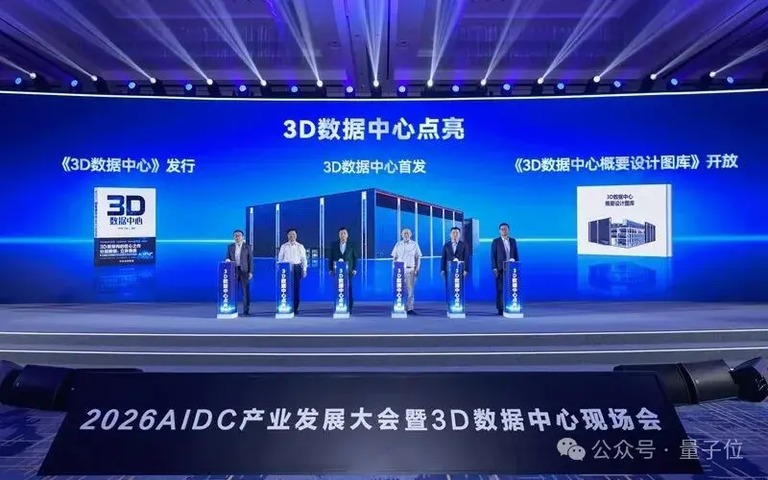
支撑这套重构的,是四类能力积累。数字技术。电力电子。热管理。储能管理。
何波在峰会上强调,华为的特别之处在于同时具备能源全链路和 AI 全栈能力。横向能从绿色能源出发,经电网和储能,一直延伸到供电、热管理和芯片。纵向从基础设施出发,经算力和模型,一路贯通到用户手里的 AI工具。
从运营者的视角,也能看到这种系统性考量。世纪互联创始人陈升在峰会上指出,AI 负载的高频跳变会给电网带来新挑战,增加脱网和宽频振荡失稳的风险。他提出重构外电层、园区层和楼宇层。目标是外电可互济,园区可调度,楼宇可直流化。
华为计算战略规划首席专家夏勤则从计算架构出发,认为算力中心正在向算网存一体化的协同架构演进,能源是基础设施的能力基座。
算力工厂的标尺,从能耗比换成每瓦特词元
技术架构在重构,衡量效率的标尺也在变。
数据中心长期用能耗比来衡量能效,也就是总能耗和计算设备能耗的比值。这个指标能反映供电、制冷这些辅助系统的开销,但不直接衡量计算设备完成了多少有效计算。
同样一个能耗比,背后可能是不同的设备利用率、任务完成量和业务成本。通信等待、任务中断和调度不匹配,都可能让投进去的电没能变成预期的结果。
所以光看设施侧的节能还不够。还得看进到服务器里的能源有没有被充分利用。能源和硬件,加上软件与业务,需要在同一套评价目标下协同。
商汤科技大装置事业群智算中心总经理林海在峰会上说,商汤正从以能耗比为核心的能效管理,走向以每瓦特词元为核心的全链路效率管理。这把用电效率和词元产出挂上了钩,把从电网电厂到模型服务的各段纳进同一条评价链路。
据他披露,商汤大装置通过端到端全链路优化,单位电力成本的词元产出提升了 80%。临港智算中心也是业内首个拿到相关机构算电协同最高等级认证的智算中心。
华为董事、华为数字能源总裁侯金龙把话说得更直接。每一瓦特产出更多词元,每一词元的成本更优,这就是算力工厂的核心竞争力。
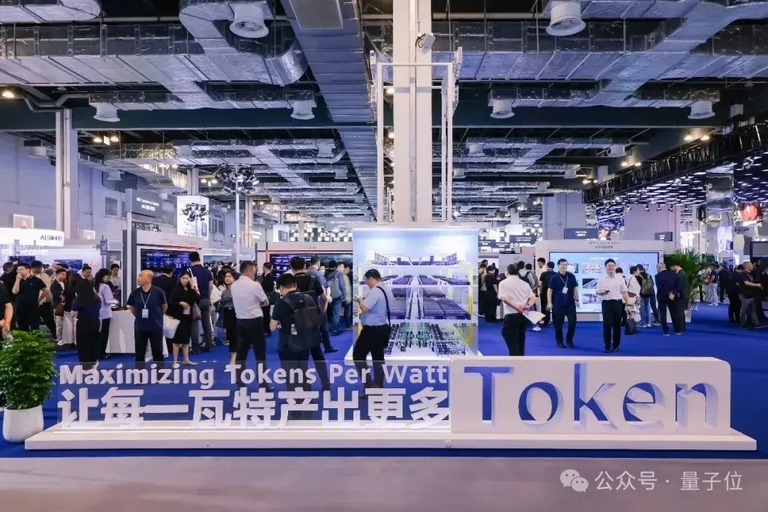
这套评价得跟具体任务连起来。不同模型、不同输出质量和时延要求,都会影响词元产出。能耗统计的时间和边界也必须一致。
所以能耗比仍然有价值。面向业务的指标只是多给了一个观察维度。在满足质量和服务要求的前提下,一座算力中心能持续交付多少有效计算。
评价标尺一变,产业里的能力组合方式也会变。电源厂商懂电能转换。服务器厂商了解计算设备。数据中心运营者掌握业务需求。
当评价目标延伸到最终的计算产出,这些环节就得比过去更早共享信息、一起设计。
华为的位置特殊在这里。计算侧它有加速服务器、超节点和计算系统。能源侧覆盖光伏和储能,还有供电与热管理。
跨领域协同的能力,在词元时代会更值钱。只有同时理解计算和能源两端,才谈得上全链路优化。前面那个热管理单元和加速服务器的原生适配,就是这种能力的一次具体落地。
更长远的问题在于,AI 硬件的迭代速度和能源基础设施的使用周期并不同步。
一座算力中心的供电、管路和建筑设施,往往要服务好几代服务器。每换一代计算设备,配套系统就要大改一次,扩容时间和改造成本会不断累积。
所以下一阶段的设计,得从建成时够用,往前再走一步,考虑后续怎么升级。核心设施要能长期复用。迭代模块可以独立替换。新旧设备之间要平滑共存。
这些设计选择的价值会跨代际显现。给设施升级留出余地,让基础设施在服务现有业务的同时,逐步适配新的计算需求。
这道门槛不低。既要理解计算系统的演进方向,也要掌握能源系统的运行规律,还得能把设计变成可靠的工程交付。
它得在真实的算力负载、电网条件和项目工期里反复校正。靠某一个环节的单点突破,很难快速形成。
这种跨领域能力,也给华为连接产业生态提供了一个支点。
算力中心的建设涉及很多环节。计算设备。供配电。制冷。储能。还有运营。能同时理解计算和能源两端需求的厂商,更有条件衔接各方的约束,推动伙伴围绕系统目标做适配和验证。
随着项目经验积累,产品之间的协同还能沉淀成可复用的工程方法和生态协作经验。
AI 基础设施继续往更大集群演进,算力和能源的联系只会更紧。
对厂商来说,下一阶段更难复制的竞争力,来自对整条链路的理解,以及把这种理解变成产品、工程和生态协作的长期能力。
