

Opus 5.5 一发布,试用的人就排起了队。
有人要网页。有人要动画。还有人要游戏。这些成品比跑分数字直观,一部分还能直接上手玩。
一位叫 MiaAI Lab 的创作者更狠,直接让它做 100 个 HTML 文件。要求只有三条:好看,设计不重复,创意放开。

结果很惊人。每个点开都像模像样。能自己干活的 AI工具 这两年不少,可真敢把一整件事交出去的,还不多。
同一个模型面对不同的交互形式和视觉风格,给出的处理相当多元。有的偏工作台,有的偏展示页,风格几乎没有重样。
这个案例里,它自己决定做哪些作品,也自己写出页面结构和交互代码。从构思到拆解再到成品,自主性很强。给一个开放的总目标,它自己规划步骤,把任务完整交出来。这正是 Claude 这次最想推荐的用法。
一次交代整件事,它真能做完。
难的地方在边界。任务说太细,模型没有发挥余地。说太粗,它又容易跑偏。在 Opus 5.5 的使用指南开头,Anthropic 先把这条分界线讲清楚了。把事情一次交代完整,说清楚什么算做完,也说清楚什么情况该停下来问人,然后让它自己干。
指南举的例子是迁移支付接口。交代任务之外,最要紧的是写明完成标准:所有接口都换成新客户端,旧客户端删掉,测试通过。只有碰到无法解释的失败,模型才需要停下来问。这条要求给了它自行推进的空间,也留下了可核对的交付标准。
类似建议在上一代就提过。这次特意强调的,是新版本更擅长在长时间、多步骤的任务里持续推进。
这类长任务,正是 AI编程 圈子里最受关注的活。
发布材料里提到,一位早期测试者让它审查并修复约 20 万行代码,不到三小时做完。同一个任务,上一代花了 20 多个小时。另一项内部测试要求把 HAProxy 从 C 改写为 Rust,新版本用了 9.5 小时,改写结果几乎通过了原项目的回归测试。
翻新老代码本来就是慢活。能压缩到这个量级,靠的不是手速,是它自己会切分任务,做完一段再进下一段。
不过干得久,未必干得对。
媒体 Every 做过一次实测。给新版本十分钟,为一场客户培训写按分钟排的日程表。它读完需求,花了将近五分钟思考,又去做训练数据,核对表格,写学员材料。时间到了,最要紧的日程表反倒没交出来。
这类翻车并不罕见。活儿做了不少,用户最想要的那一件偏偏没交。
Every 的另一次应用开发测试也说明问题。任务页面看着很漂亮,自动检查也显示通过。可测试者真正上手操作时,核心页面还是报错。
想一步到位,还是不太现实。
而在文字表达上,新版本进步很明显,那股典型的机器腔被修掉了。
有网友说,测完最大的感受是写作风格终于修好了。
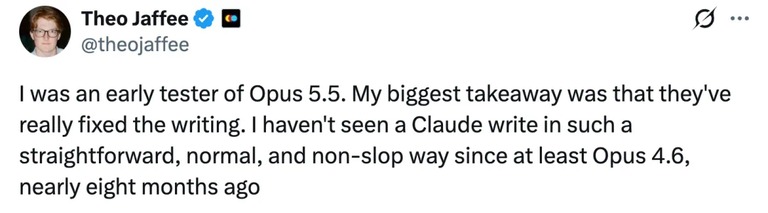
大意是,写东西变得更直接、更正常,也没那么一股机器味。上一次看到它写得这么干净自然,差不多是八个月前的事了。
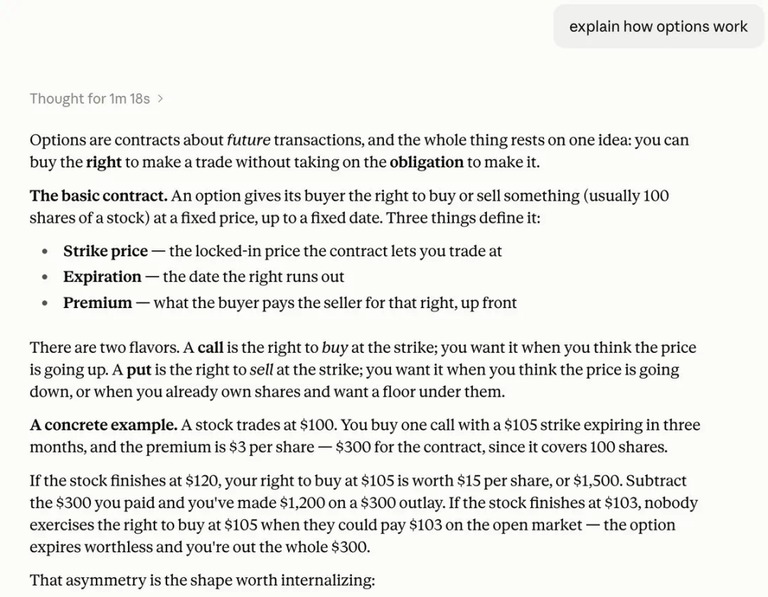
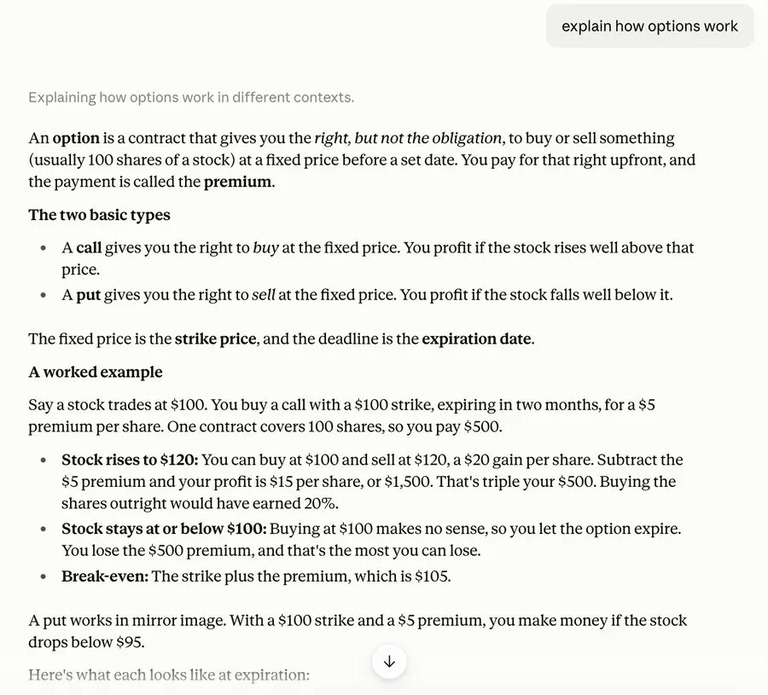
上面那张是旧版输出,啰嗦,写作痕迹明显。下面那张是新版对同样内容的输出,更简洁,也更自然。
新版更新说明里讲,沟通更自然,会把重要信息放前面,也更愿意守用户给的写作规则。
有网友还发现,新版把破折号干掉了。在上面那组对比图里,旧版输出多处用了破折号。新版写同样的内容,一个都没用。
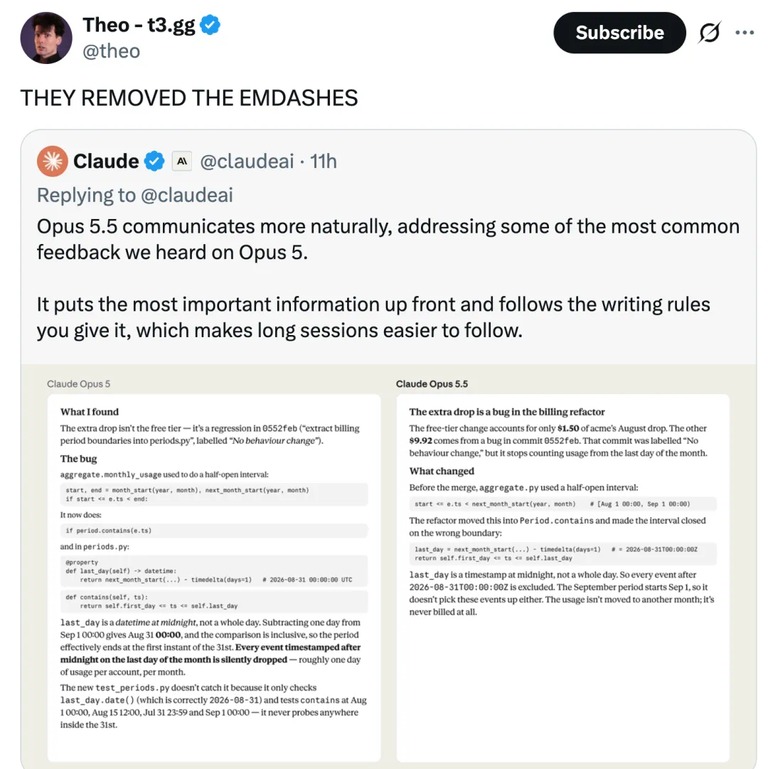
破折号只是表层。背后是整篇行文的节奏被重新调过。对智能体来说,这条改进的价值比看上去大。交付的文档能直接用,就少一次返工。
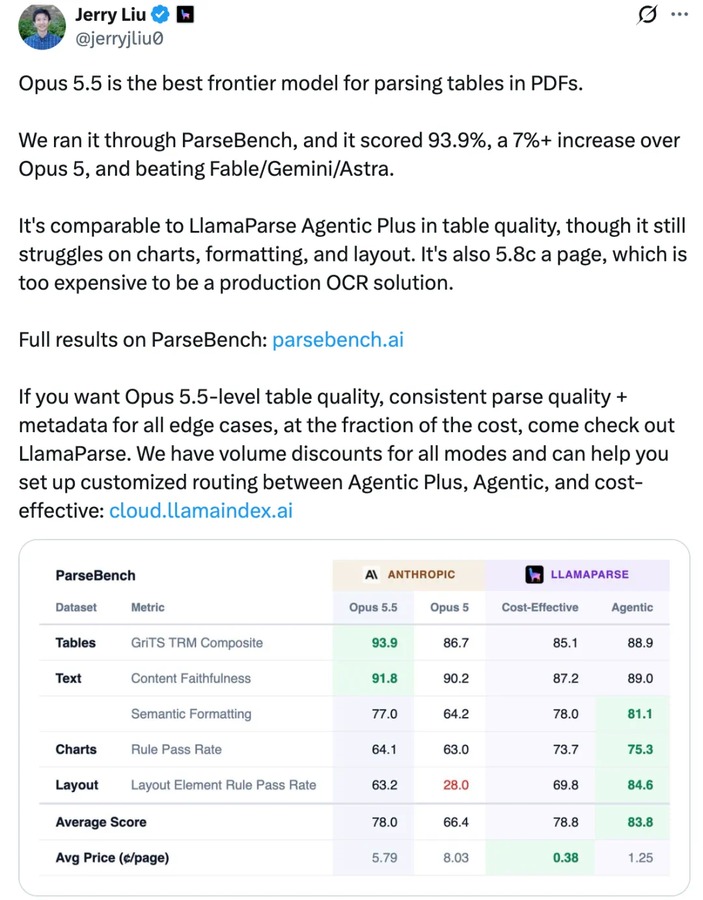
表格解析这块也有人测。LlamaIndex 的负责人用自家 ParseBench 跑了一遍,新版得分 93.9%,比上一代高出 7 个百分点以上,也超过了同期的几个对手模型。短板在图表理解,格式和布局也还差点意思。
它现在不只是会写代码。新版本还能用代码直接创作动画,既有艺术感,也够流畅。
一位叫 Kevin Ngo 的博主,让它用 JavaScript 逐帧画出下面这段动画。
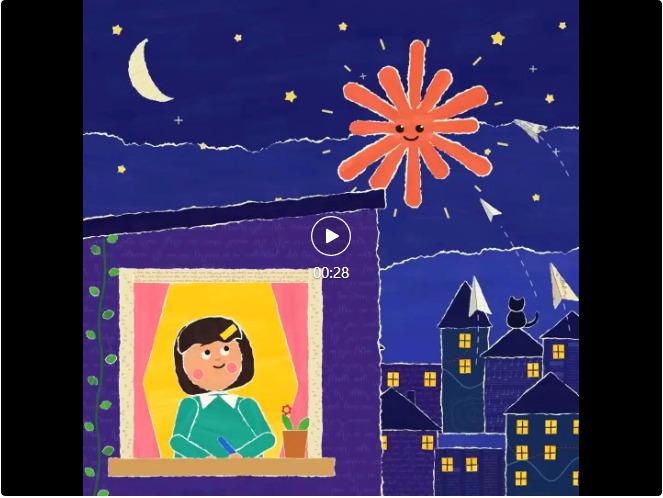
也有网友用它做出了类似的东西。
音乐也能来。有人只给了一句提示词,让它用 JavaScript 做点贝斯音乐。结果它一次就写完了完整代码,生成了一段听起来相当不错的曲子。
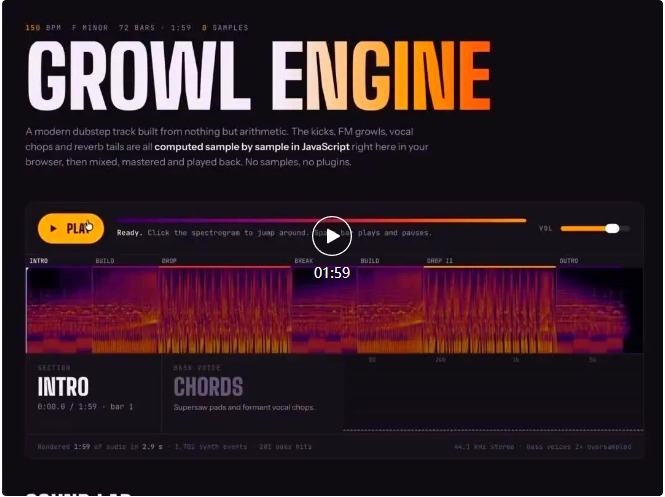
这些演示看着花哨,指向的其实是同一件事:它能拿代码当通用工具,去做代码之外的目标。
至于还有哪些更好玩的用法,那就看你怎么给它出题了。
Claude Code会员中转站 微信:douhanq
