

机器人干活时,最容易出问题的不是没看清眼前,而是忘了刚才。
积木被黑盖扣住,盖子底下是什么颜色,当前画面里已经找不到答案。它只能靠几十秒前那一眼。
面壁智能牵头做了一套方案,名字叫 SimpleMemVLA。华中科技大学、中国人民大学参与其中,清华大学和北京大学也在合作名单里。北京智源人工智能研究院与北京中关村学院同样参与。
它的做法有点反常。
没有给机器人另加一个记忆模块。带时间戳的历史画面,直接当作上下文喂进去。
对做 AI工具 的人来说,这个思路值得看一眼。
四项记忆基准,它拿了最好成绩
评测分两块。一块考记忆,一块考通用操控。
记忆这块有四项基准。任务形态不一样,考的却是同一件事。
它要记住已经消失的线索,要分清哪些事件重复发生过,还要一路盯着任务走到哪一步。
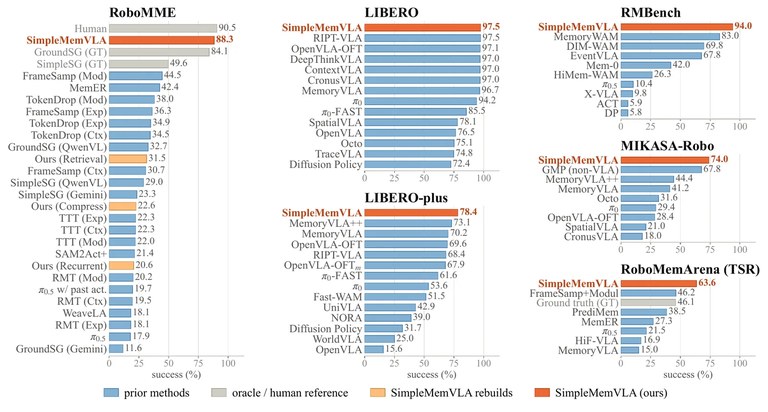
长程交互上的收益最明显。
有一个基准包含 26 项任务。每段轨迹平均超过 1000 个控制步。
历史窗口给到 126 秒时,它的全阶段任务成功率达到 63.6%,比此前最强模型高出 17.4 个百分点。
两个子项的提升更直观。计数任务从 31.4% 升到 71.4%,遮挡任务从 39.1% 升到 64.3%。
这不是单纯换了个更强的底座。决策那一刻,模型还读得到原样的历史画面。
为什么现在能直接塞进去
窗口放得下,才谈得上不压缩。
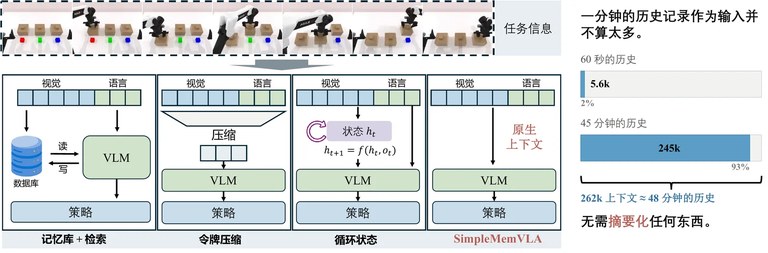
按论文的设置,60 秒历史大约占 5.6k 个词元。底座模型能容纳 262k 个词元。
分钟级的历史,整段放进去还有富余。
反过来看压缩这条路,麻烦在于时机。存进记忆的那一刻,就得决定留下什么。
论文里把这个限制叫写入时承诺。
宁可多留一段画面,也别提前替它筛一遍。
一个细节重不重要,往往要等到后面的任务才知道。提前筛、提前压,很可能丢掉以后才用得上的东西。
这套方案把画面、先后顺序和时间戳一起留在上下文里。模型理解当前任务时,顺带把过去也读了。
它不先把历史加工成一份固定摘要,再照着摘要行动。
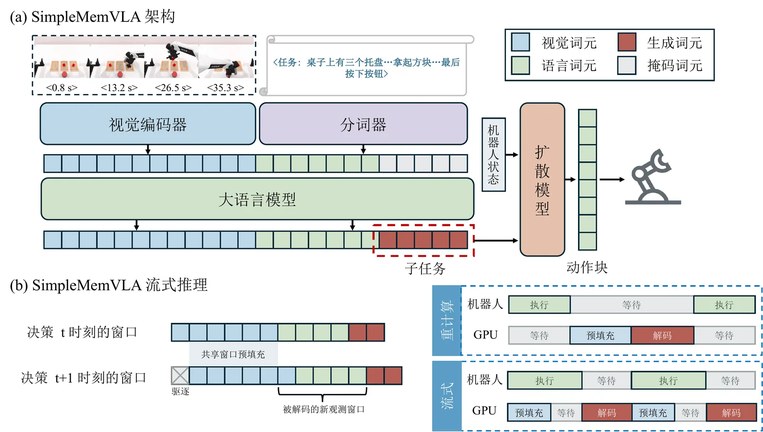
细节上,历史画面沿用了底座模型预训练时的视频格式。按时间顺序排好,每段附上明文时间戳。
当前腕部画面的输入通道单独分开。
模型先输出一句当前子任务。比如「揭开红色积木上的盖子」。
这句话形成时的那份隐藏状态,会和词元嵌入、机器人本体状态一起传给动作头,生成下一段动作。
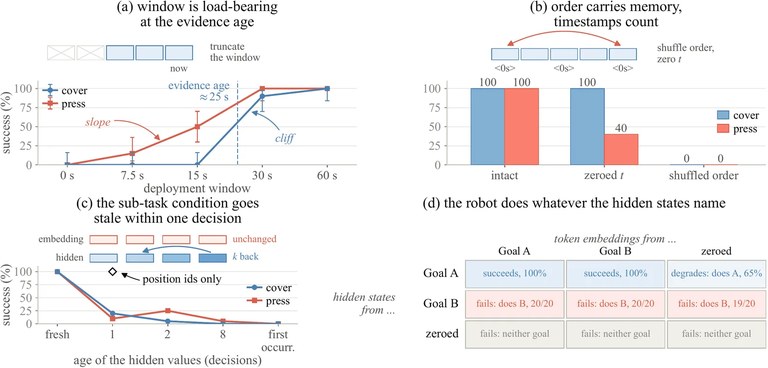
消融实验给出了一个反直觉的结论。历史信息主要靠这份隐藏状态起作用,而不是靠子任务那几个字。
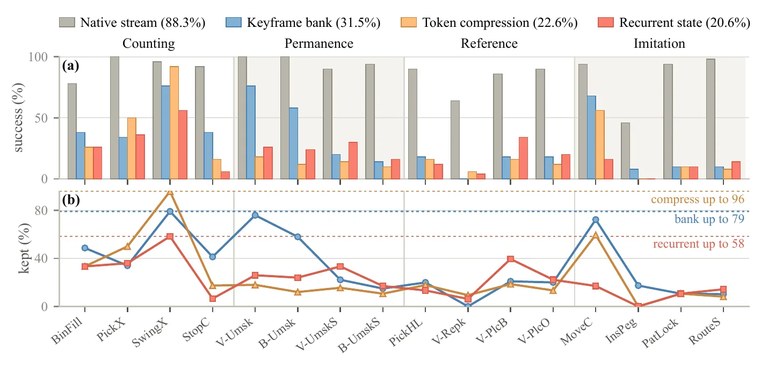
为了把功劳分清,研究者锁死了其他变量。
训练数据不动,底座模型不动,子任务监督和动作头不动,优化器也不动。只换记忆机制。
换完之后差距很大。原生上下文拿到 88.3%。检索方案 31.5%。词元压缩 22.6%。循环状态 20.6%。
结论支持一个判断。让模型自己去读仍然可读的历史,比提前替它决定哪些信息值得留下更有效。
少一段画面,任务就失败
关键画面和时间顺序,一个都不能缺。
窗口该留多长,实测说了算,别拍脑袋定。
盖积木任务里,30 秒的窗口仍包含 25 秒前的遮盖过程,模型能把活干完。
窗口缩到 15 秒,关键画面滑出视野,任务失败。
按键计数也随窗口缩短一步步退化。
只留当前画面,或者把帧顺序打乱,两项任务全都失败。
不更新参数,行为也能跟着变
这套方案不只用来回忆。
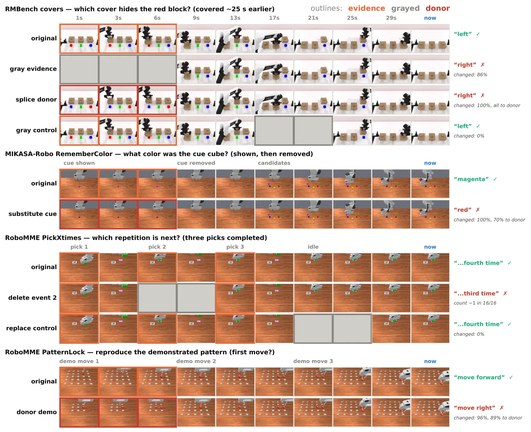
研究者把另一条执行轨迹里的片段,接到原有历史后面。
换掉积木被盖住的位置,模型就转向新位置。把颜色提示从品红换成红色,它就去拿红色的那块。替换演示序列的开头动作,下一步操作也跟着改。
这些拼起来的历史,训练时从没出现过。推理时也没有更新任何参数。
模型仍然能从新的视觉上下文里判断任务状态,据此行动。论文把这种现象叫作视觉上下文学习。
行为改变还有选择性。
动关键历史会出事。遮住积木被盖的位置,模型会选错盖子。抹掉一次已经完成的抓取放置,它就少算一次,还追加执行一遍。
遮蔽等长的无关片段,输出原样不变。
在所测任务里,原生上下文既能承载记忆,也能让新的视觉信息直接影响动作。
长历史不等于慢
把几十秒画面全塞进去,最直接的担心是延迟。
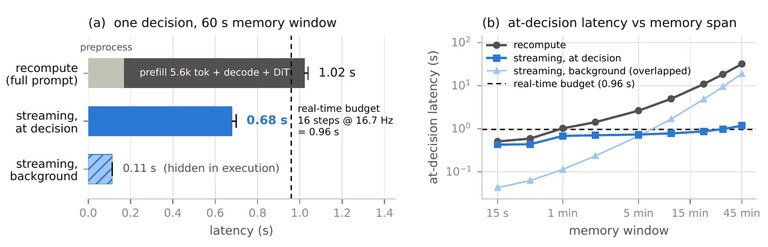
研究者选择复用历史计算。60 秒历史的决策延迟从 1.02 秒降到 0.68 秒,低于实测任务的 0.96 秒实时预算。
这个结果来自单张 H100 的测试环境。精度用 bf16,批大小为 1。
思路不算复杂。连续两次决策共享大部分历史,机器人执行当前动作时,系统提前算好下一次仍会用到的历史前缀,把键值缓存存下来。
下一次决策只需处理新增内容,再生成子任务。
这条流式路径与全量重算生成同样的子任务文本。区别在于,共享历史的那部分计算和动作执行重叠了起来。
更长上下文下的差距更夸张。
约 45 分钟历史对应 245k 个词元。全量重算要 32.1 秒,流式路径压到 1.18 秒。
该提醒的地方也有。历史继续变长,后台预填充和缓存的成本仍会跟着涨。
真机上的揭盖顺序
演示安排在真实双臂机器人上。
机器人先用同样的黑盖遮住三块彩色积木,再按指定顺序揭盖。此时当前画面里已经看不到颜色。
它得靠遮挡之前的那段经历,判断每个盖子下面是什么。
三次不同布局的自主执行里,它都按先红后绿再蓝的顺序完成了揭盖。
第三段执行走的是中到远再到近的顺序。这说明机器人不是沿固定方向扫描,而是在用历史里的颜色与位置关系。
下一步想让上下文教它学
论文和开源代码都已经放出。做 AI编程 的可以自己跑一遍。
研究团队接下来要引入更丰富的上下文。人类第一视角数据、机器人示教视频和自主执行历史都在计划里。
让机器人从示范和过往经历中学习,再把经验用到新任务、新场景,是这条路线想走的方向。
上下文不再只是帮它记住过去,也要成为它学习和适应的来源。
