

Jev 刷屏快一周了。
围绕这款直接输出判断和概率的模型,讨论一直没停。
从 X 上的演示到开发者的动手尝试,有个问题慢慢浮出来。
当 AI 用来做决策,还需要先生成一长串文字吗。
把时间拨回整整一年前。
2025 年 9 月,已经有研究提出一个新方向。
让模型一次并行生成多种可能的未来。概率直接写在结果里。
这篇论文从第一句起,就把「服务决策」写进了研究动机。
研究来自香港中文大学徐强教授团队。
论文题为《From Samples to Scenarios》。中文意思是「从采样到场景」。
2025 年 9 月 24 日公开,现已被 ICLR 2026 接收。
TimePrism 就是为这套范式准备的验证模型。
论文链接:https://arxiv.org/abs/2509.19975
代码链接:https://github.com/Fifthky/TimePrism
如今 Jev 被反复提到的三个词,是显式概率和并行输出,还有面向决策。
这套组合在一年前那篇论文里已经成形。
时间对得上。
两个不同的领域,为什么会走向相似的方向。
一、Jev 火在哪:把判断本身当成任务
Jev 做的事很直白,把日常交流里的判断变成模型的核心任务。
这条信息该不该保留。下一步该选哪个动作。任务是不是已经做完。
开发者给出文本或程序状态,再定义问题和选项。
模型返回概率和评分这类结构化结果,交给程序直接使用。
这些任务通常不需要一篇长回答。
Jev 采用面向判断的输出方式,还支持对同一份输入并行处理多个问题。
省下来的正是逐词生成。
对 AI编程 来说,这类判断尤其多。工具调用成不成功,要不要重试,哪条路径更短,全是离散问题。
这和过去大家熟悉的 AI对话 那种逐词生成长文,区别就出来了。
X 上创始人的游戏和网页导航演示,把这种变化摆得很直观。
后面跟上的开发者实验,又把这轮讨论往前推了一段。
传播的焦点其实是一件事,AI 怎么更直接地进入软件的决策过程。
TimePrism 回答的是概率预测里的同类问题。
系统需要提前行动时,模型到底该交付什么。
它的答案是一组可能结果,以及每个结果的概率。
后面的系统就能按不同结果的成本与收益,比较行动方案。
二、把「会发生什么」和「多大可能」一起学出来
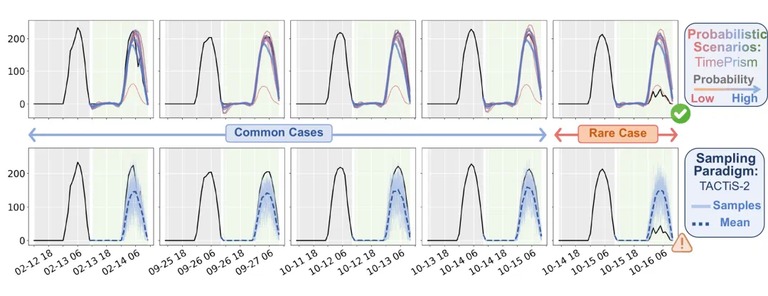
假设一个系统要安排明天的备用电力。
只给一个发电量预测还不够。
正常发电和发电量大幅下降,都可能对应不同的准备方案。
系统得知道有哪些可能的未来,也得知道每种未来出现的可能性。
常见的概率预测方法靠采样表达这些可能性。
反复生成未来轨迹,再从样本集合里估计分布。
样本越多,统计信息通常越充分,生成和处理的成本也跟着涨。
这笔账不划算。
TimePrism 提出的「概率场景」范式,把学习目标直接写成场景和概率。
模型既学有代表性的未来场景,也显式学习这些场景上的概率分布。
推理时一次前向计算,就能并行拿到整组结果。
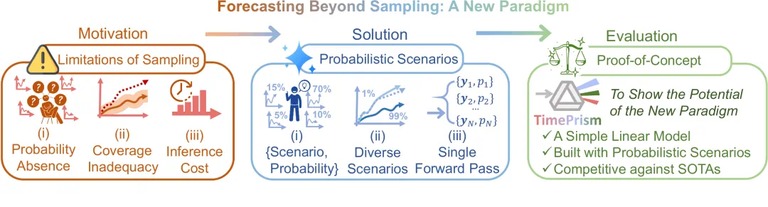
这意味着,概率不再需要只靠大量重复样本的频率来体现。
每个场景都带着自己的权重。
决策系统可以直接算不同方案在这些场景下的预期成本。代价较大的情况,也能提前留出资源。
三、验证这套想法,只用了三个线性层
TimePrism 的核心可学习结构只有三个并行线性层。
两个分支生成未来场景,一个分支学习对应概率。
结构就这么简单。
训练时,场景分支去覆盖不同的真实未来,概率分支去学这些场景各自的权重。
团队是有意采用这种简洁设计的。
他们想验证一个关键假设。学习目标和输出形式只要设计得当,简单结构也能做好复杂的概率预测。
架构的意义,就是把新范式的有效性摆清楚。

论文在五个基准数据集上比较了两项主要指标。
TimePrism 在十项比较里拿到九项最佳,计算开销还很小。
被它超过的模型里,有扩散模型,有流模型,也有专门为时序任务改造的注意力模型。
这个结果为论文的核心想法提供了实验支持。
换个学习范式,极简结构也能释放出更强的能力。
这种研究方式,也延续了通讯作者徐强团队一贯的做法。
2023 年,团队发表过一篇论文。他们用简单线性模型挑战当时流行的注意力预测方法。
这篇稿子引发过激烈讨论。
截至 2026 年 9 月,那篇论文的引用已经超过六千次。
它也是近年时序预测领域影响最大的工作之一。
有意思的是,这一次团队又选了简单的线性架构。
场景与概率被分开建模,为的是把概率场景范式验证一遍。
这多少有点致敬自己那篇旧作的意思。
四、两项工作放在一起看
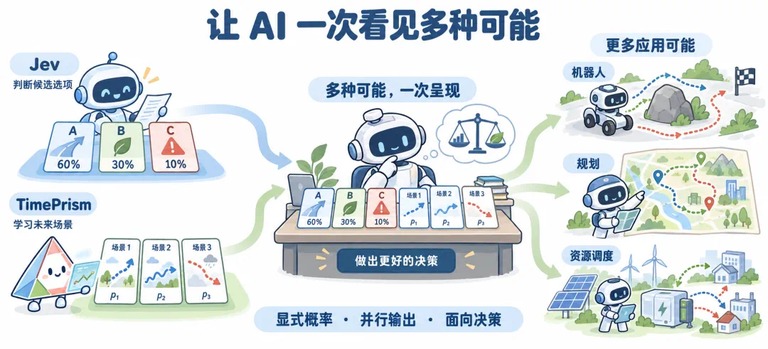
把两件事摆在一起,最值得关注的共同点,是按决策需求重新设计模型的输出。
选项和它的概率,未来场景和它的权重,都能直接进入后续程序的判断与计算。
概率因此成了模型和决策系统之间的一种接口。
两者也都体现了并行处理的价值。
Jev 可以围绕同一份输入并行回答多个判断问题,省掉逐字生成文本的开销。
TimePrism 一次输出整组未来场景和概率,省掉推理阶段的反复采样。
各自的计算方式,都围绕最终要的结果重新组织过。
两者的差异同样有意思。
Jev 面向自然语言和程序状态,问题或候选选项通常由开发者定义,模型只负责判断。
TimePrism 面向未来的不确定性,连有哪些候选未来都交给模型去学。
前者侧重对给定问题作判断,后者侧重生成带概率的未来图景。
结语
这条路的潜力,还可以放到更广的任务里试。
机器人要比较不同运动轨迹。规划系统要考虑多种后续状态。资源调度要权衡不同需求情景。
这些任务都可能受益于「多个候选结果加各自概率」这种输出形式。
未来,概率场景范式还能接上更强的骨干网络,更复杂的场景表示,以及规划与优化方法。
TimePrism 给的起点很朴素。先明确决策需要什么信息,再设计模型怎么学、怎么交付。
对做 AI工具 的人来说,这篇一年前的论文值得翻一翻。
Jev 的走红让这条路线重新被看见。
但这条命题去年就有人写清楚了。
让 AI 一次看见多种可能,再把它们交给下一步决策。
