

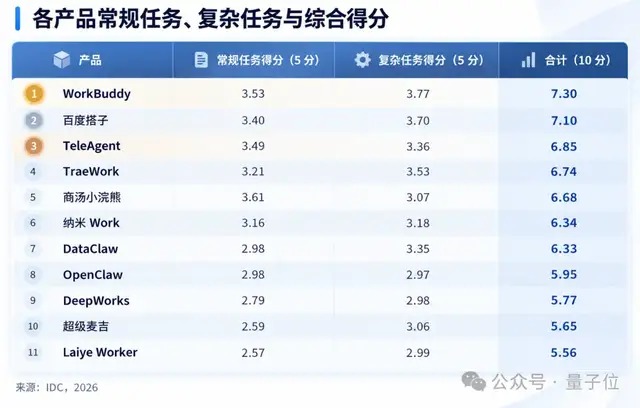
中国电信做了一款企业级通用智能体。名字叫 TeleAgent。在 IDC 刚发布的国内首份《中国企业级通用Agent产品技术评估》里,它排进了前三。
近百道真实任务,考的是能不能把活干完
这份评估的考法跟以往不一样。以前看模型能力,跑一遍数学和代码,再把推理与知识过一轮,分数出来就能排座次。这次 IDC 把重点放在另一件事上。智能体能不能把活干完。
近百道非公开任务。从邮件、日程到文档处理这类日常办公,还有长上下文和多步骤循环。复杂 PPT 也在考。表格处理和浏览器操作同样有。有些题目已经很接近真实工作。让智能体处理 3755 行脏数据。或者从约 3 万字材料里提炼内容,生成 11 页 PPT。
做完还不算完。IDC 会继续核验系统状态和最终文件,确认任务是不是真完成了。
成绩上,TeleAgent 常规任务拿到 3.49 分,复杂任务 3.36 分。九项能力里,任务表现是 5 分满分。成本效率这一项,是这次评测的最高分。
而且它上线时间并不长。今年 4 月,TeleAgent 桌面端还在公司内部试用。到 7 月,V1.0 才正式对外推出。一个多月时间,用户规模已经接近 120 万。
[IMG1]
问题就来了。一家央企做的通用智能体,为什么能在这一轮竞争里跑得这么快。
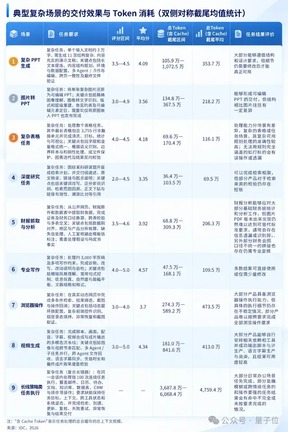
先看评测本身透露的信号。大多数通用智能体已经能把复杂任务跑起来。任务变长、步骤变多之后,交付质量和资源消耗的差距同步放大。
[IMG2]
模型只是一部分,剩下的是外围那套工程
这说明一件事。通用智能体发展到今天,底层模型已经很难解释全部差距。一款智能体好不好用,越来越取决于模型外围那整套工程系统。
IDC 在报告里专门提了一个词,Agent Harness。可以把它理解成围绕大模型搭起来的一整套执行系统。模型负责理解和推理。任务真正跑起来之后,系统还要安排上下文和工具调度,保存任务状态,控制执行环境。中途出异常,它得判断是重试、换路径,还是恢复进度。结果生成出来,还要检查任务到底有没有完成。
短任务里这些能力看不出来。任务一拉长,差距就出来了。TeleAgent 的几个高分项,基本都能从这条工程链路上拆开看。
先说上下文。
智能体干活时间越长,打开的文件和工具返回的结果,还有前面聊过的内容,都会往上下文里塞。一直堆下去,词元会膨胀。压缩得太狠,用户一开始交代的要求又可能被忘掉。这个度很难拿捏。
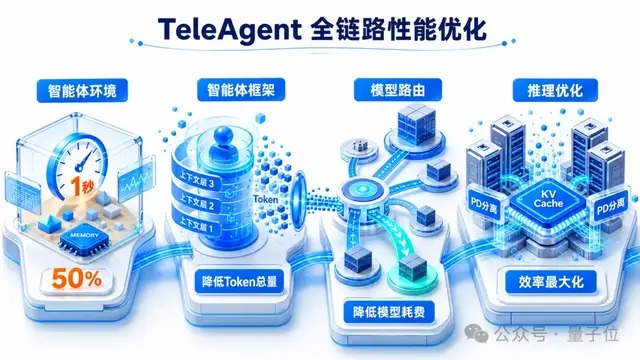
它的做法是分级处理。先对价值较低的旧工具输出做轻量剪枝。上下文仍然过长,再交给专门的压缩模型整段处理。同时系统实时盯着上下文有没有接近上限,一旦触发窗口限制就先压缩,再继续往下执行。目前上下文窗口已经突破 400K。
光让一次长任务不断线还不够。企业办公经常跨天,甚至跨项目。TeleAgent 又加了 autoDream 长期记忆。它会定期整理近期对话,把新信息与已有记忆合并。项目背景、用户习惯和个人偏好可以跨会话保留。用户第二天打开,不用再从头解释自己在做什么。
再往底层看,中国电信没有直接把现成的编程智能体框架套进办公场景。TeleAgent 的核心内核包含约 3 万行自研 Go 代码。团队还专门处理了 Windows PowerShell 这类环境,加上麒麟和统信这些国产系统里的兼容性问题。这活很琐碎,但绕不过去。产品侧也针对办公任务重新做了适配。做 PPT 和写报告,处理 Excel,跟在代码仓库里找 Bug,本来就是两套截然不同的工作方式。
[IMG3]
一边压成本,一边守安全
长任务能不能跑下去是一件事。跑起来贵不贵,是另一件事。这也是企业用智能体很难绕开的账。
TeleAgent 为此做了一套 ModelRouter。每次请求进来,系统先看模态和长度,再看关键词,判断任务复杂度。然后分配到轻量、均衡和旗舰三档模型。像翻译、总结这类任务优先交给轻量模型,格式化的活也一样。PPT、文档生成和办公自动化走均衡档。用户要做深度研究、代码调试或者复杂方案,再调动旗舰模型。
这样一来,智能体不用每处理一个简单任务都调用最重的模型。从优化数据看,这套智能路由能把推理成本降低约 40%。简单任务响应时间控制在 3 到 5 秒,路由延迟低于 10ms。推理侧还加了 PD 分离、键值缓存和负载感知调度。
成本效率这项最高分,就是这么来的。
企业真要把智能体接进内部系统,还有一道关是安全。
只负责生成一段文字时,智能体出错最多重新生成一次。现在它能操作文件,能调用系统,还能改数据,甚至代替员工走业务流程。一次错误操作的影响明显更大。
TeleAgent 从一开始就把这块看得比较重。技能进入系统以前,要查来源,还要过病毒和漏洞扫描。短期记忆与长期记忆分开管理。文件读写被限制在指定工作目录。高危命令会被监控。代码和文件操作尽量放在隔离环境里完成。
这套思路也直接影响了上线节奏。今年 4 月桌面端已经进入内部试用,随后又花两个月做安全测试和能力优化,直到 7 月才正式推出。对一款追求快速增长的互联网产品来说,这样的节奏偏保守。放到央企内部,它反而成了一道必须先过的门槛。
结果上,TeleAgent 成为首批通过中国信通院相关安全评测的智能体产品之一。在中国电信研究院的内部安全评测里,通过率 98.2%。与外部安全厂商联合测试的 28 个场景、336 个测试用例,通过率 99.7%。
这几件事连起来看就清楚了。上下文管理和执行工程决定任务能不能持续跑下去。模型路由和推理优化决定同样一个任务要花多少钱。安全和权限控制决定企业敢不敢真的把系统交给智能体。
从 Demo 走向企业日常办公,这三件事绕不开。
央企做产品,用的是互联网那套打法
不过有一说一,如果只看今年这轮智能体热潮,很多人会以为 TeleAgent 也是追风口追出来的产品。
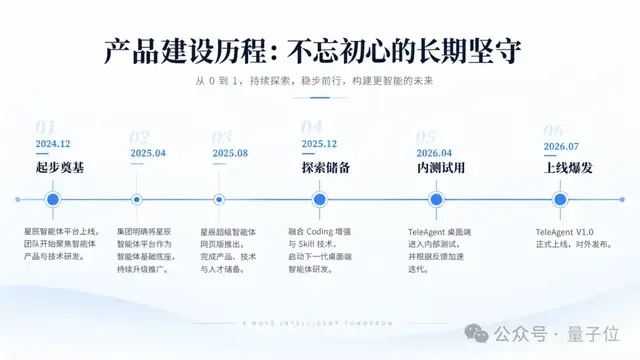
把时间线拉长就不同了。2024 年底,中国电信已经开始建设星辰智能体平台。2025 年 4 月,这个平台被确定为集团智能体基础设施。同年 8 月,团队推出星辰超级智能体网页版,开始尝试自主式智能体。此后随着 AI编程 这条线从写代码往通用办公延伸,团队又把编码增强、技能和桌面环境逐渐接了进来。
等到 2026 年 4 月 TeleAgent 桌面端进入内部试用时,前面已经积累了一年多的平台、技术和产品经验。
[IMG4]
而且它虽然生长在央企内部,做产品的方式却带着很明显的互联网色彩。
中电信人工智能公司目前有 1200 多人。九成以上来自社会化招聘,也吸收了不少头部互联网公司和 AI 企业的研发人才。整体平均年龄只有 30 岁出头。核心骨干有较大的自主招聘和技术探索空间。产品方向没完全确定时,团队可以先试错把体验做出来。公司内部对早期产品的要求,不是先算收入,而是先拿到用户口碑。
组织方式也跟着变了。过去大型央企做跨部门产品,很容易陷进多部门、多公司的长协同链条。到了 TeleAgent 这里,资源决策尽量集中,熟悉电信业务的人和懂互联网产品的人直接在一线配合。
另一边,中国电信原本的组织体量,又给这支团队提供了创业公司很难拥有的试验环境。
产品上线早期先在集团内部大规模使用。中国电信员工数量多,内部业务线又杂,办公和网络之外,还有政企云、号卡和宽带。这意味着智能体每天碰到的都是真实需求,不是为演示提前设计好的任务。
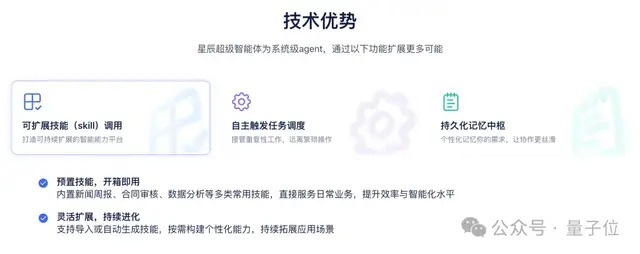
比如内部的技能广场,目前累计上架 5.6 万个技能,被添加近 200 万次,参与开发和贡献技能的员工达到 2 万人。
[IMG5]
员工自己造出来的东西也很接地气。有人围绕宽带、号卡这些主营业务做技能。有人用智能体生成符合内部格式的 PPT。还有一线员工直接拿去做摄像头巡检和电表识别。以前这些小工具要走立项和开发流程,现在一些需求开始由业务人员自己完成。
这些使用场景又会反过来喂给产品团队。中国电信内部既是 TeleAgent 早期最大的用户池,也成了一个相当复杂的企业智能体测试场。产品得同时面对普通员工和真实数据,还得应付专业业务与系统权限。这些问题在内部都跑不顺,面向外部企业就更难谈规模化。
整个企业市场正好也走到这个阶段。IDC 今年 4 月的调研显示,48.5% 的企业已经进入通用智能体的评估、试点或使用阶段。96.9% 的企业智能体应用落在 AI办公 上,流程自动化、知识管理和数据分析排在前列。
到这里,中国电信做智能体的特殊性就显出来了。云和算力是现成的,安全能力、政企客户和大量复杂业务场景也都有。现在又开始把互联网公司做产品时常见的快速迭代、用户反馈和成本优化方法吸收进来。
企业智能体接下来要解决的问题,恰好需要这两套能力同时在场。
对国内做 AI工具 的团队来说,这个信号值得记一笔。企业级市场拼的不是单一模型分数,而是从上下文管理到安全隔离的整条链路。谁把这套工程做扎实,谁才有机会把智能体真正送进企业的日常流程。
TeleAgent 的下载地址在这里,https://www.teleai.com.cn/product/teleagent
