

2026 年 10 月 15 日,
Mistral 放出 Timestral。
这是它第一个
时间序列预测基础模型。
一次给四个规模。
最小的 5M,最大的 209M。
图源知乎 deephub 专栏。
时间序列基础模型走的是另一条路。
先在大规模、多样化的数据上训练。
再把学到的趋势和周期,
噪声和变量关系,
用到新的序列上。
不针对目标数据集微调,
也能先做零样本预测。
先看看这套本事能不能直接用。
Chronos 和 TimesFM 已经探过这条路。
但现实里要预测的东西,
往往不是一条曲线。
天气会影响结果。
节假日会影响结果。
生产排班也会影响结果。
库存和容量规划要的是一个区间,
不是一个数。
还有推理成本,也得算进去。
Timestral 把这些需求写进了模型设计。
它做的是数值序列的概率预测。
和那种把时间信息写成文字、
再交给AI对话类产品去读的做法不同。
它直接吃数值。
四个规模都用了基于片段的 Transformer 架构。
处理器能跑,显卡也能跑。
上下文最多 32,768 个历史时间步。
单次前向最多预测 1,024 步。
每一步输出 21 个分位数。
条件输入分四类。
历史的目标序列,历史协变量,
已知的未来协变量,还有类别协变量。
缺失值也管。
空值和观测掩码都支持。
环境要求不重。
Python 3.10 以上,PyTorch 2.4 以上。
推理代码和权重都开源了,
许可证不一样。
四种规模的 FP32 权重,
分别是 21 MB,111 MB,
490 MB,837 MB。
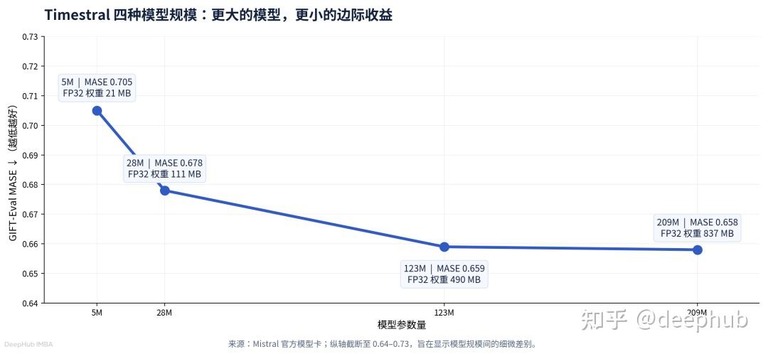
四种规模在 GIFT-Eval 上的 MASE,越低越好:209M 是 0.658,123M 是 0.659,5M 是 0.705,纵轴用了局部刻度。
GIFT-Eval 上,
123M 的误差是 0.659。
209M 是 0.658。
多 86M 参数,
只换来 0.001。
要不要选大的,
得先算自己的误差预算和部署成本。
两个轴一起看
骨干是因果 Transformer。
每 32 个时间步打包成一个片段。
时间轴一套注意力,
变量轴一套。
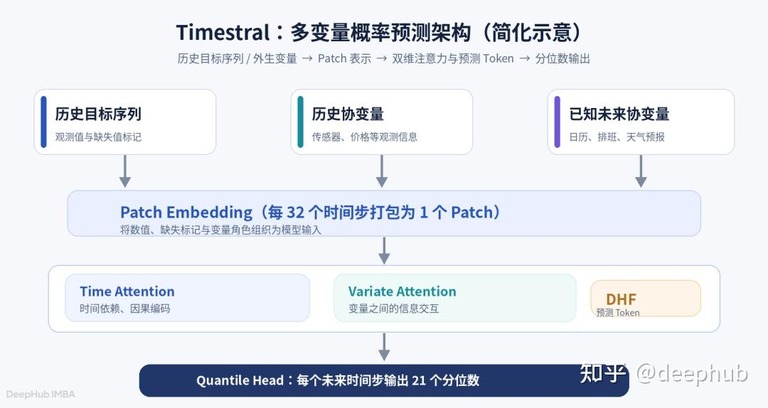
多变量概率预测架构:历史目标序列与外生变量先做 Patch 表示,再进双维注意力与预测 Token,最后输出分位数。
让历史既当答案又当上下文
常见做法是遮住未来一段片段,
让模型把值恢复出来。
被遮住的观测,能当训练目标。
但它不能再给更靠后的预测
当真实上下文。
同一个观测值,
两种作用,用不上两次。
这家公司换了个思路,
叫解耦预测跨度。
先保留已观测的历史序列。
因果编码之后,
引入一组可学习的预测标记。
让这些预测标记去读
前面编码出来的信息。
这样一来,历史观测既能当训练目标,
又保住了上下文作用。
真正缺失的观测,另外打标记。
按官方说法,预测跨度的设定
和缺失数据增强,
可以相对独立地处理。
已观测历史的利用效率也更高。
协变量不是配角
拿设备用电负荷举例。
历史负荷能反映设备怎么运转。
但未来怎么变,
还跟环境温度有关。
也跟生产计划有关。
检修安排一样会改动曲线。
只看目标序列,这些影响就漏了。
它给不同输入变量定了角色。
再用注意力约束
各类变量能读到什么。
目标变量只能用历史目标信息。
历史协变量,
比如实测温度和历史振动,
只能用已观测的那部分。
已知未来协变量能用未来值。
节假日日历,生产排班,天气预报,
都算这一类。
这里有条边界。
预测时已经知道的未来协变量可以用。
目标变量未来的真实数值,
一下都不能碰。
协变量向目标提供信息,
同时受信息流限制。
先合成,再掺真数据
训练数据以合成数据为主。
分两个阶段。
预训练时,
先造出带趋势的单变量过程。
季节性、多种噪声,
都是在这个阶段造出来的。
再用多变量合成器
建立非线性依赖。
拿 8,192 步上下文做大规模训练。
后训练阶段,
真实数据和合成数据混着用。
上下文长度扩 4 倍,
到 32,768 步。
合成数据的好处是
见过更多类型的趋势、周期和变量关系。
也不用死盯几个公开数据集。
但有个地方要留神。
合成过程有没有覆盖真实系统里
的突发事件和长期状态切换。
传感器故障也算一种。
这不是看训练规模能回答的。
得拿真实数据回测。
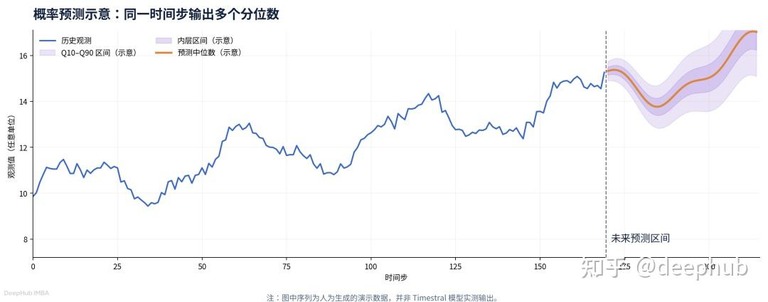
同一个时间步输出多个分位数:历史观测之后展开 Q10-Q90 区间。
点预测的规矩是,
每个未来时间步给一个数值。
它一次给 21 个分位数。
从 0.01 起步,
一路到 0.99。
0.05 和 0.10 也在里面。
训练用分位数损失,
可以理解成概率目标的离散近似。
这些分位数是拿来做决定的。
做AI电商的备货,
看高分位比看均值稳。
运维能看高分位负载,
判断容量顶不顶得住峰值。
但分位数要过校准这一关。
能算出十分位和九十分位,
不代表处处跟真实频率对得上。
三个公开榜单
GIFT-Eval 有 97 组配置,
允许用历史协变量。
TIME 是 98 项任务,
不引入目标序列之外的东西。
fev-bench 100 项,
历史协变量和已知未来协变量都能用。
官方说,
Timestral-209M 在参与对比的
预训练零样本模型里领先。
这个范围要说清楚。
它不涵盖所有任务,
也不能推到微调过的模型身上。
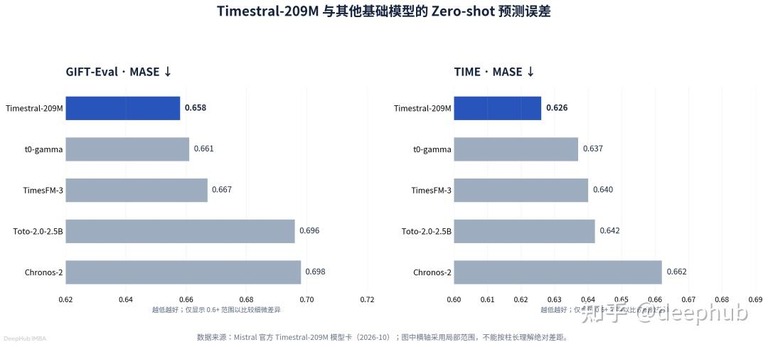
Timestral-209M 与其他基础模型的 Zero-shot 预测误差,GIFT-Eval 与 TIME 两个 MASE 榜。数据来源是 Mistral 官方 Timestral-209M 模型卡(2026-10),纵轴采用局部范围。
MASE 上,209M 是 0.658。
TimesFM-3 是 0.667。
Chronos-2 是 0.698。
表里还有 TIME 的 MASE 和 CRPS,
以及 fev-bench 的任务得分。
209M 每一项都领先一点,
幅度都不大。
三个指标的读法不一样。
MASE 是平均绝对标度误差,
越小越好。
CRPS 衡量整条概率曲线准不准,
也是越小越好。
这项是 fev-bench 里的任务得分,
越高越好。
处理器上的推理耗时也测了。
用三周、15 分钟间隔的历史,
预测未来一天。
8 线程的服务器上,
5M 约 10 毫秒。
209M 约 140 毫秒。
28M 的速度大概是 209M 的 5 倍。
十几行跑通一次预测
仓库里有独立推理代码,
一行命令就能装。
依赖四样,PyTorch 和 NumPy,
加上 safetensors 和 huggingface_hub。
第一次加载模型
会下载配置文件和权重。
官方示例用 28M,
配一条模拟历史序列,
预测 96 步。
先建预测器,
指定模型名,再选设备。
有显卡就用显卡,
没有就用处理器。
历史数据是 1000 步的累积随机游走。
调 forecast,
把预测长度设成 96。
回来的对象能取中位数,
也能取分位数。
预测长度按时间步算。
输入每小时采一次,
96 步就是 96 小时。
15 分钟采一次,
96 步就是 24 小时。
多变量输入用三维形状。
三个维度分别是批次、
目标变量数和历史长度。
外生变量走两个口子,
历史协变量和已知未来协变量。
已知未来协变量要同时盖住
历史和预测窗口,
形状多一个维度。
示例里第二段只是接口形式。
这两个参数得自己拿业务数据造。
用之前对齐时间轴,
确认没有未来信息泄漏。
一次前向最多 1,024 步。
窗口更长就分块。
前一块的中位数会接进后续上下文。
跨度拉得很长,
要检查逐块传下去的误差。
结语
这套技术组合挺明确。
解耦预测跨度管目标和上下文的关系。
受约束的注意力接外生变量。
输出直接是分位数。
四个规模摆在那,
部署时按误差、吞吐和成本挑。
合成数据优先的训练方式也值得看。
先从合成序列学时间模式,
再混真实数据做后训练。
能不能稳定搬到不同领域,
还要更完整的实验披露和独立验证。
有两点官方没展开。
一是合成数据的具体配方,
只说了趋势、季节性和噪声的生成方式。
二是微调之后的成绩,
公开的对比全是零样本。
要判断它能不能进生产,
这两块得自己补测。
许可证也分两种,
代码和权重的条款不一样。
商用之前得逐条看。
对做AI工具的人来说,
这类基础模型省掉的是
自己训一个预测模型的活。
它不解决业务问题,
只把数值预测这一段做扎实。
真实收益还得看数据和流程配不配。
出处三处,
官方仓库,发布说明,模型卡。
