

约束求解领域的国际赛事 SAT Competition 2026 刚刚收官。
冠军来自一支联合团队。
华为诺亚方舟实验室牵头。
云天筹求解器团队和华中科技大学一家计算中心一起参与。
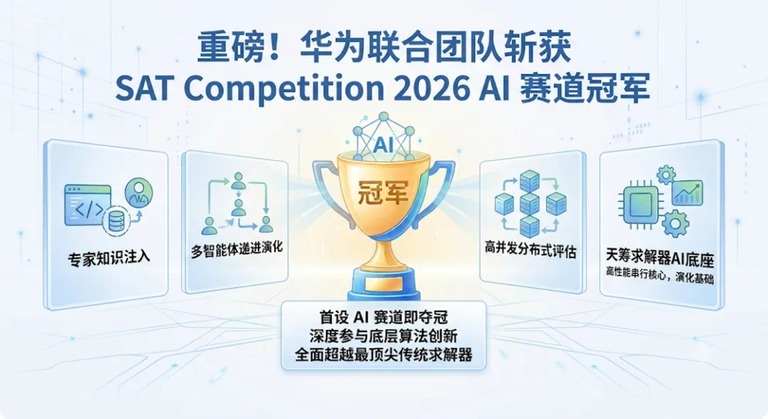
这个冠军和往年不太一样。
今年第一次开出 AI 赛道。
规则很清楚。
经过 AI 调优的求解器,性能必须超过最好的非 AI 求解器,才算获奖。
门槛不低。
AI 不能再当陪跑。
它得拿出可量化、可复现的真实提升。
SAT 问题常被称作计算复杂性理论里的珠穆朗玛峰。
它的用处比想象中宽。
电路要验证,芯片要设计,自动驾驶要做决策,背后都站着求解器。
软件测试要用它。
密码学分析也要用它。
AI 规划同样离不开。
赛事的分量来自它的规矩。
SAT Competition 由学术会议组织。
评测体系开源,规则严谨,结果可复现。
全球的科研机构和企业团队同台竞技。
获奖求解器常被大厂直接拿进生产环境。
二十多年下来,这个排行榜成了学界和工业界共同的标尺。
华为这次赢的方式和手写算法不同。
团队搭了一条求解器专用的算法自调优流水线。
专家知识被注入进去,多个智能体协同起来。
经验留在系统里,算法评估则覆盖多个维度和尺度。
再靠分布式算力集群做高速评测打分。
整条链路打通以后,全代码仓的算法设计都能自动跑。
宁可多花一点评测时间,也不让没验证过的方案上线。
这不是一个单点的 AI工具。
它更像一套能自己往前走的流程。
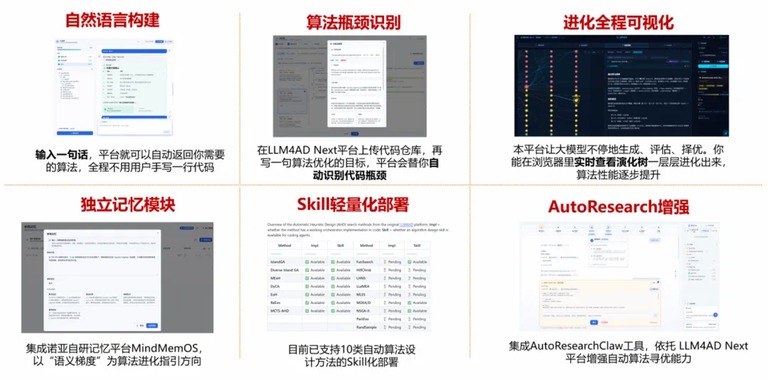
人只写目标,算法自己找路
支撑这条流水线的,是一个开源平台。
它由华为和香港城市大学一个教授团队联合开发,名字叫 LLM4AD_Next。
平台管的第一件事是自动构建算法。
用户把目标用自然语言说清楚就行。
构思由模型提,代码由模型写。
迭代筛选和效果评估也一并跑完。
人不必写全整套逻辑。
系统还会做进化式搜索。
候选方案一批批生成。
无效版本被自动淘汰。
在 AI编程 这个方向上,这类探索讨论了很久。
这一次它被直接用在求解器策略演化上。
人工调优没找到的方案,被它挖了出来。
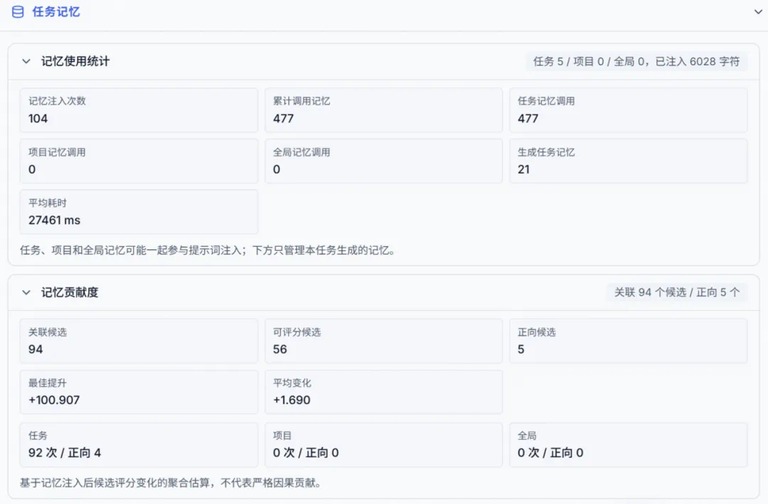
平台管的第二件事是记住试过什么。
它带了一个自研的记忆管理模块。
存下来的东西分三类。
有价值的任务灵感,具体场景里的先验,还有能跨任务复用的通用算法范式。
哪些调优策略在哪些实例集上更好,系统都留着记录。
下一次碰到同类问题,历史经验可以直接翻出来。
重复评测的开销省下来了。
这一点很实在。
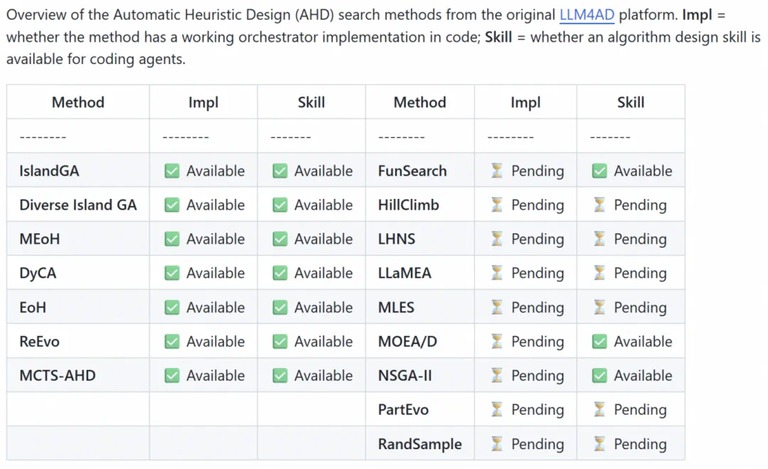
验证过的模块,打包成技能单元
第三件事是把零散成果收成积木。
平台上通过验证的算子和算法模块,会被封装成可复用的技能单元。
后续任务直接调用,或者重新组合。
与其每一轮从零写一遍,不如把验证过的组件留下来。
技能库会跟着项目一起变厚。
大模型可以基于现成组件做组合和二次优化。
新任务的输出质量因此更稳。
目前平台支持 10 类自动算法设计方法的技能化部署。
从选题到论文,链路也串起来了
再往上走一层,是整条科研流程。
平台依托开源科研智能体 AutoResearchClaw。
它有一条 23 阶段的端到端流水线。
从问题定义一路走到算法搜索,再做完基准对比。
结果归纳和论文撰写也接在后面。
团队还补了它原来的短板。
把 LLM4AD_Next 接进去,代码定稿之前先让它试着改进核心算法。
改完再用原实验的评测方法逐条验证。
成绩确实更好才替换。
没有变好就保持原样。
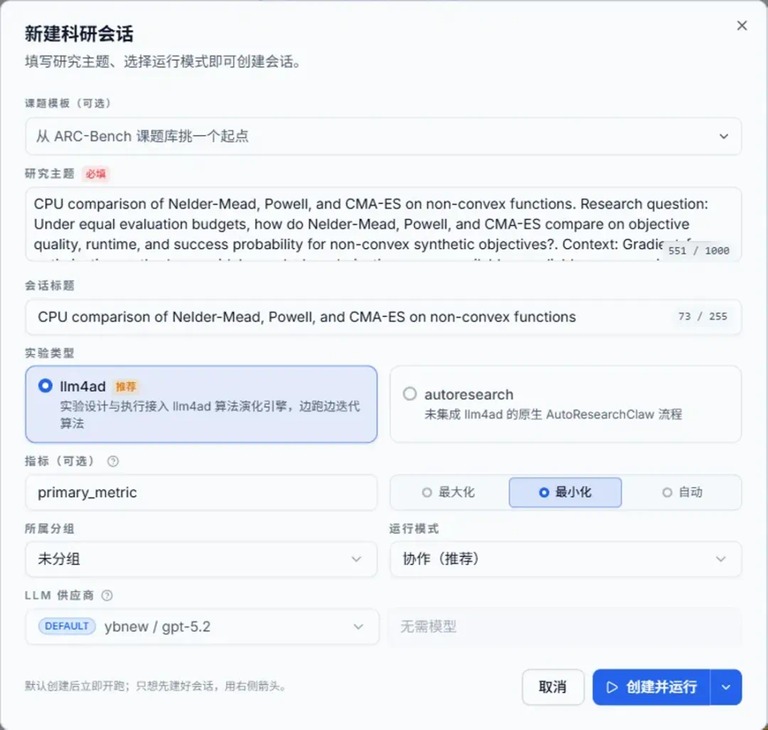
这套平台面向高校学生。
科研人员和算法开发者也能用。
目前已开源开放。
在线体验和代码仓库都在下面两个地址。
打开在线体验页面,填一句研究主题就能建起一个科研会话。
在线体验:https://llm4ad-next.cn
GitHub 链接:https://github.com/Optima-CityU/LLM4AD_Next
