

一个念头,过去要用一整套计算流程去验证
设计一种新的酶,很多时候并不是先有一个明确的计算公式。
经验丰富的蛋白质工程师会先看结构。这一步没有公式,靠的是直觉。看着看着,念头就上来了。
活性位点是不是太小了。把某几个氨基酸换掉,让口袋大一些,是不是更能装下体积偏大的底物。
又或者,让两个结构域之间稍微松一点,酶在低温下的活性会不会更好。
这些念头本身很轻。验证它们的代价却很重。
要先把模型建起来,再选好合适的物理参数。跑一次分子动力学模拟往往要等很久。结果出来,还得整理成能拿来判断的形式。
一步都省不掉。
9 月 10 日,《Nature Computational Science》刊出一篇论文。它给出了另一种做法。
论文题目里的关键词是直觉到设计。它要服务的对象,是基于物理的酶工程。
这套系统叫 MutexaGPT。研究团队想做的,就是把中间这段翻译工作交给 AI。
用户在一个 AI对话 界面里说出自己的设计直觉。这套系统把它翻译成物理模型和模拟任务。计算它自己跑。结果它自己看。最后交出一份能直接送进实验室的突变方案。
三个环节接力,把一句话变成可执行的计算任务
酶是生命体系里的催化机器。
它们精确控制活性位点附近的空间结构。分子运动算一环。化学环境也算一环。这些都让特定反应更容易发生。
想改变一种酶的功能,本质上就是找出一组新的氨基酸序列。这组序列要让蛋白质仍然正确折叠,同时拥有希望得到的催化性质。
过去做酶调控,研究人员得自己调用不同的软件,再手动把模拟与分析的流程串起来。
这种把软件一件件接起来的活,以前基本靠手写脚本。放在今天,它常被归到 AI编程 的范畴里。
这套系统要做的,就是把上面这些步骤自动化。
它的背后是一组彼此连接的语言模型智能体。
第一个环节负责理解问题。它会判断用户这句话里还缺哪些必要信息。
第二个环节把科学问题转成能实际执行的计算工作流。挑哪个物理模型,定哪套模拟方案,都在这里定下来。
计算跑完之后,第三个环节把结果重新讲成人能听懂的话。它还会给出下一步可以测试的突变建议。
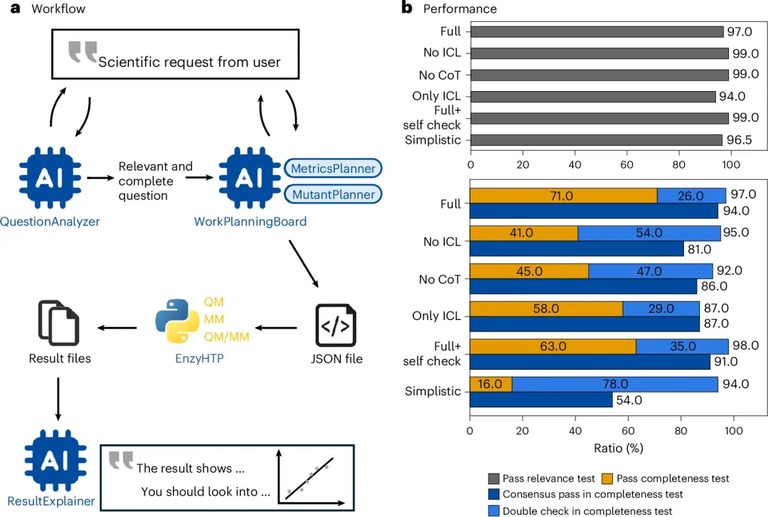
三个环节连起来,科学家的直觉就不再停在纸面上。它变成了一份可以跑的方案。
两次测试:一次回顾验证,一次走进真实实验
研究团队先做了一次回顾性测试。
这次测试翻的是旧账。
他们让这套系统处理一个经典问题。如何扩大酶的活性位点口袋,让它更容易容纳体积更大的底物。
系统根据已有的突变与活性数据建立设计约束。接着用分子动力学模拟计算不同变体的活性口袋体积,再按这个指标给候选突变排序。
答案是,排名前十的候选里有四个站得住。它们后来被此前的实验数据证明具有预期效果。
在研究团队自己的原始论文中,这项任务的命中率约为四成。相对基线方法,它实现了约四倍的富集。
命中的那部分,就是它替人省下的计算量。
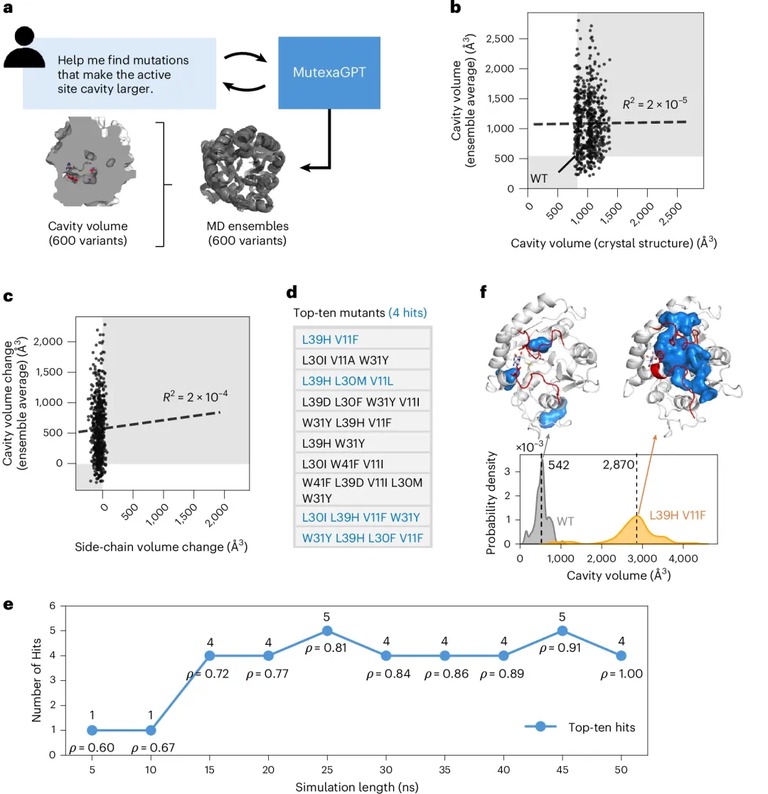
把科学家的设计直觉翻译成一个合适的物理指标,这件事在这次测试里确实做到了。
接下来是第二次测试。
针对双结构域酶,研究团队有一种猜想。把两个结构域之间的距离拉开,也许能提高低温下的功能。
系统按这个假设筛选候选突变。这一步是自动的。最后排名最高的两个变体被送进了真实实验。
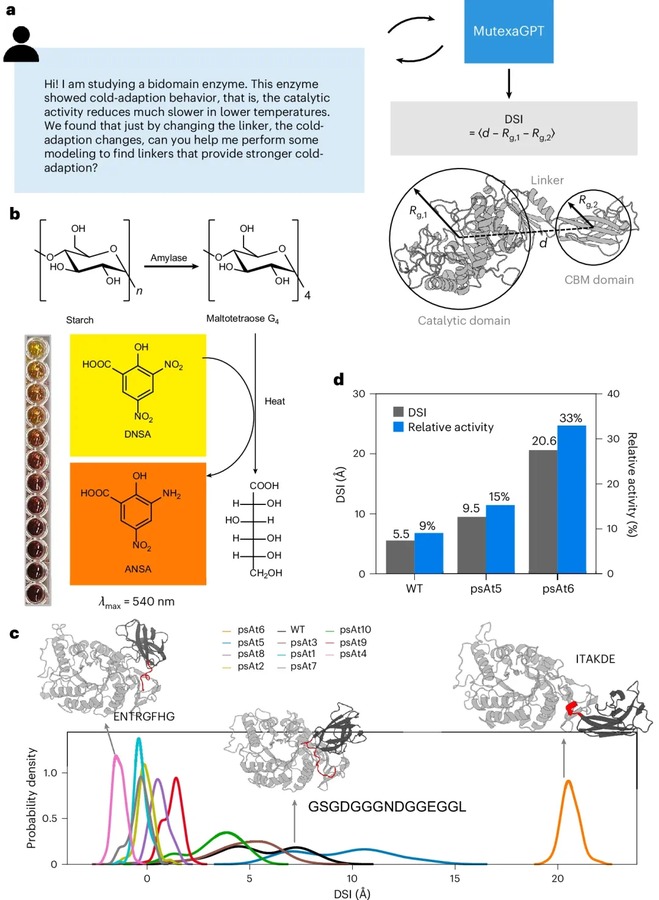
结果很清楚。两种突变都优于野生型。
原始研究进一步显示,表现最好的变体在 0℃ 下拿到了最高的活性指标。这个数字是野生型的 3.7 倍。
这些结果指向同一件事。这套系统能把统计上的直觉,转成基于物理的模型。它还能和实验流程接在一起,做出适应低温的酶工程。
离真正的协作者还有一段距离
作为一种协作型智能体,它并不是能直接预测酶催化性能的万能模型。
它依赖的是一些可以计算的替代指标,比如活性口袋体积。结构域间距算一个,结合能也算一个。这些指标能算,但都只是替代品。
替代指标和真正的催化功能之间,并不存在简单的一一对应关系。这一层没那么简单。
现有的语言模型仿真工具大多停留在助手层面,目的是简化领域专家的分子建模流程。它们只是帮手。
相比之下,这套系统具备了一些通常只有协作者才该有的功能。
对几乎没有计算建模经验的蛋白质工程师来说,它仍然是一个辅助级系统。但它有成为酶工程协作者级智能体的可能。
这个定位其实挺务实。与其把模型说成万能,不如先把它能算的那部分算准。宁可多花时间在替代指标的可信度上,也别急着承诺直接给答案。
差距就摆在这里。从助手走到协作者,中间隔着的是对物理真实性的把握。
AI工具 这条赛道上,能真正落地的东西,往往都长这样。
