

端侧的账,越来越算不过来
越来越重的 AI 计算,正在从云端往下挪。
本地跑 AI对话 应用。本地跑 Agent。同时还要处理画面和语音,还有各种传感器的数据。
这些活原本都在服务器上干。现在开始交给手机和车机,也交给机器人。
做得越多,最后都要落到同一块芯片上。这笔账不好算。
围绕 AI 能力怎么融进芯片,Imagination 两条路都走过。
这家公司做图形处理器架构三十多年。在卷积网络主导端侧视觉任务的时期,它试过两条路。既让图形处理单元参与 AI 计算,也单独做过神经网络加速器。
后来他们发现,专用硬件的账越算越不划算。
模型在变。算子在变。软件生态也在变。每一样变了都得重新适配,长期投入收不回来。
于是 AI 战略重心又收回到通用性更强的图形处理器上。
在最新 E 系列的产品展示会上,首席营收官 Jake Kochnowicz 讲得更直白。他说真实部署里,软件的成本甚至可能比硬件更大。
这也解释了 E 系列的产品思路。
它强化了矩阵乘法这类基础运算,低精度计算和卷积运算也跟着加强。一边接住新的 AI 负载,一边继续押注图形处理这个老本行。
公司首席执行官 Markus Mosen 的总结是另一句话。
把图形、计算和 AI 整合进一个可编程架构。芯片设计厂商拿到的是一块平台型处理器,可以长期构建,也可以持续演进。
换句话说,E 系列真正想验证的不是某一个指标能跑多高。
它想验证的是另一件事。当一块图形处理器开始接越来越多 AI 任务,能不能靠同一套硬件和软件把算力用得更省。
数据也少搬一些。省下来的都是功耗。
帧率先归图形处理器自己管
AI 能力强化之后,用户最容易感知到的变化,还是发生在游戏里。
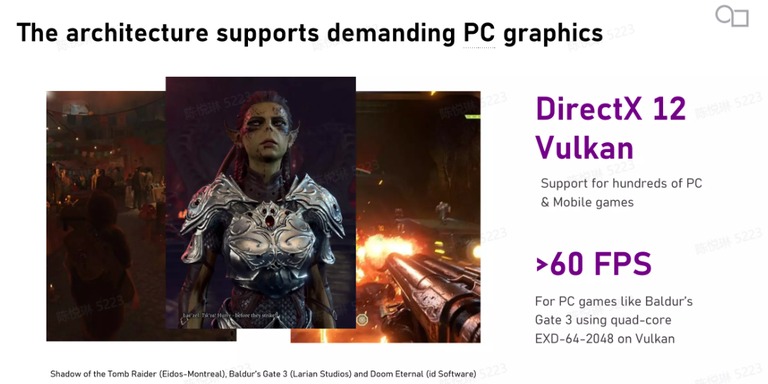
四核的 E 系列,能让部分 3A 级桌面游戏的帧率超过 60 帧。
提帧率的一条路径,是给传统渲染减负。
E 系列加进了一颗神经核,用 AI 超分来完成这件事。原来要画高分辨率画面,就得直接生成更密集的像素信息。
换成超分的思路,图形处理器可以先按较低分辨率渲染,再由神经网络把画面重建回来。
按 Jake Kochnowicz 的说法,传统的异构做法要分两个单元。图形处理器管渲染,神经网络处理器管超分。
画面得先写进共享内存。
再由神经网络处理器读出来处理。处理完再写回去。
E 系列让同一个单元同时承担图形计算和矩阵运算。这一段来回搬运就省掉了。
往里再看一层,这家公司把矩阵计算能力整合进了原有的着色器执行体系。
图形计算产生的数据可以就近进入矩阵运算。两类计算单元之间的最后一公里被打通。
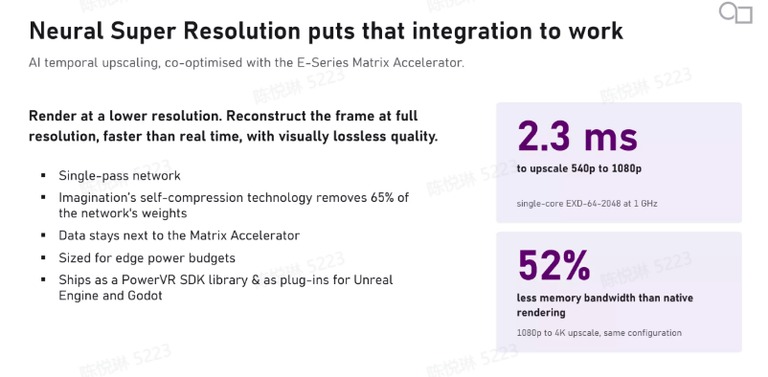
硬件之外还有算法。依靠自研的压缩技术,这套神经超分辨率算法在单次神经网络处理里能减少一半以上的权重。
模型要存和要读的数据量跟着降下来。
效果落在具体场景里。单核 E 系列把画面从 540p 拉到 1080p,只用了 2.3 毫秒。
同样配置下继续拉到 4K,带宽消耗最高降低 54%。帧率最高能到对照结果的 2.5 倍。
这样的表现也和 E 系列继续沿用的分块延迟渲染有关。
它先把屏幕拆成大量小块逐块渲染,让更多中间数据留在片上。整帧一次性展开的老办法做不到这一点。
分块思路还能和 AI 能力叠在一起。同一块区域里的图形处理和神经网络处理接连做完,中间结果就不必反复进出外部内存。
数据搬运被反复提起。一头连着用户对低延迟的要求,另一头连着边端设备最在意的功耗。
E 系列对图形处理器内部的算术逻辑单元也做了改造。把这些运算组织成连续的一组工作交给它,中间结果尽量留在计算单元内部。
这位首席营收官把思路概括成一句话。最大化数据复用,最小化不必要的数据搬运。
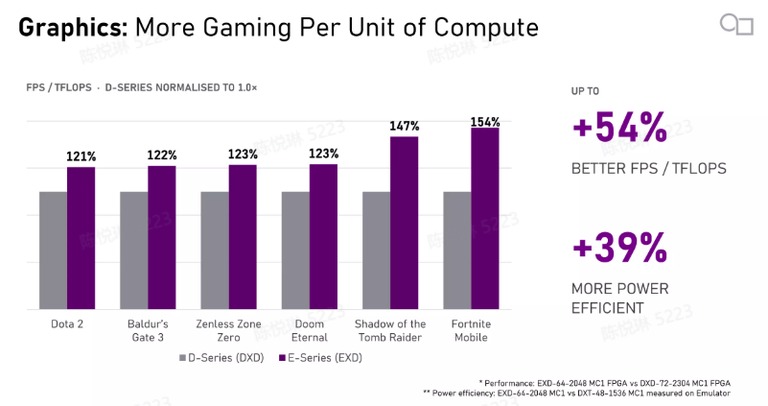
按他的说法,由此带来的每瓦性能提升最高到 39%。
慢就慢在搬运上。
低位宽进场,预填充快了 4.7 倍
除了游戏里的 AI 超分,E 系列的算力还瞄准了当下最热的负载,也就是智能体应用。
智能体干活的背后,大语言模型推理仍然是核心。
模型推理分两段。预填充阶段决定首词延迟。解码阶段决定每个词的输出时间。
两段的任务模式差别很大,目标却是同一个。让词元尽可能快地吞吐出去。
E 系列的低精度矩阵计算能力,恰好能同时服务这两段。
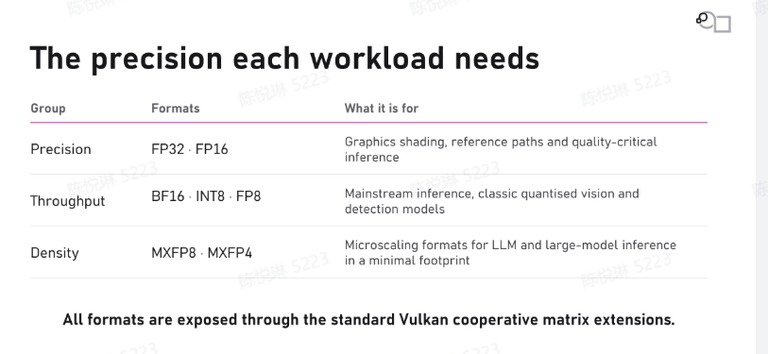
按这位首席营收官的说法,E 系列第一次引入低精度格式。MXFP8 和 MXFP4 就是大模型推理常用的那两种。
位宽降下来,矩阵运算的吞吐就能提上去,预填充处理输入的速度跟着变快。
这家公司测算,相比上一代产品,E 系列在这个阶段的表现提升了 4.7 倍。
量化之后,模型权重和部分中间数据占用的字节数也在下降。每一步要读的数据变少,解码阶段的带宽压力随之缓解。
当然,系统实际能给多少带宽,最终还得看内存、控制器和芯片的整体配置。
E 系列通过高级可扩展接口接入芯片的内存子系统。低功耗内存、图形内存和高带宽显存这三类都能适配。
最高可以消耗 768GB/s 的读取带宽。
语言模型之外,智能终端上跑的 AI小工具 还要处理文字和图像,也要处理语音与传感器信息。
矩阵运算仍然重要。但视觉识别、感知和图像处理这类多模态任务,还会涉及另一项基础运算,那就是卷积计算。
E 系列同步提升了这块能力,性能是上一代的 4.4 倍。
图形处理器还是需要一个搭子
从语言模型到多模态任务,E 系列留足了通用性。
具体到不同模型,开发者仍然要针对算子、精度和执行方式继续调优。
目前开发者可以用 OpenCL 和 Vulkan 写计算内核。再往上是 Llama.cpp 这类推理框架,还有 ONNX 与 PyTorch 这些更上层的生态。
模型还在演进。这家公司希望靠跨代统一的软件栈,让这些优化能继续迁移和复用。
每换一代硬件就要从头再来一遍,那是所有人都不想要的。
这类 AI工具 想在端上跑得稳,光有一块能打加速的芯片并不够。
当图形处理器能接的 AI 任务变多,软件上的连续性又会反过来影响芯片里的分工。
这位首席营收官观察到,一些嵌入式客户已经在问同一个问题。图形处理器能不能接手一部分原本交给神经网络处理器的活。
这样就不必为另一类加速器单独开发软件,再长期维护。
但有些话还是得说清楚。不同任务仍然有各自更合适的计算单元。
他拿 Agent PC 举例。中央处理器负责驱动图形单元和神经网络单元,协调工具调用,管理数据和任务流程。
真正进入模型计算之后,再由图形处理器或者其他加速单元承担。
到了自动驾驶和机器人这类更复杂的终端里,图形处理器同样只是异构系统里的一环。它还得和感知、控制及专用计算单元配合。
E 系列已经为这种分工做了准备。
用硬件邮箱传递状态和指令。通过共享内存减少重复拷贝的数据,也缩短任务从一个处理器切到另一个处理器的等待时间。
客户还可以把图形软件集成进自己的开发套件。再由系统软件根据任务特点去调用不同的计算资源。
与其让一块芯片把所有活都揽下来,不如让每一类计算单元只做自己最擅长的事。
宁可先把图形和推理这两摊活在同一块处理器上跑顺,也别急着替掉旁边那颗神经网络单元。
在对的时间用对的处理器,出对的结果。
这大概就是 E 系列押注图形处理的本质所在。
