

养宠物的人大概都遇到过这种时刻。
猫把耳朵压成飞机耳,你分不清它在生气还是在撒娇。
狗趴在地上一动不动,你也不知道它是累了还是难受。
一项来自 Kaggle 的实验想解决这个问题。
思路很直接。让机器去看脸。
实验用了 1000 张宠物面部图像。
里头有狗、猫和兔子。仓鼠和绵羊也在。马和鸟同样收录。
表情分成四类。开心、伤心和生气。剩下一个兜底的其他。
每类正好 250 张,数量齐平。
最后交出的答卷是测试集准确率 96.25%。
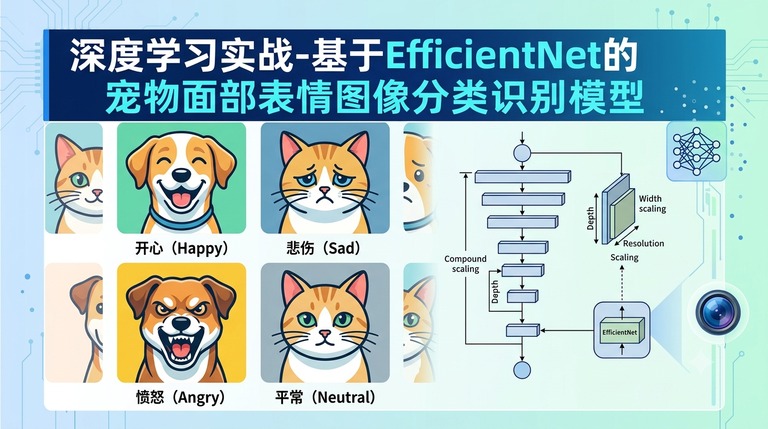
原文的封面配图
一、为什么要让机器读懂宠物的脸
家里养宠物的人越来越多。
宠物早就不只是玩伴,更像家庭成员。
可人和动物之间隔着一层语言,主人只能靠经验去猜。
猜错了还可能耽误事。
宠物反常或者痛苦,往往要等很久才被发现。
人脸识别这条路已经走得很成熟。
把 AI图片 识别的本事挪到动物身上,就成了一个新方向。
用算法去量化狗、猫和兔子脸上的微表情。
这件事的价值不止在家庭。
宠物智能硬件需要它。动物行为学研究需要它。
动物福利救助同样需要一把客观的尺子。
数据来自 Kaggle 的宠物面部表情数据集。
1000 张图,覆盖七种动物,四类表情标签。
数据集还给了两个应用方向。
一个是靠表情判断情绪,另一个是识别宠物种类和品种。
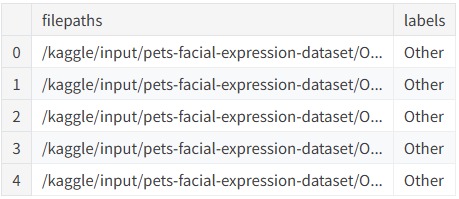
导入数据后得到的两列表格,左边是图片路径,右边是标签
二、一千张图,先切三份
代码跑在 Jupyter notebook 里,语言用 Python。
做这类 AI编程,技术栈基本是标准配置。
图片读取交给 OpenCV。数值和表格交给 NumPy 与 Pandas。
画图交给 Seaborn 和 Matplotlib,想交互再看 Plotly。
建模则用 TensorFlow 和 Keras。
第一步是把图片路径和标签读成一张表。
遍历数据集目录,跳过重复的母文件夹。
每张图的绝对路径进一列,类别名进另一列。
最后拼成两列的表格,前五行先打印出来看一眼。
切分用的是两段式。
第一步分出八成做训练集,剩下两成当临时集。
临时集再按六四拆开,得到验证集和测试集。
算下来训练集占八成,验证集占一成二,测试集占八成。
规模不算大,但对 1000 张的体量够用。
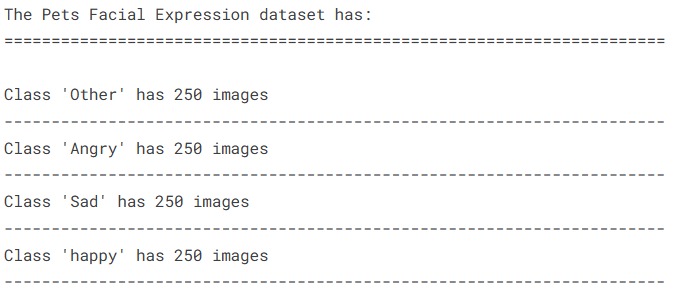
划分完成后打印的统计,四个类别各 250 张
三、先让数据变多,再谈训练
一千张图要撑起一个深度网络,样本偏少。
靠的是一套数据增强流水线。
旋转幅度开到 40 度。横向纵向各平移两成。
亮度在 0.4 到 0.6 之间抖动,缩放幅度三成。
水平翻转和垂直翻转同时打开。
增强不是越多越好。翻转和亮度先开,位移幅度别给太大。
原文作者插在这里的一张梗图,提醒先看看数据本身长什么样
输入尺寸统一裁到 224 乘 224,这是主干网络的标准口味。
批次大小定 16,通道数 3。
测试集另算一个专属批次,取能整除样本数又不超过 80 的最大值。
这样评估时不多不少,刚好走完一轮。
生成器一共三个,训练、验证和测试各一个。
训练与验证打开乱序,测试集必须关掉。
否则预测顺序和真实标签对不上,后面的混淆矩阵全乱。
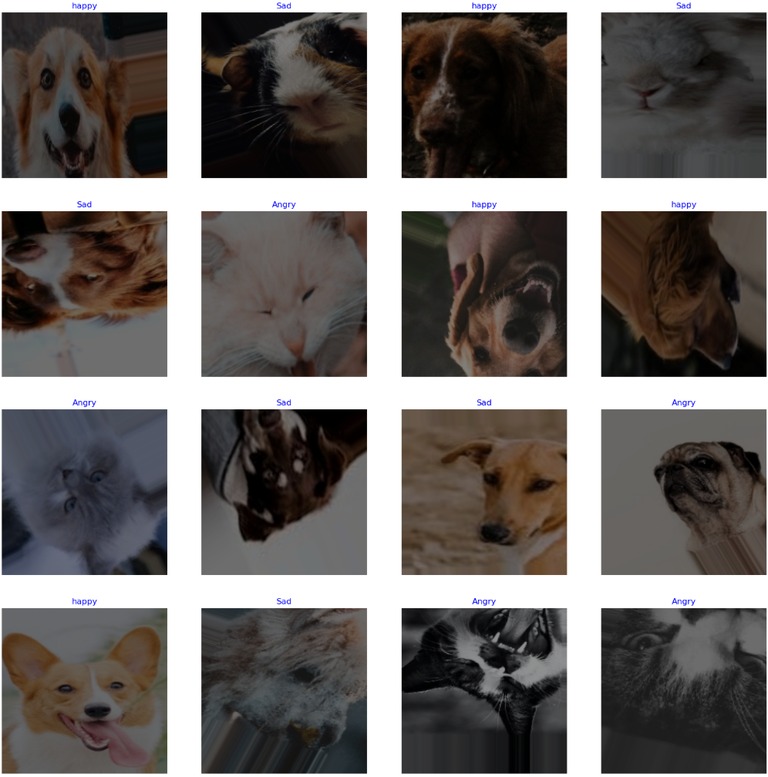
增强后的一个批次,16 张表情图连标签一起展示
四、主干网络是借来的
建模用的是迁移学习。
主干选了在 ImageNet 上预训练过的 EfficientNetB5。
理由很实际。预训练权重已经把通用视觉特征学完了。
用法分三步。
第一步是去掉原来的分类头。
第二步把主干全部冻结,不让它在这一轮里更新。
第三步往上堆自己的输出结构。
新加的层一共四层。
先来一层批量归一化,让训练更稳。
接一个 256 个神经元的全连接层,激活函数用 ReLU。
再加一层随机丢弃,丢弃比例 45%。
最后是输出层,神经元个数等于类别数,用 Softmax 转成概率分布。
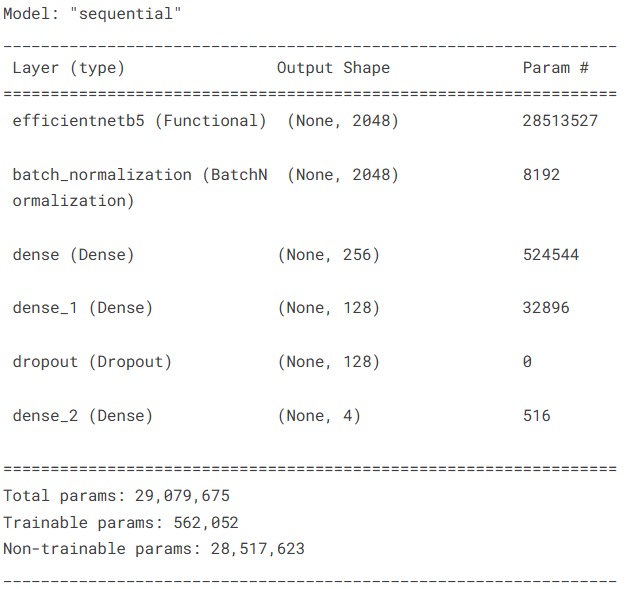
打印出来的模型结构,主干参数全部处于冻结状态
五、两个刹车,防止白跑一百轮
训练配了 Keras 的回调机制。
第一个是早停。
它盯住验证集准确率,连续 5 轮不涨就提前收工。
同时把最优权重恢复回来,不会把最后一轮的坏状态留下。
第二个是分阶段学习率衰减。
每过 10 轮,学习率砍掉一半。
前期步子大,后期步子小。
最多跑 100 轮,批次保持 16。
日志里第 94 轮的损失已经落到 0.43 附近。
验证准确率稳定在 93% 以上,曲线开始变平。
早停没有触发,训练自己走完了全程。
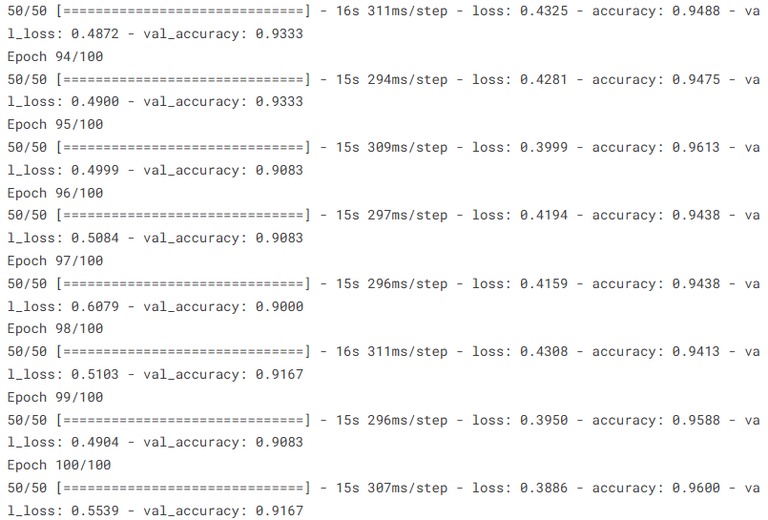
第 94 轮的训练日志,损失和准确率已经趋于稳定
六、成绩单:从曲线到底层分类
训练过程最先看曲线。
从 history 里取出四条数据。训练准确率一条,训练损失一条。
验证准确率一条,验证损失一条。
再找出验证损失最低和验证准确率最高的位置。
在图上用蓝点标出来。
曲线摆在一起,过拟合和欠拟合一眼能认。
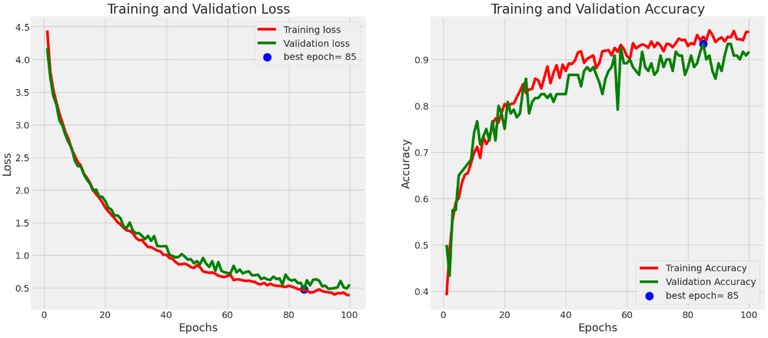
上面是损失曲线,下面是准确率曲线,蓝点标出最优轮次
接着用评估函数把三个数据集都跑一遍。
为了口径一致,全程用同一个测试步数。
跑完的结果是训练集损失 0.3353,准确率 100%。
测试集损失 0.4082,总体准确率 96.25%。
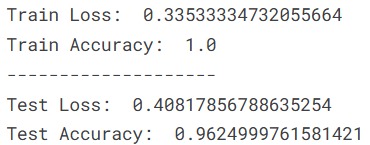
控制台打印的最终指标,训练集与测试集同框
再看分类细节,就要请出混淆矩阵。
总准确率好看,不代表每个类别都稳。
图省事只看总分,等于放弃了找病因的机会。
纵轴是真实标签,横轴是预测标签。
格子里的数字是样本数量,颜色越深代表越多。
对角线上全是正确答案。
对角线之外落下的点,就是这个模型容易认错的组合。
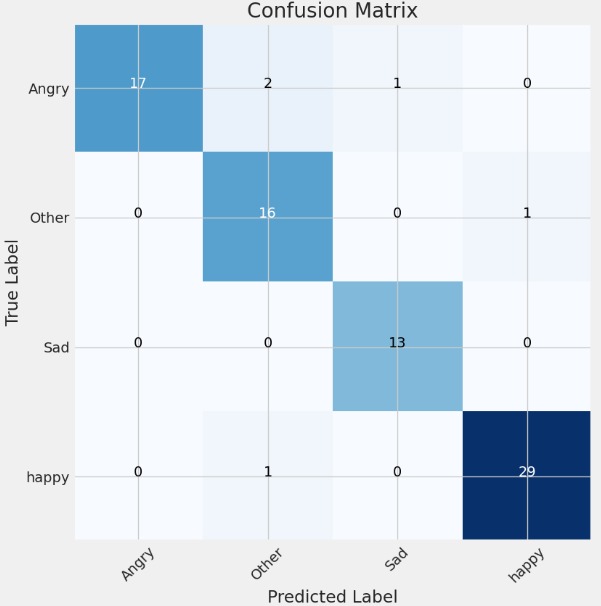
混淆矩阵热力图,对角线之外几乎没有落点
最后跑一份分类评估报告。
每个类别单独列出精确率、召回率和 F1 分数。
生气这一类,精确率到了 100%。
伤心这一类的召回率同样是 100%。
开心类别的召回率是 97%。
连最模糊的其他类,识别水准也保持得相当稳。
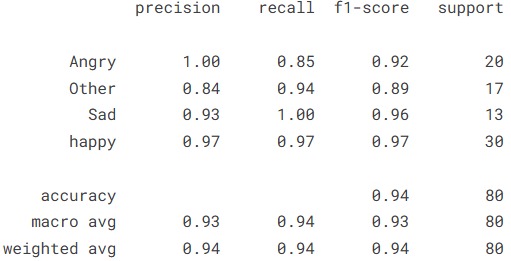
逐类别的分类报告,四个类别的指标都在九成以上
七、给一张没见过的脸
评估再漂亮,也要落到单张推理上。
作者写了一个通用函数,输入图片路径,输出预测结果。
流程固定。第一件事是把图裁到 224 乘 224。
第二件事是转成矩阵,再补一个批次维度。
归一化交给主干自带的函数。
模型做一次前向传播,得到四类的概率分布。
最后取概率最大的那一类。
函数里还埋了一个小设计。
如果结果是其他类,标题就显示正常。
其余情况直接显示具体情绪。
加载最优权重之后,作者拿了四张不同情绪的图来验收。
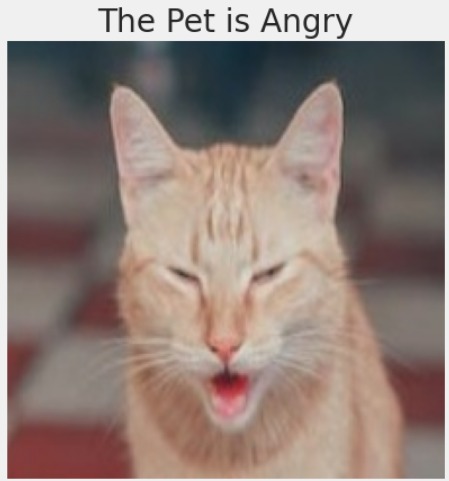
输入一张生气的图,模型给出的标签是生气
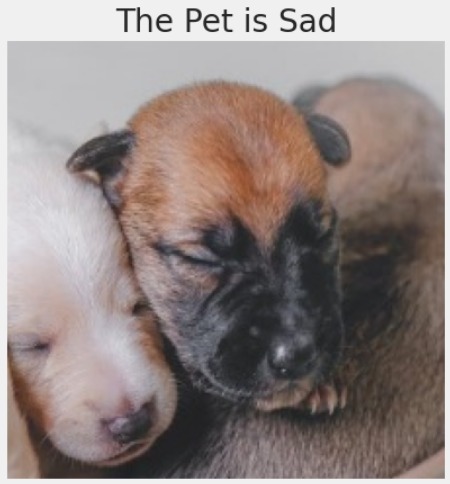
输入一张伤心的图,模型识别为伤心
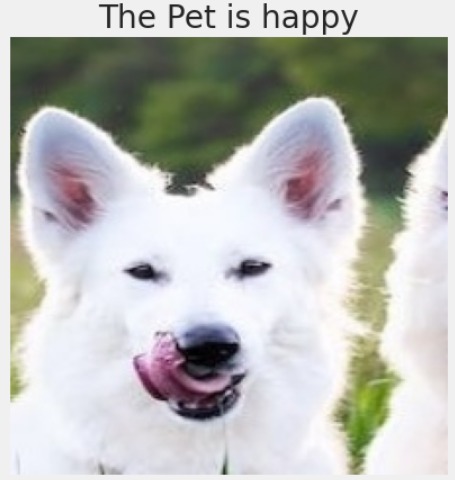
输入一张开心的图,模型识别为开心
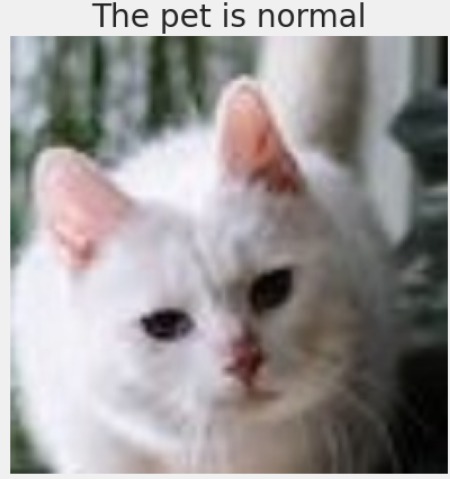
输入一张常态表情的图,模型显示宠物状态正常
八、写在最后
整套实验的骨架不算复杂。
1000 张图片,一次两段式切分,一个借来的主干网络。
加上早停和学习率衰减,几十行配置就撑起来了。
测试集 96.25% 的成绩说明,迁移学习在小数据集上依然能打。
局限同样清楚。
样本只有 1000 张,表情只有四类。
训练图大多是摆拍式的正面脸部特写。
宁可多收几百张真实场景的图,也别指望靠调参把这部分补回来。
真到了家里,光线和角度全是变量,稍微挡一下脸结果就可能变。
想上宠物智能硬件,数据规模还得往上翻几倍。
不过方向已经验证过了。
让机器读懂宠物的脸色,这件事不再是设想。
对普通养宠人来说,将来也许就是一个顺手的 AI工具。
摄像头拍一下,手机告诉你它今天心情如何。
对动物行为研究来说,这是一把可以重复使用的量尺。
情绪很难被精确描述。但表情可以。
