

一款国产新旗舰模型,刚刚交出了性能成绩单。
9 月 20 日,阶跃星辰发布新一代旗舰模型 Step 5 Preview。这是它最新的 MoE 架构产品,面向真实世界的智能体任务打造。总参数 6000 亿,激活参数 270 亿。上下文窗口开到 100 万词元。文本能读,图也能看。
它在一个全球 AI 榜单里拿到 44 分。这个榜单叫 Artificial Analysis Intelligence Index。44 分的成绩位居开源模型第三。排在它前面的两款开源模型,分别是 Qwen3.8 Max 和 GLM-5.3。
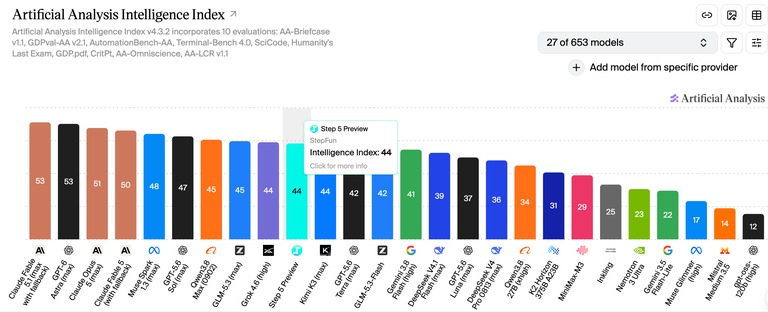
按阶跃公开的基准测试结果,新模型在多项评测里都能打。智能体长周期命令行任务,它赢过 Kimi K3 和 GLM-5.3。金融投资研究评测 FrontierFinance 也是。跨领域深度研究评测 DRACO 同样如此。它只略逊于 GPT-6 Astra 和 Claude Opus 5。
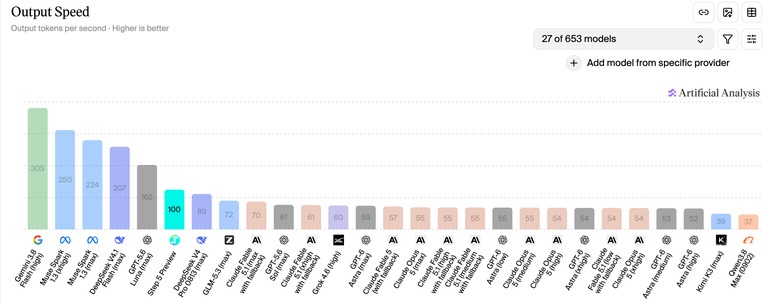
榜单同时给出了输出速度。这款模型的输出速度为每秒 100 个词元。这个速度排在第 6 位。
成本是最受关注的一项。据阶跃官方数据,新模型的单任务成本只有 Claude Opus 5 的八分之一。同一份榜单的数据显示,前者单次总开销 0.71 美元。折合人民币约 4.76 元。后者是 5.86 美元。折合人民币约 39.25 元。

价格表也已经公开。每百万词元输入价(缓存未命中)7 元。输入价(缓存命中)0.35 元。输出价 20 元。对比来看,这个价位可以对标 DeepSeek-V4-Pro-0813。那款模型的高峰时段定价也在这条线上。

体验之后发现,新模型擅长理解复杂任务,也擅长分步骤落地执行。文档转 PPT 和视觉网页不在话下。3D 交互与模拟推演这类真实工作场景,它也能接住。图片、文字和 3D 模型混合的复杂需求,它可以独立输出可用结果。
文档转 PPT 这类需求,恰好是很多 AI办公软件正在抢的方向。这是它的强项。但在视觉设计要求更高的场景里,它给出的产出缺少多元化视觉素材。用户得自己介入,反复补迭代指令,才能拿到更理想的设计效果。
目前 Step 5 Preview 已全量开放。正式开源定在 10 月 15 日。
一、实测四大案例:博客一键变 PPT,7 轮模拟经营后直出可交互复盘网页
这次实测盯的是三件事。多轮长任务能不能跑完。抽象提示词能不能读懂。原生视觉能不能用上。大部分任务一次输出就能完成。
第一个案例是把博客链接上传,让它直接生成面向非技术人员的 PPT。整个 PPT 内容重点明确,风格也统一。关键数据有突出显示。每页下方还为演示者划了重点。
不过有一点不足。PPT 的表现形式都集中在文字的样式和大小上。图表和配图等多元化设计没有出现。

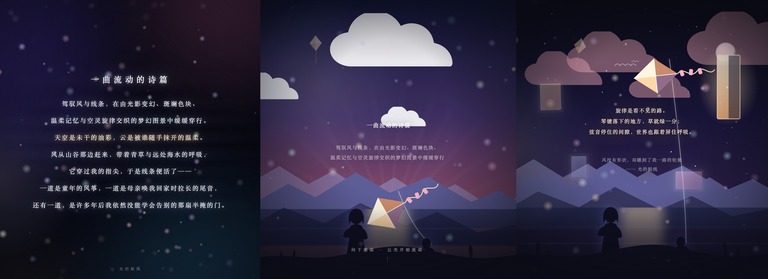
第二个案例贴着抽象提示词来做。上传的提示词是一句“一曲流动的诗篇”式的描述。新模型先自己拆解需求。接着把提示词扩写。然后生成对应的视觉网页。
网页初版的背景比较单调。只有鼠标划过位置会产生光晕。进一步要求背景更具设计感,还要结合文字内容的元素。重新生成的页面里,文字会随鼠标滚动出现。背景的色调和元素也跟着文字变。
第三个案例更花哨。新模型要用 Three.js 开发一个网页应用,场景是卡帕多奇亚热气球。要求加上不同的交互按钮,互动要流畅。
从一次生成的效果来看,整个画面基本符合需求。功能框里可以调整风向和日照时间。热气球数量也能改。效果实时可见。
最后一个案例更复杂。这一次是模拟经营一家新式茶饮小店。
新模型扮演创业模拟智能体,自己进行分步规划。整个经营过程被划分为 7 轮。
- 商业模式与选址策略
- 选址落地与证照办理
- 产品体系与定价策略
- 供应链搭建与首批备货
- 装修动线与设备采购
- 开业引爆与人员就位
- 终局报告
在模拟过程中,新模型每一轮都会提出多个方案。每个方案的详细内容会同步输出。它还会给出决策核心要素和建议,话说得很直接。选定方案之后再往下推进。
与此同时,理由也会被记住。当理由被描述成“想找投入最少的方案”时,新模型会在接下来的多轮决策里基于此提建议。

最终按模型估算,这家茶饮小店可以达成月净利 2.5 万元。账户留存现金 18.6 万元。同时积攒了 1450 名排队等候的学生客群。

最后,新模型还能把前述所有决策流程生成一个交互式产品。所有方案的侧重点和可复用结论,都会被总结提炼。

二、22 小时优化 GPU 内核,峰值性能提升到 508 TFLOPS
阶跃官方也放出了不少案例。
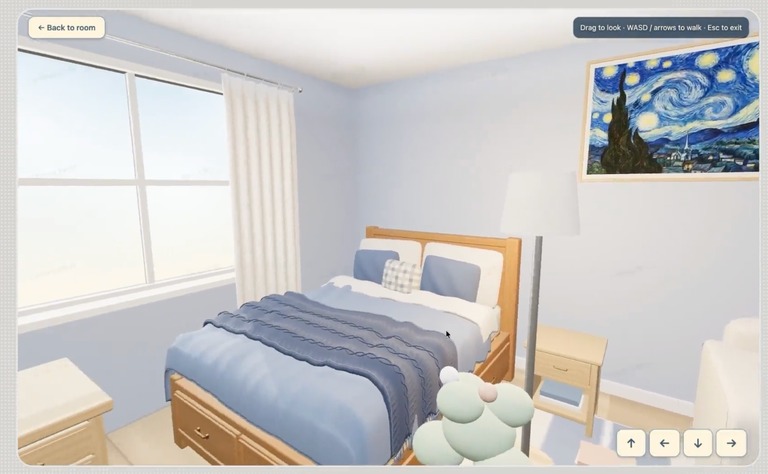
在真实软件工程方面,新模型可以做 Web 开发和视觉设计。下面这个案例,是它基于一张照片生成的可编辑 3D 环境。用户可以带着摆放反馈移动和旋转家具。也可以换成第一人称视角参观房间。
第二个案例是基于历史资料构建的交互式历史图册。它以一本 1922 年的旅行指南为基础,用路线和车站重建九广铁路。行程规划与票价计算也一起做了进去。档案资料的呈现形式因此更生动。
在长程任务执行中,阶跃选了两个场景。一个是优化 GPU 内核,一个是优化训练数据流程。
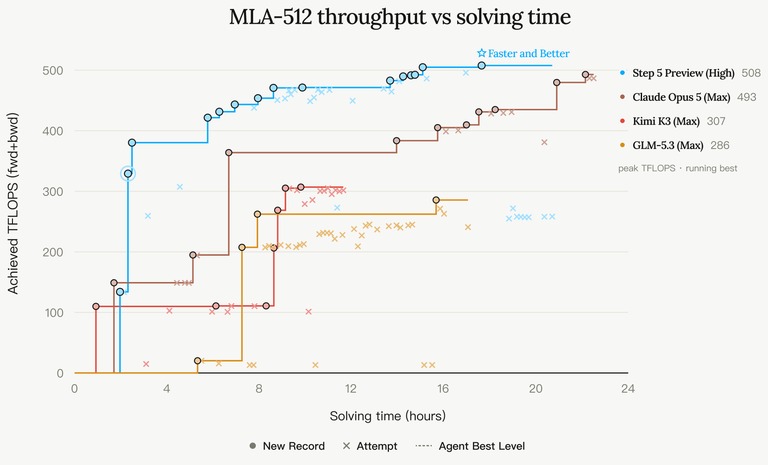
先看内核优化。任务是在一张英伟达 H100 显卡上,从零开始优化一个 MLA 内核。时间限制是 24 小时。它自主修改并运行内核,同时测量吞吐量。经过约 22 小时,峰值性能提升到 508 TFLOPS。这个数字超过了 Claude Opus 5 的 493 TFLOPS。
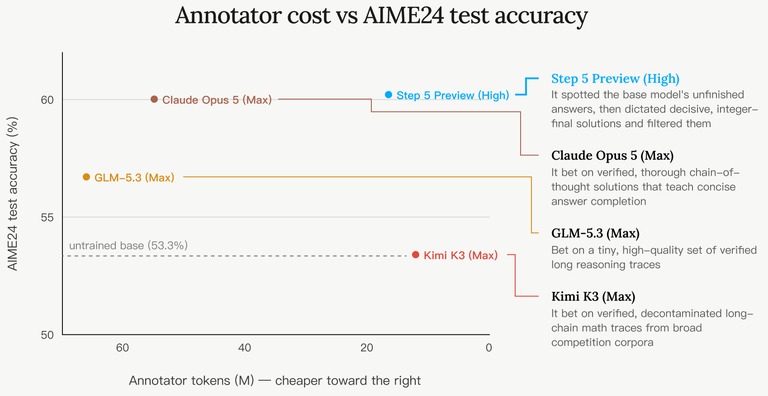
再看后训练数据流程。同样是 24 小时。新模型用自动化后训练,提升了一个基础模型在 AIME24 上的表现。这个基础模型叫 Qwen3-30B-A3B。经过后训练,它在 AIME24 官方测试集上的准确率从 53.3% 涨到 60%。这个成绩与 Claude Opus 5 持平。消耗的词元还更少。
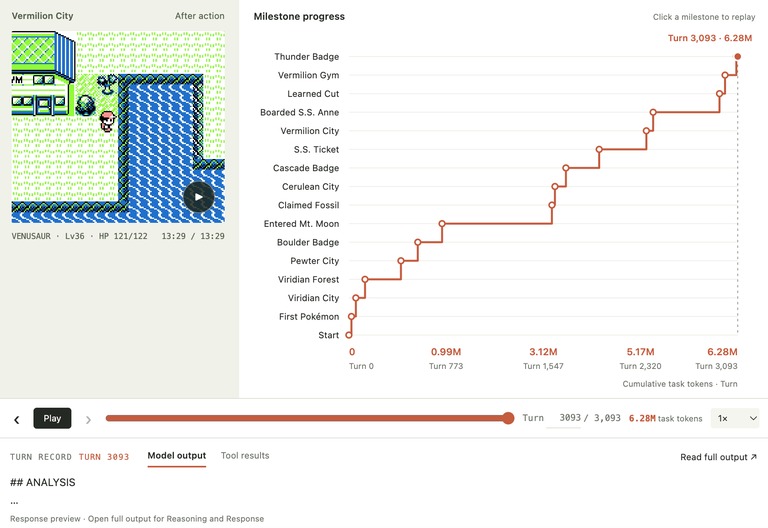
除了编程,新模型还在《宝可梦红》游戏里做了一次长程考验。它没有做专项优化,却持续完成超过 3000 个回合。累计交互接近 600 万词元。
这个游戏的难点在于目标拖得很远。模型要记住之前获得的信息。资源也要管理。相互依赖的任务还得完成。原有计划行不通时,它得重新调整。对人类玩家来说,完成主线通常要花约 26 小时。
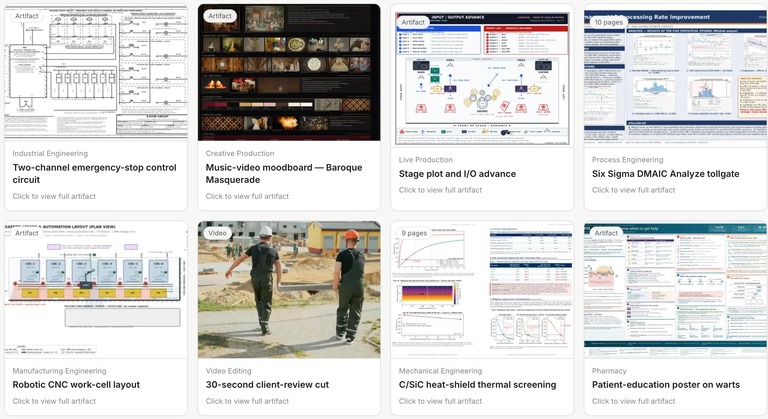
此外,新模型还可以做大规模研究、结构化分析和交互式报告。
三、智能体长周期任务优于 Kimi K3,真实设备调试也能接手
第三方和内部基准测试里,阶跃给新模型找了四组对手。GPT-6 Astra 与 Claude Opus 5 算第一梯队。Kimi K3 和 GLM-5.3 做对照。
同样的旋律又出现了一次。这几项测试中,它都胜过 Kimi K3 与 GLM-5.3。只有 GPT-6 Astra 或 Claude Opus 5 排在前面。

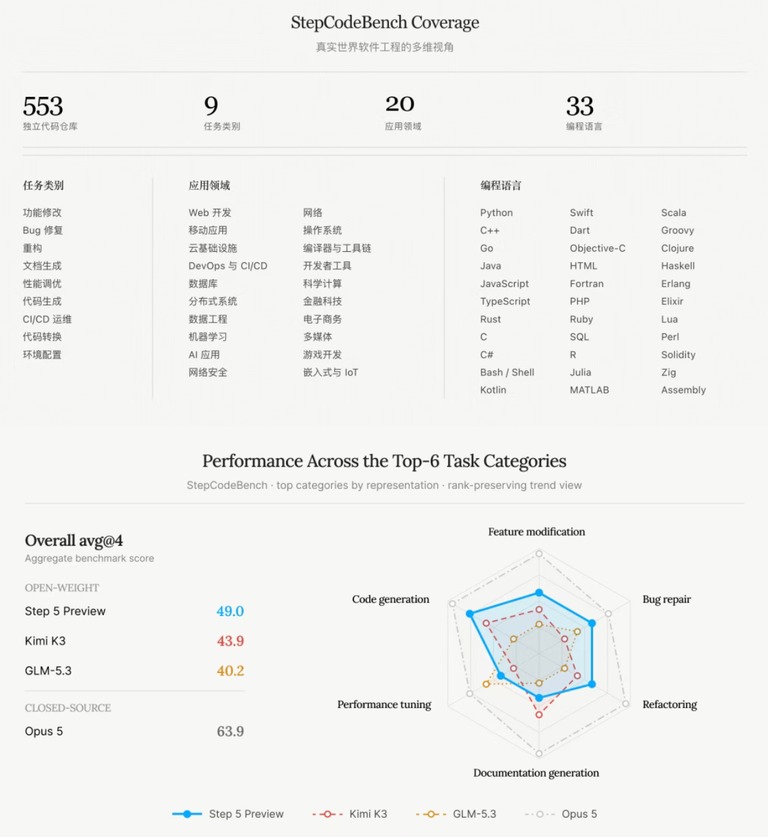
在真实任务场景,阶跃内部构建了测试集 StepCodeBench。AI编程领域的评测向来卷。这个测试集覆盖 553 个独立代码仓库。任务类型有 9 类。它涉及 20 个应用领域与 33 种编程语言。基于这个评测,新模型的综合得分为 49 分,超过了 Kimi K3 与 GLM-5.3。得分看的是整体任务成功率和跨场景稳定性。
按阶跃博客的信息,拿到开发文档和用户授权之后,新模型能直接调用相机和 COM 端口。它也能截图。还能模拟鼠标输入。设备侧的开发与调试因此可以自己完成。
下面这个案例里,新模型连续工作超过 3 小时。它根据设备反馈不断编写、运行并修改代码。按自然语言需求,它自己读完了 ESP32 设备及相关开发文档。然后是动手改。一块 ESP32-S3 开发板被它改造成能蓝牙按键、能语音输入的编程键盘。
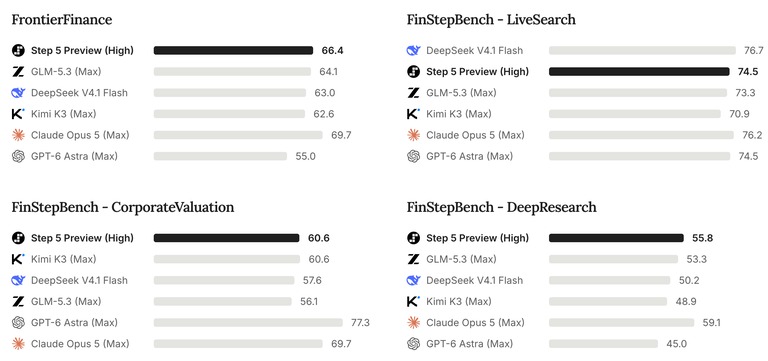
金融领域也没有落下。阶跃构建了三项内部测试。考的是三件事。模型有没有扎实的金融专业知识。它能不能建立跨行业之间的因果联系。信息不完整和数据口径不一致的时候,它能不能靠工具做出严谨分析和建模。
再加上,新模型在信息检索和估值上得分较高。完整研究流程也是。在外部基准测试 FrontierFinance 中,它的得分仅次于 Claude Opus 5。
结语:大模型竞赛从算力军备赛转向算力转化率之争
阶跃在博客里提到,过去大模型 Scaling 的核心逻辑很直白。用更多计算换取更强智能。但随着模型规模和任务复杂度持续增长,计算成本也被同步放大。Scaling 的关注点因此变了。如何更高效地把计算转化成模型能力,成了新的核心。
这也是它一直在探索的问题。从 Step 3.5 Flash 到 Step 3.7 Flash,再到 Step 5 Preview,答案一直在变。它认为,下一阶段的 Scaling 不只是更多计算,也包括更高效率的计算。
可以看出,未来大模型竞赛的核心不只是原始算力的军备竞赛。算力转化率同样关键。谁能用更少的激活计算,输出更强的真实世界任务能力,谁就更适配智能体时代的落地趋势。效率已经成为大模型的核心命题。对普通用户来说,这类 AI工具 的价值不在跑分,而在它能不能一次把活干完。
