智谱把一件挺微妙的事摆到了台面上。GLM-5.3 这次做的事,不只是写几段代码。它亲手把自己跑起来的那套推理系统,从零搭了出来。
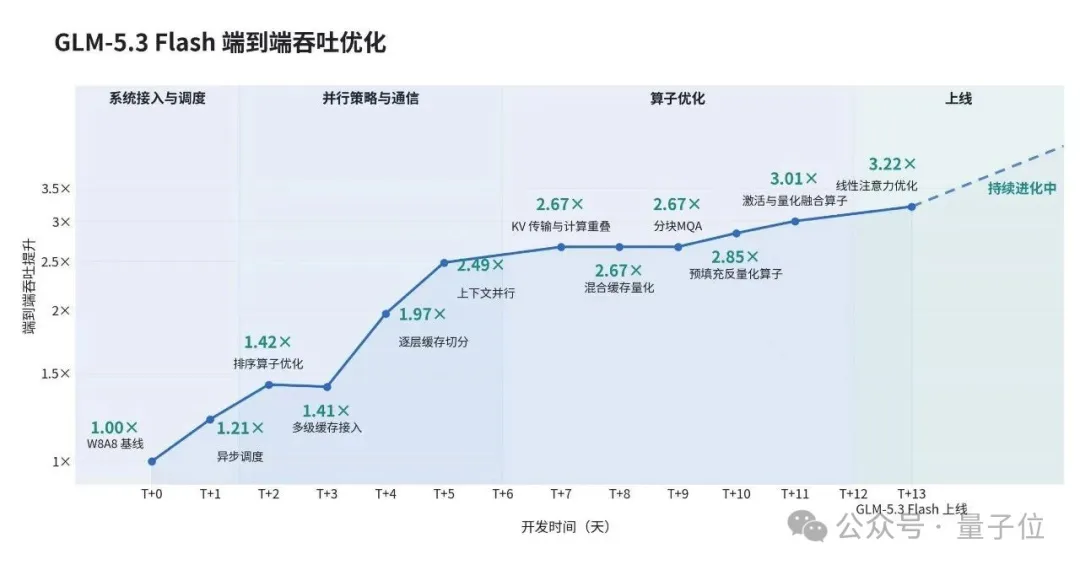
唐杰是清华大学计算机系教授,也是智谱创始人。他分享了团队内部观察到的这个早期案例。集群上有超过 10 万张国产芯片。GLM-5.3 驱动的 Infra Agent 从零参与搭建。它还顺手把这套生产级推理系统优化了一遍。不到两周,端到端吞吐涨到最初基线的 3.2 倍。

关键的地方不在智能体会写代码。算子精度的坑,Python 和 C++ 之间的跨层并发瓶颈,内核性能的天花板,它都能自己碰上。碰上之后它读系统反馈,提假设,改代码,跑实验。再看着结果继续迭代。
唐杰把它压成了一句话。模型优化系统,系统承载模型。
让它跑起来的不是更聪明的模型
推理系统优化最缺的其实不是工具。测试和日志一直都在,性能分析和微基准也是。麻烦在于它们散落在不同的工具里,也散落在不同的工程阶段里。
有经验的工程师会顺着一次压测结果往下摸。先看算子输出,再看执行时间线,再看通信事件和线程状态。他把不同工具给的信息串起来。判断就出来了。同一套动作放到智能体身上,如果这些观测和验证手段没有被组织成能反复执行的工作流,它拿到的反馈依然是稀疏的。
智谱的做法是把正确性测试和运行日志接进智能体的迭代流程。执行追踪和运行时事件也一样,微基准和端到端指标同样没落下。整个优化过程被拆成可以单独观测和验证的环节。
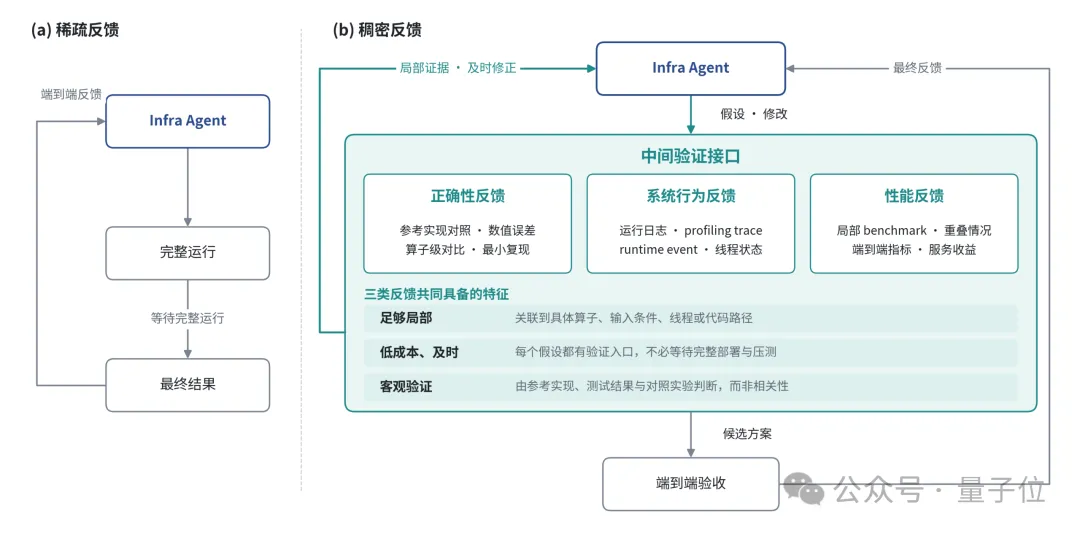
他们给这种做法起了个名字,稠密反馈。稠密这个词不是说往智能体里灌更多日志和指标。它指的是反馈要同时满足三件事。
反馈得足够局部。它能落到具体的启动参数上,也能落到某段被改动的代码、某个算子或者某个输入条件上。丢一句“引入融合优化后模型精度下降”,智能体很难下手。定位到某个具体请求在优化前后的输出差异,它才有可能构造出最小复现。
反馈得便宜,还得及时。能靠算子测试或者局部微基准回答的问题,不必每次都等完整服务部署和端到端压测。验证周期短,智能体才不会在一个错假设上耗太久。
反馈还得能被客观验证。运行信号可以帮智能体提出候选原因,但确认根因要靠控制变量的对照实验。现象之间的相关性不算证据。
围绕这个思路,GLM-5.3-Flash 的上线过程长出了一套闭环。工程师定优化目标和系统边界。智能体负责分析并动手改。实验环境负责给出分层而且及时的反馈。反馈还得反过来能验证。原本靠工程师经验串起来的诊断过程,变成了智能体可以持续执行的工程工作流。
三个案例
第一个案例回答的是算得对不对。
智能体在验证 KDA 算子的上下文并行路径时,发现带 CP 和不带 CP 的结果对不上。检查重点因此落到并行执行引入的状态传播和合并计算上。原实现里有一处偷懒。tl.dot 即使收到 FP32 输入,也默认拿 TF32 去算,图的是性能。精度一低,误差就在状态变换合并和状态更新里一层层累积。上下文越长,越明显。
修法是把这两处计算显式指定为 tf32x3。它用三次 TF32 的 Tensor Core 运算拼出更高精度的结果。这样既压住累积误差,又尽量保住性能优势。这个修复已经合进上游的 Flash Linear Attention 项目,编号 1180。
第二个案例回答的是为什么跑不快。
工程师给智能体定义了三个测试场景。单独 Prefill,Prefill 加 KV Transfer,单独 Decode。目的是把不同执行阶段和它们的组合隔开。每个场景都定了验收条件。同样的负载下,Prefill 加 KV Transfer 相对单独 Prefill 的差距不该超过 5%。
智能体压测时发现,有些场景的差距超过了 20%。它顺着 KV Transfer 的时间线往里查,看到一个反常的地方。KV Transfer 的 Python 侧执行,始终没有和 DeepEP 的 dispatch 还有 combine 调用区间重叠。
再往下走,问题落在 GIL 上。他们用的 DeepEP v1.2.1 里,intranode_dispatch 和 intranode_combine 都没有显式释放 Python 的 GIL。dispatch 在需要拿接收 token 数量时,还会在 CPU 上等 GPU 回传。
进到 C++ 并不等于锁自动放开。持锁的这段时间里,负责 Mooncake 传输的 Python 线程拿不到 GIL。传输任务的调度和提交被推迟,KV Transfer 和后续计算也就重叠不起来了。底层传输就算有异步能力,上层提交卡住,并行还是发生不了。
源码里其实留了一处现成的对照。同版本的 internode_dispatch 显式释放了 GIL。注释写得很直白,就是为了避免 CPU 等待期间阻塞其他线程里的 KV Transfer。
修完之后,同样的测试条件下,Prefill 加 KV Transfer 和单独 Prefill 的差距缩到了 1% 以内。
第三个案例回答的是怎么跑得更快。
难点在于优化方向从哪来。大量优化经验藏在 SGLang 和 DeepGEMM 这类项目的手写内核里。智谱让智能体从不同代码库的存量内核里学经验,跨语言、跨硬件平台的也一并吸收。再通过增量和消融实验,把它们提炼成带着适用条件和验证证据的优化骨架。
面对新算子,智能体拿这些骨架当起点。它结合性能分析和分层测试,重新确定分块、访存和资源分配策略。验证通过的修改及其适用条件继续回流骨架库。
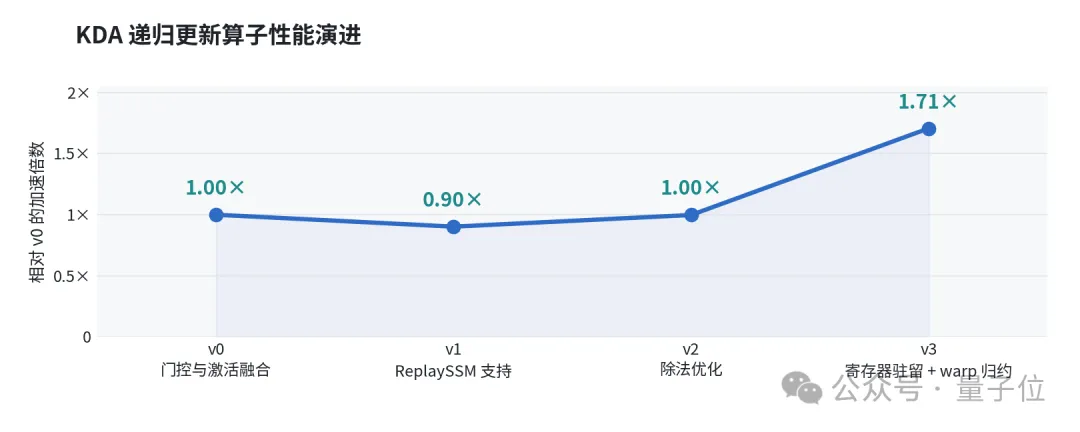
典型的 KDA Decode 算子就这么走了一轮。引入 ReplaySSM 以算换存之后,算子执行时间先涨了一截。智能体做的除法优化把时间缩短了 9.6%。拿到计算是关键瓶颈这条反馈之后,它发现原实现沿 V 维度分块,同一份 FP32 归一化和门控计算被重复做了四次。把这些分块合到同一个线程块,提前批量算好并共享中间结果。牺牲一点并行度换掉重复计算,最后拿到 1.71 倍的提升。
这条线还是人在守
三个案例走下来,工程师的活并没有消失,只是换了位置。定优化目标和系统约束,搭出智能体能直接用的反馈环境,还要审核那些涉及系统架构、异步并发和线上风险的关键修改。这些事仍然由人负责。
智谱自己说得很清楚,他们还没有实现 RSI。选目标,划边界,判断风险,仍然是人的工作。而且在相当长的时间里,他们认为这条线应该由人来守。
把时间线拉长一点看,这事也不是突然发生的。2025 年 10 月,智谱启动安全能力增强研究。最初的判断很朴素,能读懂复杂代码的模型,理应也能看懂代码里的漏洞。不到一年,安全伙伴用 GLM 在真实代码库里发现了数千个漏洞。他们不得不为此设计一套受信访问计划。
唐杰在分享里提到,GLM-4.7 之前,内部用 GLM 写代码多少带着被迫的成分,毕竟是自己的“亲儿子”。那时候编程场景的产品市场契合点还没到。在 AI编程 这件事上,GLM-5.3 已经是每个人每天离不开的伙伴。
再往前一点看,成绩也许更有说服力。GLM-5.3-Flash 以匿名模型 Ox-Alpha 的身份,在 OpenCode 和 OpenRouter 上接受真实调用检验。上线一周成为两个平台调用量最大的模型,6 天 token 调用量超过 62 万亿。

这套系统堆了一批激进的内存优化。以算力换带宽、以通信换显存,还叠加了节点内张量并行和 ReplaySSM。另外加了 W8A8 量化和混合精度缓存量化,也用上了 Layer Split。再引入 Encode-Prefill-Decode 分离式架构,端到端性能提升约 3 倍。硬件利用效率和单条成本追平了主流英伟达 GPU。
不过技术清单的堆叠不是重点。真正值得盯住的是那个闭环。模型优化系统,被优化过的系统再承载下一代模型。两周,三倍,十万卡,这些数字只是它的副产品。
对平时用 AI工具 的人来说,这篇分享给的东西不太一样。训练过程本身摆到了台面上,而不是只给一个训练完的结论。