做智能体的人,多半在挑外壳这件事上犹豫过。
同一个模型,换一套外壳,工具调用会变,上下文管理会变,出错后的恢复也会变。
最后跑出来的结果,可能差出一大截。
差得还不小。
换一套就变。
很多 AI工具 好不好用,差距其实就出在这一层外壳上。
一套外壳在某类任务上很能打,换一类任务,就未必还是最优解。
这很常见。
那到底该怎么挑。
有没有一套放哪儿都稳的通用外壳。
模型厂商自己配的外壳,是不是一定更懂自家模型。
新加坡一个研究团队最近交了一份报告,专门回答这几个问题。
他们把四套能自由换模型的外壳拉进同一场测试,又加了两组原厂搭配做参照。
一共跑出六十六项结果。
报告标题页截图,图上印着报告名和两位作者的名字。
测试的设计很直白,先把变量拆开,再一一对上。
四套外壳分别是 OpenHands,DSH,PI 和 openJiuwen。
模型这边有五个,覆盖国外的旗舰、国产的长上下文模型和通用模型。
交叉起来,同一个模型换不同外壳的表现就能直接对比。
同一套外壳面对不同模型稳不稳,也看得清楚。
两组原厂搭配只接自家模型,没有参与完整交叉。
它们的作用,是当一把尺子。
放一起比,才看得出搭配的差别。
一、他们把四套外壳拉进了同一场考试
先看外壳这一侧。
第一套走开源路线,功能全,社区活跃。
第二套来自模型厂商,配置精简。
第三套讲究轻量,接口简单。
第四套出自开源社区,偏工程化。
四套都能自由换模型,这是入选的前提。
再看任务这一侧。
任务分了三类,定位各不相同。
一类考通用终端操作,接近日常的系统操作。
一类聚焦专业工作流,步骤多,链路长。
一类是最难的命令行任务,容错空间小。
三类题各有侧重。
计分口径也做了统一。
三个任务集的题量不同,所以没有合成一个总分,而是分开比。
题量并不一样。
允许部分得分的按完成比例给分,另一个只算通过或不通过。
中途因基础设施中断的任务会重跑,每个任务只算最后一次。
拿不到有效结果的,直接记零分。
四套外壳加五个模型,再配上三个任务集,交叉出六十项。
再加上两组原生搭配的六项,一共六十六项。
这些结果没有被压成一个总分,而是按任务集分开摆在报告里。

表 1,三个任务集和它们各自的评测方式。
二、同一批任务,最优搭配一直在换
六十六项结果摆出来,冒出一个看着矛盾的现象。
一方面,换一套外壳,模型的名次就可能翻过来。
另一方面,个别模型和外壳的组合,又能在多个任务集上一直领先。
先说第一类现象,也就是名次反转。
通用终端这一类里,社区外壳的优势最广。
它接五个模型,全部拿到最高分。
把两组原厂搭配加进来,它还在其中四个模型上领先。
不过领先的幅度差得很远。
有的只是小幅压过开源外壳,有的则大幅甩开极简外壳。
差别很明显。
这种不一致本身就有信息量。
值得留意。
它说明这套外壳并不是靠某个通用招数占了上风。
它的优势跟具体是哪个模型、哪一类任务绑在一起。

图 1,通用终端任务集的完整结果。
换到专业工作流这一类,优势开始分化。
最高分来自哪套外壳,一个模型一个样。
有一家的旗舰,靠自家外壳拿到最高分。
另一家的新旗舰,更适合极简外壳。
那款国产长上下文模型,依旧和社区外壳配合最好。
另外两款国产模型,最高分反而来自开源外壳。
同一套外壳,在前一类任务上是全能选手,到这里只剩局部优势。
结果不太一样。
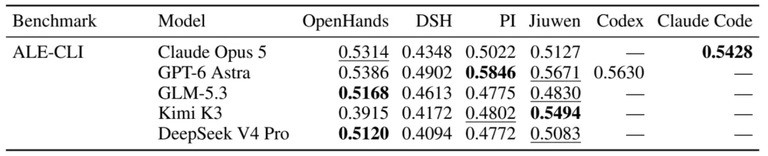
图 2,专业工作流任务集里 99 项本地任务的分数。
最难的那一类,适配差异更明显。
开源外壳最适合某家旗舰,极简外壳最适合另一家的新旗舰。
厂商自研外壳在自己那一款和另一款国产模型上领先。
社区外壳继续替国产长上下文模型拿到最高分。
三张表合起来看,不是一份简单的排行榜。
更值得盯的,是条件一变,原来的领先关系还能不能保住。

图 3,高难命令行任务集里 63 项任务的结果。
先看一个典型的排名反转。
在最难的那一类里,某家旗舰用开源外壳完成了 36 项任务。
另一家的新旗舰完成了 31 项,前者领先 7.94 分。
可换成极简外壳,前者只完成 19 项,后者完成了 38 项。
后者反过来领先 30.16 分。
换一套外壳,两个模型一个下滑一个上涨,方向完全相反。
这不是普通的此消彼长。
这说明,在一套外壳里看到的优势,不能直接搬到另一套外壳上。
这点很关键。
模型排名描述的,其实不只是模型本身。
它还裹着模型和工具接口之间的配合,和上下文管理、执行流程的适配关系。
换个角度看,模型分数里有一部分其实属于外壳。
这条规律放到 AI编程 场景里同样成立。

图 4,高难命令行任务集上两个模型的表现对比。
再看第二种现象,也就是最优外壳随任务漂移。
就算模型不变,它在不同任务上的最优外壳也可能换人。
五个模型里,有四个的最优外壳跟着任务集变了。
两款国产模型的变化最明显。
在三个任务集上,它们的最优外壳分别落在三套不同的外壳上。
另一家的新旗舰,在一类任务上靠社区外壳拿最高分,在另外两类上则更适合极简外壳。
某家旗舰在一类和二类上靠自家外壳,到了最难那一类,开源外壳更好。
唯一的例外是那款国产长上下文模型。
它和社区外壳的组合,在三个任务集上都拿到该模型的最高分。
领先幅度分别是 5.61 分,6.91 分和 11.11 分。
这种稳定不是偶然。
后面还会专门拆一遍。
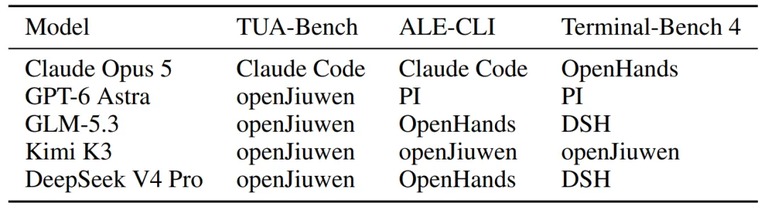
图 5,五个模型在三个任务集上各自的最优外壳。
三、原厂外壳未必最好,贵也未必更好
很多人默认,厂商自己配的外壳更懂自家模型。
实验结果并没有支持这个假设。
某家旗舰的自家外壳,在一类和二类上确实拿到最高分。
到了最难那一类,它却落后于开源外壳。
另一家的原厂搭配更直接。
三个任务集上的得分,都低于社区外壳和极简外壳的同模型组合。
这说明,原厂外壳不一定是自家模型的最佳搭配。
同一个模型接上别家外壳,在某些任务上反而更好。
所以选型时不能只看是不是原厂适配。
任务完成度要一起比,运行成本也要一起看。
尤其是要换模型,要接更多工具,要覆盖多类任务。
这种时候,外壳的可扩展能力同样是硬指标。
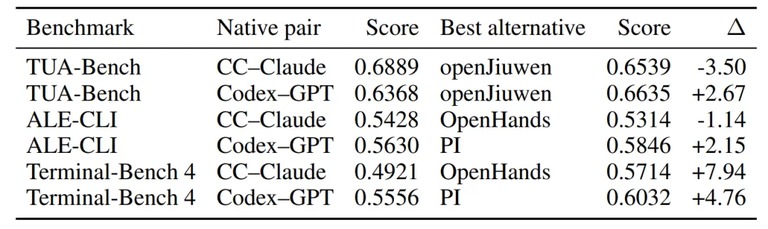
图 6,原生搭配与同模型最高分外壳的比较。
再算一笔成本的账。
外壳影响的不只是得分,还会改掉模型调用次数、词元消耗和整体开销。
报告按统一价格算接口成本,结论有点反直觉。
投入更多,并不能稳定换回更好的表现。
还是最难那一类,拿另一家的新旗舰做例子。
极简外壳的总成本约 293.30 美元,得分 60.32%。
厂商自研外壳的总成本到了 1,256.48 美元。
是前者的约 4.3 倍。
得分却只有 52.38%。
多花的钱,没买到更高的分。
成本差主要来自外壳组织调用和上下文的方式。
开销低,通常意味着调用次数更少、未命中缓存的输入更少。
但它不一定代表模型输出更少。
不同外壳的上下文复用能力也差得很远。
社区外壳有 94% 到 99% 的输入词元来自缓存。
其他外壳只有 49% 到 77%。
这个差距直接体现在账单上。
账要算全。
所以评估一套外壳,不能只看得分和模型单价。
调用次数和未缓存输入,缓存利用率和任务完成度,都要放进同一张账里算。

图 7,不同模型与外壳组合的得分和单任务成本对比。
四、差别藏在反馈与超时里
分数只能说明结果,解释不了差异从哪来。
报告进一步翻了配对轨迹,也就是任务和模型都相同、只有外壳不同的两组执行记录。
它重点看一件事,模型收到失败信号之后怎么应对。
研究挑了十组配对,覆盖五个模型和 192 个失败事件。
另外补了 6 组国产长上下文模型的轨迹做对照。
192 个事件里,有 180 个应对动作是模型主动发起的。
最常见的是诊断和定点修复,一共出现 133 次,其中 116 次成功。
真正决定结果的,往往不是模型会不会修。
而是外壳能不能把失败,变成模型用得上的一条反馈。
差别就在这里。
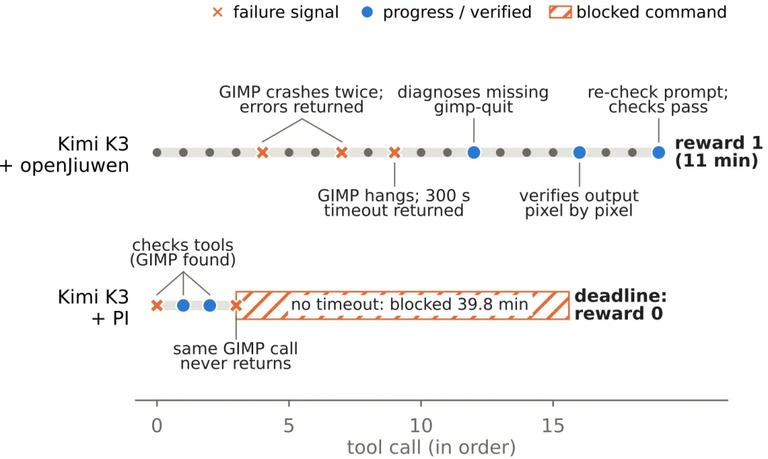
图 8,那款国产长上下文模型在一个改文本框任务上的两条执行轨迹。
有一个案例特别典型。
同一个任务,那款国产长上下文模型在两套外壳下犯了同样的错。
它通过管道跑一个图像脚本时漏了退出指令,命令就一直等输入。
区别在后面。
在极简外壳下,命令行默认不设超时,模型也没有主动设。
命令于是长期挂起,快 40 分钟后任务到了截止时间,最终文件没生成,得零分。
在社区外壳下,前两次调用失败后,错误信息被回传给了模型。
第三次挂起时,命令行在 300 秒后返回超时。
模型据此发现脚本缺了退出指令,又确认图片已经生成。
接着它核对了画布尺寸、背景色和文字位置。
整个任务用了 11 分钟,得分 1。
这条差别很直观。
这个案例说明的不是哪套外壳绝对更强。
它说明的是,失败能不能以有效反馈回到模型手里,直接影响模型有没有机会自救。
默认超时也不是社区外壳独有,开源外壳和厂商自研外壳同样会限制命令时长。
适配度还和模型的习惯有关。
同一套设计放到不同模型上,效果可能完全不同。
别急着下结论。
另一家的新旗舰在极简外壳下,超过一半的命令行调用会主动设超时。
所以极简外壳没有默认超时,对它影响很小。
它靠这套外壳,在两类任务上拿到了该模型的最高分。
外壳该介入多少,不能按模型强弱一刀切。
模型自己能处理好的环节,少插手可能更合适。
模型容易漏的环节,才需要外壳补位。
分寸要看模型。
最后看那款国产长上下文模型为什么能一直稳。
它在三个任务集上都由社区外壳拿到最高分,是唯一的例外。
逐任务比较后可以看到,这种优势不是靠少数几道题撑起来的。
在三个任务集上,社区外壳得分更高的任务分别是 22 个,25 个和 8 个。
就算把领先幅度最大的三道题去掉。
平均仍然领先 3.11 分,3.88 分和 6.35 分。
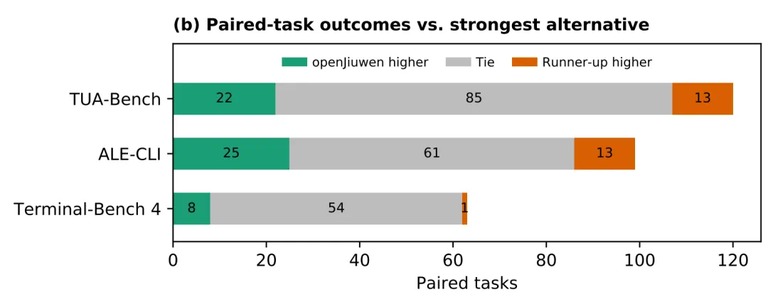
图 9,社区外壳与各任务集次优配置的逐任务比较。
轨迹分析给出了三个可能的原因。
一是工具接口。
在开源外壳里,这款模型多次发出缺少必要参数的编辑调用,重复失败后会触发终止。
这类终止一共发生 55 次,其中 48 次来自它。
社区外壳把写文件和改文件拆成两个工具,更贴合它的调用方式。
二是命令超时。
社区外壳会在命令长时间无响应时返回超时信息,让挂起状态重新变成模型能处理的反馈。
三是截断续写。
当输出因为长度限制被截断时,社区外壳会保留已有推理,并提示模型接着写。
在分析的 6 组配对里,这个机制在其中 2 组中起了决定性作用。
这三点合在一起,才解释了那种稳定适配。
这篇报告给智能体选型最直接的提醒,是把模型和外壳当成一个整体。
再放到目标任务上去评。
模型定了,就去比较它接不同外壳的表现。
外壳定了,也别直接套用别套外壳下的模型排名。
业务从一类迁到另一类,原来的组合也该重新验一遍。
值得再测一遍。
对要处理多类任务的系统来说,保留模型和外壳的配置空间是有价值的。
但允许选择,和能自动选对,是两回事。
报告里的最佳配置,是结果出来之后比出来的。
它并没有证明系统能在面对新任务时,提前判断该用哪套外壳。
要验证自动选择或者路由策略,还得先在开发集上定好配置。
再到没见过的任务上测,还要和同样在开发集上选出的最佳固定外壳比一比。
真正上线时,延迟、调用成本和工具执行开销,也要和任务完成度一起算。
同样的道理,落到 AI对话 这类产品上,也要看外壳和模型配不配得住。
一句话,评估的单位不该只是一个模型或者一套外壳。
它应该是模型、外壳和任务共同构成的整套配置。
任务一变,模型一升级,外壳一更新,这套关系都值得重测。
比起单看某一侧的排名。
直接拿整套配置在真实负载上跑一遍,更接近落地时要面对的东西。