

企业里的技术手册和设计资料,很少是纯文字。表格和示意图混在文字里,机器读起来容易出错。
读错了,后面交给 AI工具 的活儿就会跑偏。麻烦的是,错在哪一块,影响有多大,过去很难说清。
中山大学和混沌摆实验室牵头,拉上南洋理工大学的研究人员,做了个专门查这件事的框架,叫 ProSA。相关论文被 EMNLP 2026 收录。
它不比谁的解析结果更准。它比的是同一份文档受干扰前后,解析结果变了多少。
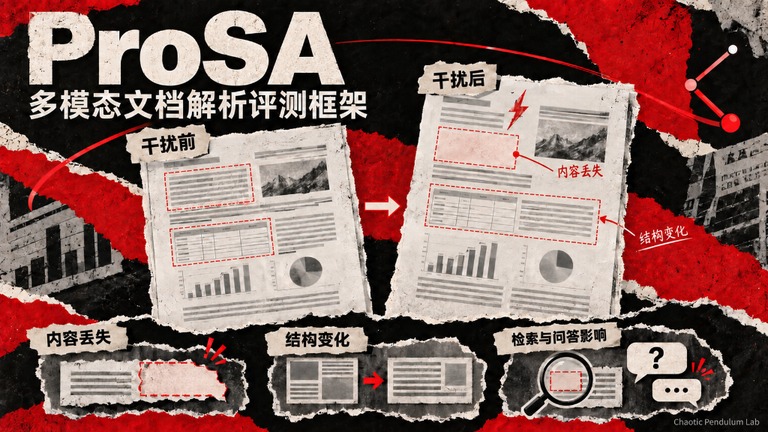
做法很直接。先给同一页文档加上可控干扰,再对比前后两次解析结果。
位置还能不能对上,文字有没有丢,两项一起查。
这套对比不需要动解析器内部代码。换个解析器,方法照用。
先别只看整体错误率
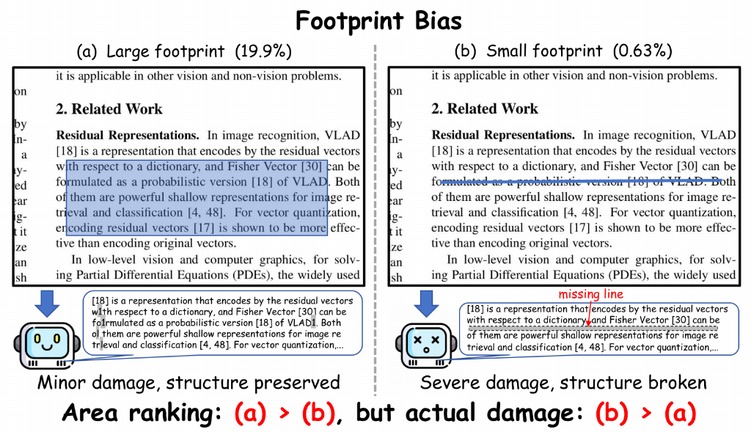
受控实验里出现了反直觉的一幕。大面积擦除之后,主要段落反而保住了。
一处不起眼的细小干扰,却让系统漏掉一整行,还把它前后的文字接在了一起。
拿面积大小判断破坏程度,结论会被带反。
研究团队给它起了个名字。叫面积偏见。
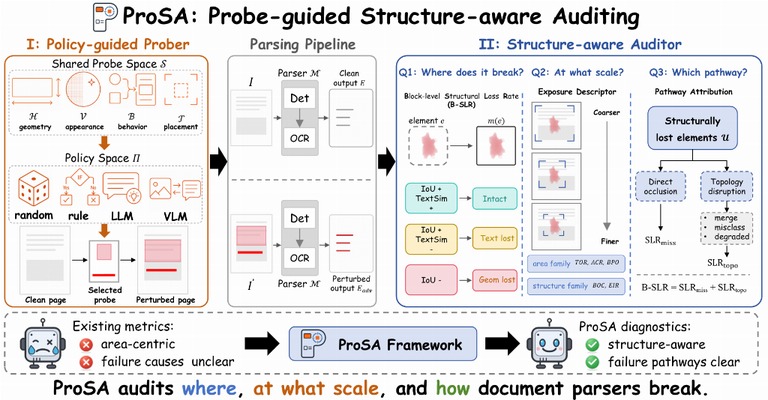
框架接着逐块比对。位置对不上,或者位置上还剩着文本框、里面的字却严重丢失,都算一次结构损失。
这个比例被记成块级结构损失率。
它不给每个内容块补人工标注,也不碰解析器的内部实现。手上有现成的解析器,就能直接对照着测。
这一步很关键。评测门槛降下来了。
页面只改 0.1%,答案就找不到了
结构损失率高不高是一回事。会不会影响问答,是另一回事。
团队拿两套主流解析系统,从 349 页文档里建了 975 个问答对。每道题的标准答案,原本都在无干扰的解析文本里。
测试时只换解析文本。问题和回答设置都不动。
两组干扰盖住的面积几乎一样。普通擦除平均覆盖页面的 0.10%,结构性干扰是 0.11%。对问答的影响却差得很远。
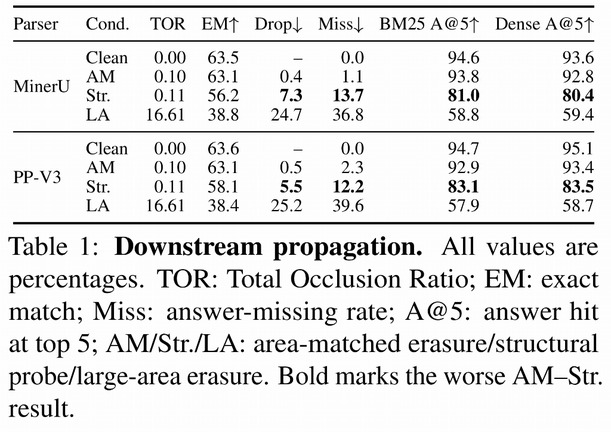
面积只多了 0.01%,读不到标准答案的问题却多了 12% 到 14%。
检索也跟着受影响。在页面内检索时,前五条结果里答案的命中率,从普通擦除下的约 93%,掉到结构性干扰下的 80% 出头到 84%。
换成另外两种回答模型,两组干扰的差距还在。
丢掉的是答案依据,不只是排版。这就麻烦了。
指标管不管用,拿 1000 页文档压一遍
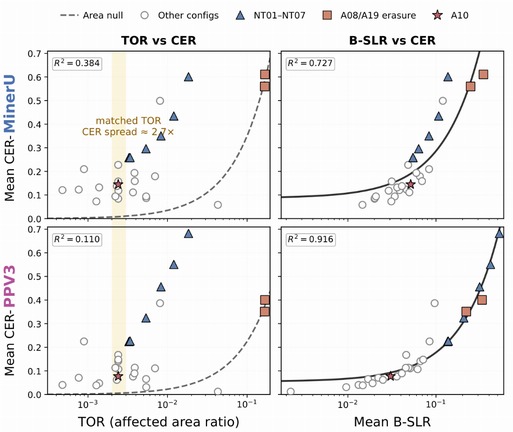
团队从两个公开版面数据集里抽了 1000 页文档,用 29 种固定干扰配置轮着测。
结论是,块级结构损失率比干扰面积更贴近字符错误率的变化。
换成拟合度看,一套解析系统从 0.384 升到 0.727,另一套从 0.110 升到 0.916。拟合度只说明两者走势接近,不代表解析更准了。
团队还调了匹配阈值,又补上噪声和模糊这类干扰。压缩和亮度变化也一并试了。
这个关联依然成立。
只够复核一部分页面,先挑哪些
如果人工复核的预算只够覆盖一部分文档,评测信号还能用来排优先级。
论文在 349 页里按不同指标各挑 35 页,把选中的页面换成无干扰的解析结果,其余页面保持原样。
按结构损失率选页,一套解析系统的问答表现补回了原有降幅的约 64.8%。随机选页只补回约 10.3%。
这个比例说的是损失补回多少。不是最终准确率。
真要修,还得靠人工复核,或者换一套解析器兜底。框架给的是筛选和诊断的依据。
顺序别反。先定位,再动手。
用之前先看清两个前提
这套审计不是拿来就能跑。解析器得输出带页面位置的内容块,原始和受干扰两份结果都要留着。
还有一处盲区。本来就在原始解析里存在的错误,或者两份结果里都有的错误,这种对比发现不了。
论文也没把它说成万能。结构化内容落到企业实际文档上效果如何,还得在更多解析系统里继续验。
这类能力最后多半要落到 AI办公 的场景里。合同、报表和产品手册,都是同一类问题。
所以解析出错这件事,先别只盯着整体错误率。
错在哪一块,才是下一步该修的地方。
