

9 月 18 日,谷歌和 Google DeepMind 联合马里兰大学与弗吉尼亚大学挂出一篇论文。正文里反复出现同一个词。做梦。
论文给的结论很硬。人工智能的递归自我改进,不一定非得从改权重开始。
它的做法是让智能体把走过的每一步存成一棵树。然后在树里做梦,试出更优的探索策略,再回到现实接着干。
效果先摆在前面。算法优化任务上,主流进化搜索系统要跑 51200 代才拿到的水平,这套框架调用 317 次就到了。
这套框架叫 Dream-RSI。
圆填充问题上,它追平了谷歌自家最强的那版进化系统。显卡内核优化上,性能打成平手,生成次数少了 2.43 倍。
底层权重一个字没改。Gemini 3.1 Pro 和 3.7 Flash 都能直接套用。
还有一个更反直觉的结论。人给人工智能指方向,效果反而比完全不指更差。
论文一挂上 arXiv,X 上先炸了。有网友直接说,谷歌可能刚刚破解了递归自我改进。
论文一作是马里兰大学二年级博士生。今年夏天,他以学生研究员的身份进了谷歌。
他背后站着 17 人的作者团,里面有 DeepMind 的研究员,也有讲席教授。
历史就是它做梦的世界
要理解这套机制,得先看进化搜索卡在哪。
以 AlphaEvolve 为代表的系统早就证明,让编码智能体跑进化搜索,能挖出人类没找到的算法。但它们的探索策略全靠人手写死。
哪个分支多给算力,哪个分支早点剪掉,什么时候开并行,都是工程师提前定好的。搜索空间一大,固定策略就把算力砸进死胡同。它还不长记性。
那让策略自己进化行不行。理论上行。麻烦在评估成本。
评估一段候选代码,跑一次就知道好坏。评估一套探索策略,得让它带着智能体从头跑完几百上千轮,看最后挖出来的东西好不好。
每改一版策略,就要重跑一遍整个发现过程。等几天才出一个分数。没人耗得起。
这套框架的解法是把跑过的过程存下来。评估新策略时不再重跑,直接拿旧过程回放。
具体做法,是把干活和决定怎么干拆成两层。
底层是负责执行的发现智能体,由 Gemini 3.1 Pro 或者 3.7 Flash 驱动。它每次接过一个工作区,读上下文,改出一版新候选代码,交给评估器打分。
顶层是轻量的编排层,里面装着探索策略。这段策略本身就是一段代码,决定每一轮从哪个节点继续,一次开几个并行尝试,什么时候止损。
底层模型不动。自我进化的对象,只有这段策略代码。
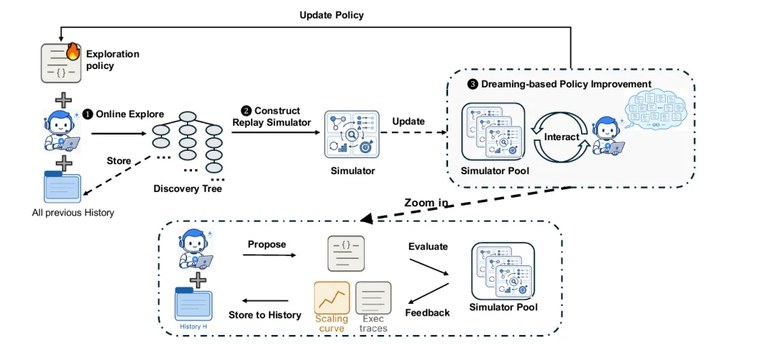
每一次真实探索的结果都会存进一棵发现树。根节点是初始工作区,每个子节点记着一次尝试的完整现场。里面有文件系统快照,有生成的产物,还有评估诊断和得分。
这棵树就是模拟器。
策略要做的决定只有一类,从哪些节点继续,一次开几个。每个节点往下走会得到什么,树里已经记着了。
所以策略要迭代时,不用再去真实环境跑代码。直接在长好的树上重走一遍历史就行。
想试这条路多走两步,就去读树里对应的记录。想试那条路早点放弃,就少读几个节点。
整个评估过程不调用一次模型,不跑一行代码。只读历史。
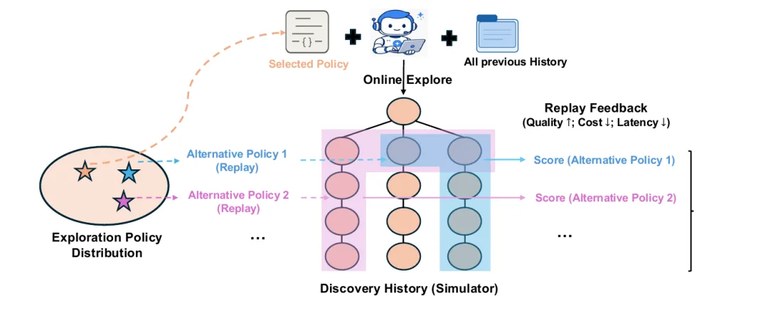
论文把这种机制叫做做梦。就像棋手复盘,不用重新摆盘再下一遍,翻棋谱就够了。
运行闭环分三段。第一步是真实探索,当前策略带着智能体在真实环境里跑,把路径和反馈都记下来,作为一棵新的探索树,追加进历史数据库。
第二步是构建模拟器,把更新后的历史数据库变成一批可重放的回放池。
第三步是基于做梦的策略改进。一个专门的策略开发智能体在模拟器里疯狂做梦,不断改写探索策略的代码,产出上千个候选,再在模拟器上快速重放。
梦里的打分由三项构成。梦里找到的最优分数,尝试次数对应的成本,还有一项并行奖励,鼓励一轮批量跑多个尝试。
得分高的策略,就意味着它多快好省。
负责改策略的是另一个智能体。它盯着三样东西。当前策略在梦里走过的轨迹和分数,前几版修改的反馈,还有整棵发现树。看完直接改写策略的代码。
一轮改出若干版。每一版都丢回梦里打一次分。得分最高的那版,成为下一轮的正式策略。
新策略的下限是原地踏步。上限是无限进化。
那它为什么永远不会变差。因为当前策略本身就在候选池里。只有新写出的策略在模拟器上的综合重放得分更高时,它才会胜出并被部署。
那个得分平衡了三件事。探索质量,算力成本,并行效率。
在数学上,新策略的表现绝不会弱于上一代。新策略被部署回真实世界后,又会带回更深更广的探索树。模拟器跟着一起进化。
智能体与它眼中的世界,就在相互咬合的齿轮里一同长大。
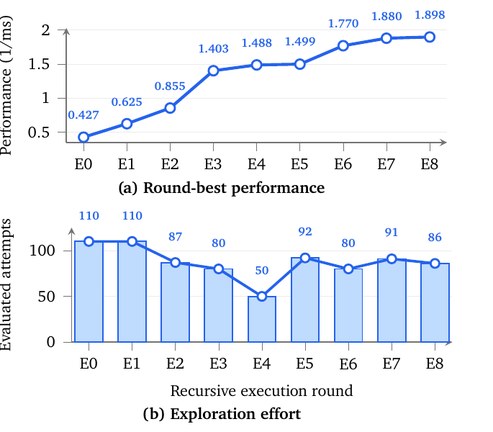
第一版策略很朴素,只会开一堆独立工作区各自埋头跑。到了后面几轮,它学会了精打细算。
在一次内核实验里,性能处在上升期的时候,策略主动把每轮尝试从 110 次砍到 50 次。一旦性能停滞,它又把探索力度拉满,分数随即再涨一截。
没有人教它这么干。这是它从自己的历史里悟出来的。
317 次碾压 5 万代
论文在三个领域做了实测。
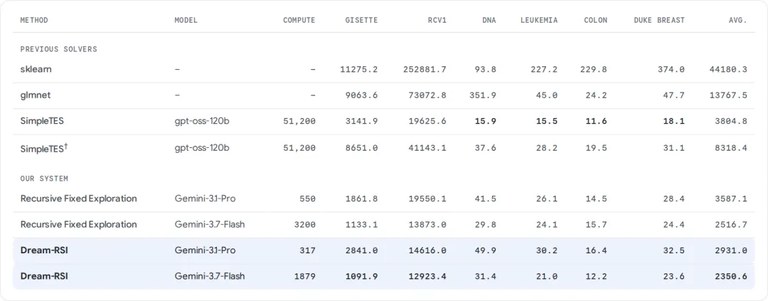
第一个是算法工程,任务是高维统计里的老难题。要求在数值正确的前提下,把整条路径算得尽可能快。
用 Gemini 3.1 Pro 跑这套框架,只调用 317 次,求解器的平均运行时间从 3587.1 毫秒降到 2931.0 毫秒。同一个模型换成固定策略,要调用 550 次才能到同一水平。
作为基线的那套老式进化搜索,为了拿到差不多的结果,一共生成了 51200 次。
换成更便宜的 3.7 Flash 之后,模型消耗 1879 次调用,把运行时间做到了 2350.6 毫秒。
因为进化发生在探索这一层,跟底层模型的大小没关系。小模型一样受益。
第二个是数学优化,差距拉得更开。
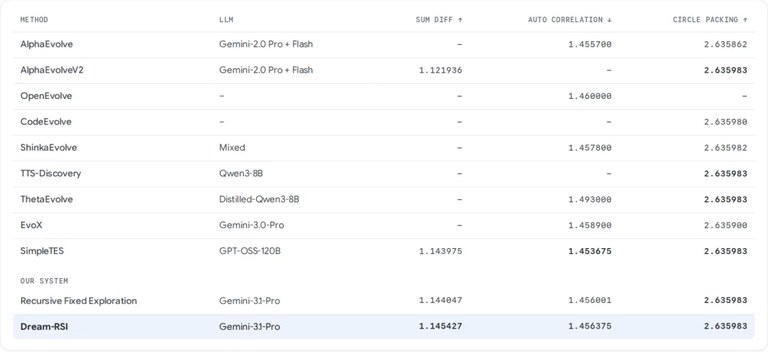
在和差问题、圆装填和自相关不等式三个极耗算力的任务里,它 1000 代以内就达到甚至超越了很强的基线。跟需要 51200 代的基线相比,算力预算省下 50 倍以上。
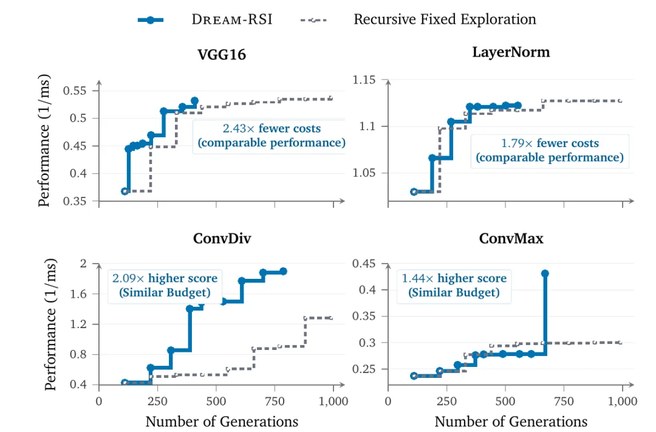
第三个是显卡内核工程,也是谷歌自己最在乎的地盘。论文一共测了四种内核。
VGG16 和 LayerNorm 比的是省多少。把内核优化到和固定探索同样的性能,这套框架需要的生成次数分别只有对方的 1/2.43 和 1/1.79。
ConvDiv 和 ConvMax 比的是强多少。给两边同样的预算,它优化出的内核性能分别是固定探索的 2.09 倍和 1.44 倍。
直接给 AI 总结经验,反而更差
论文里还有一个非常反直觉的实验。
研究人员试了经验总结法,让大模型把历史总结成高层的指导意见,去指导下一轮探索。
结果出来,注入了高层经验总结的智能体,探索表现不但没有提升,反而明显差于完全没有指导的原始基线。
原因不难理解。一旦把经验生硬地抽象成高层原则,它们立刻会变成认知偏见。这些原则过度约束了搜索空间,把探索的多样性掐掉,让模型困在局部最优解里。
所以想让 AI 真正跑起来,宁可靠历史数据喂它,也别急着替它定规矩。
反过来,这套做梦机制不提供任何空洞的真理。它让新策略直接去碰撞具体的历史树,在并行的控制上,在分支的优先级上,在提早停止的规则上,做代码级优化。
探索空间的开放性被保住,效果自然更好。
一作是暑期实习生
一作叫郑童,2021 年本科毕业于东北大学。本科期间他就在国内最硬的机器翻译组做研究。2024 年他进入马里兰大学读博,导师是黄恒教授。
这套框架,正是他 2026 年夏天在谷歌做学生研究员时的产物。
他从一次出多个草稿的投机解码,一路做到用强化学习教模型并行思考。死磕的始终是同一件事。别让模型一条路走到黑。
导师黄恒是马里兰大学首任讲席教授,手里有约 300 篇顶会论文。作者团里还有推荐系统圈都认识的那位论文作者。
一个暑期实习生挂一作,身后一群资深研究员署名。谷歌内部对这条路线有多重视,不用多说。
通往智能爆炸的通道
此前,谷歌产品负责人透露过一个消息。谷歌正在死盯前沿,而且已经看到了递归自我改进的早期迹象。
他给的证据是模型版本大约每三到四周一更。他还说,下一代最大最野心勃勃的预训练模型,会用来回到争霸位置。
他强调要把算力和人力投给三件事。写代码,做研究,做科学。这些最可能让下一轮训练变得更快更便宜。
为什么谷歌这么坚信。因为人工智能自我改进的范式正在变。
过去十年,行业里谈起递归自我改进,想到的总是人工智能自动改自己的权重,训出下一代神明。
但这篇论文展示了另一种可能。权重不一定要先变。它可以通过重写外围的那一层,让自己变强。
模型有了这种能力,就会用最便宜的算力,去解决最难的问题。
对多数公司来说,他们不关心底层怎么调度,只关心手上的 AI工具能不能把活干完。这类自我改进的能力,最先落地的场景大概还是 AI编程。
论文结尾那句话说得清楚。智能体必须学会做梦才能递归自我改进,而历史,就是它做梦时所处的整个世界。
参考资料:https://dream-rsi.com/
